
 Zgłoś materiał
 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Русский
 Powrót do laboratorium
JEVLAB / FIELD GUIDE
Praktyczny przewodnik po Jev
Zrozum model, podejmij swoją pierwszą decyzję, a następnie odkryj, co budują inni.
Wybierz swój punkt startowy
Jeden pomysł, jedna działająca decyzja, a następnie mierzalny przepływ pracy. Zacznij tam, gdzie jesteś.
Zrozum Jev
Zobacz, co jest danymi wejściowymi, co wyjściowymi i kiedy model językowy jest nadal właściwym narzędziem.
02Zbuduj jedną małą decyzję
Ukształtuj zapytanie w Decision Lab, a następnie przenieś je na własny serwer lub do oficjalnego Playground.
03Uczyń to niezawodnym
Poznaj niepewność, typowe tryby awarii i krótką listę kontrolną dla swojej pierwszej ewaluacji.
Czytaj, eksperymentuj i przechowuj swoją listę kontrolną tutaj bez konta.
01 / Małe decyzje wewnątrz Twojego oprogramowania
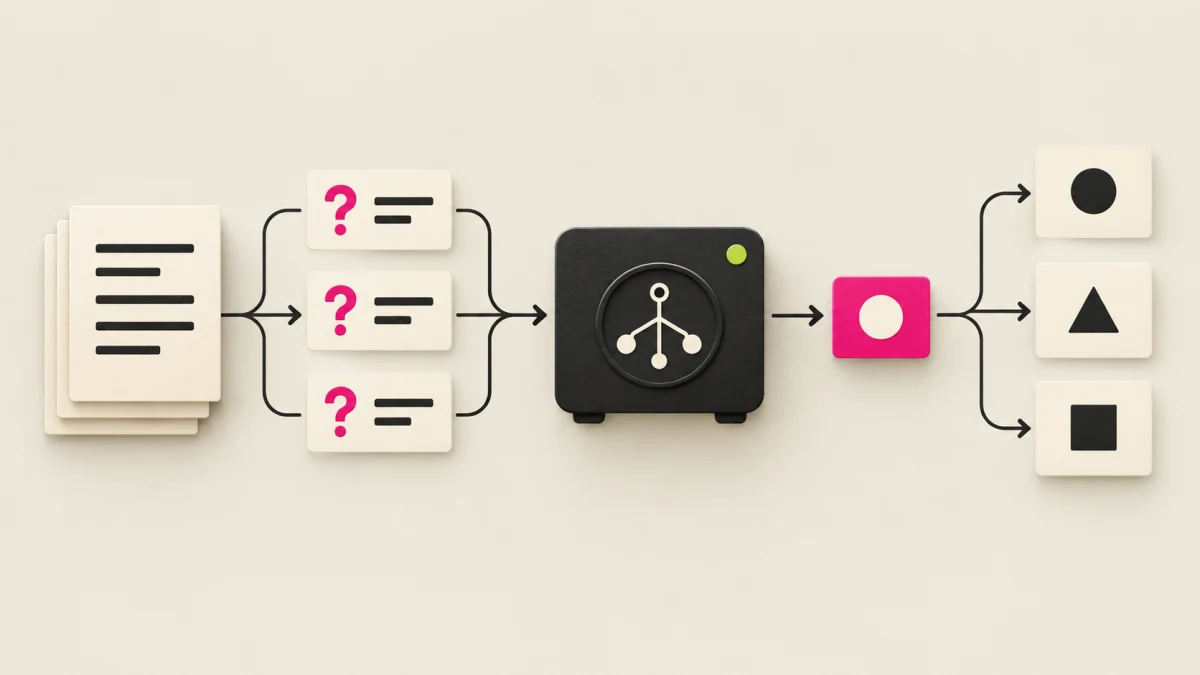
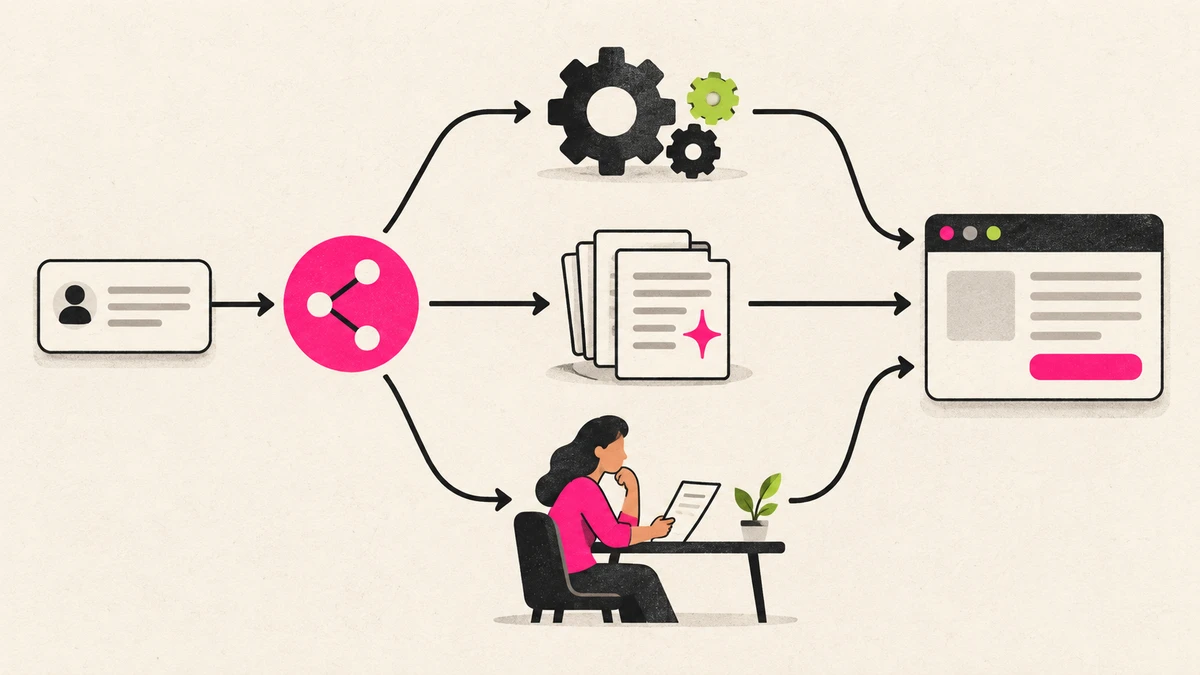
Pomyśl o skrzynce odbiorczej wsparcia technicznego. Twoje oprogramowanie zna dostępne zespoły, ale musi zrozumieć wiadomość klienta. Jev może wybrać zespół, ocenić pilność lub ocenić wiadomość według zdefiniowanej przez Ciebie skali. Twój kod następnie stosuje reguły routingu. Model dostarcza ocenę; nie wykonuje akcji.
Jev obecnie akceptuje tekst, w tym JSON i tablice tekstowe. Nie widzi obrazów, nie słucha dźwięku, nie generuje prozy ani nie pisze kodu. Demo oparte na obrazach wymaga najpierw innego komponentu, aby przekształcić obraz w użyteczny tekst lub ustrukturyzowane obserwacje.
02 / Dlaczego warto budować inny rodzaj modelu?
Celem TYPESAFE jest sprawienie, by wąskie oceny AI zachowywały się jak użyteczne komponenty w zwykłym oprogramowaniu. Podejście treningowe RLCD koncentruje się na decyzjach i skalibrowanej niepewności. Rezygnacja z generowania dowolnego tekstu umożliwia stworzenie innego interfejsu: aplikacja definiuje przestrzeń odpowiedzi i łączy wyniki.
Prawidłowy kształt wyjścia nie jest dowodem na to, że odpowiedź jest prawdziwa. Oceniaj błędy na własnych przykładach i utrzymuj działania o dużym znaczeniu za wyraźnymi regułami aplikacji.
03 / Trzy sposoby zadawania pytań
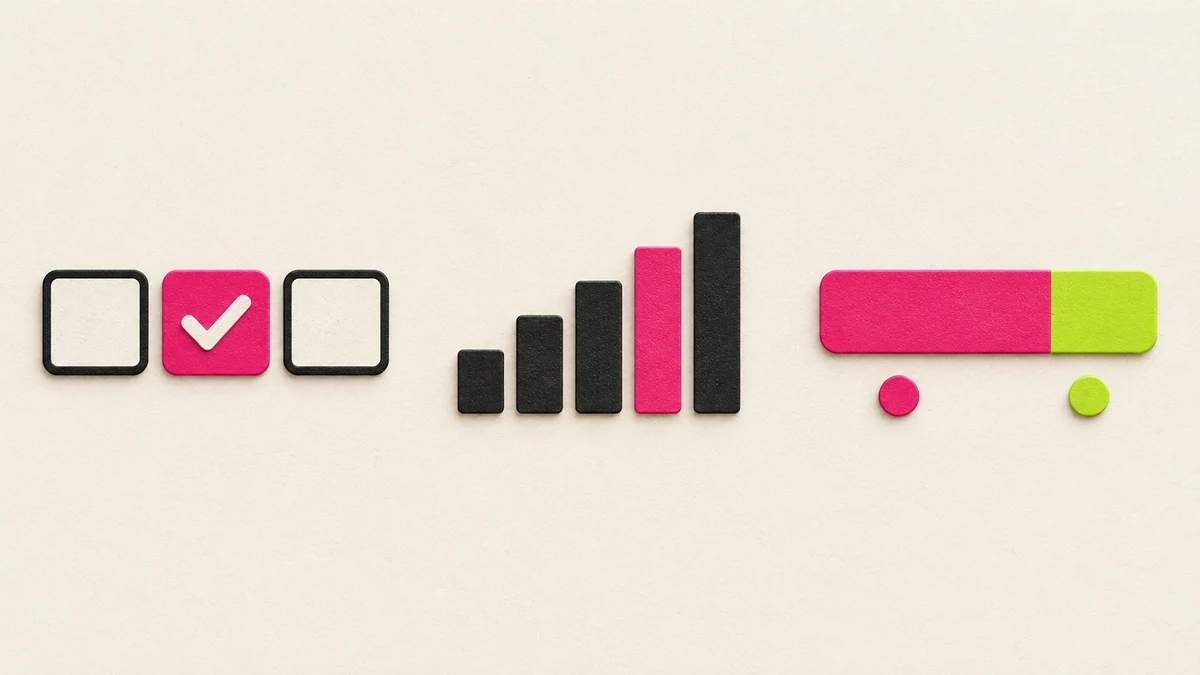
- Choice
- Wybierz jedną opcję z zestawu, który dostarczasz, np. rozliczenia, wsparcie techniczne lub sprzedaż. Odpowiedź zawiera wybraną opcję oraz rozkład prawdopodobieństwa dla dostępnych opcji.
- Score
- Umieść obserwację na uporządkowanych, opisowych poziomach, takich jak: spokojny, sfrustrowany i bardzo sfrustrowany. Zwrócony wynik może znajdować się pomiędzy poziomami; nie jest to ogólne prawdopodobieństwo poprawności.
- Noul
- Zapytaj, czy stwierdzenie jest prawdziwe. Noul zwraca prawdopodobieństwo „tak”, od 0 do 1. Zadawaj osobne pytania dla etykiet, które mogą być prawdziwe w tym samym czasie.
Odczytaj niepewność przed podjęciem działania
Choice i Score zwracają prawdopodobieństwa oraz oddzielną wartość pewności wynikającą z ich rozkładu. Prawdopodobieństwo i pewność wybranej opcji to różne liczby. Noul posiada prawdopodobieństwo i brak oddzielnego pola pewności.
Przykład edukacyjny · stała pewność 0,72
 Poproś o recenzję lub więcej kontekstu
Przesuń próg, aby zobaczyć zmianę gałęzi kodu. Jest to stała ilustracja, a nie przewidywanie Jev czy zalecany próg. Przetestuj granice w odniesieniu do kosztu błędów; przekroczenie progu nigdy nie daje pozwolenia na działanie.
04 / Jev i LLM wykonują różne zadania
To różnice w interfejsie, a nie twierdzenie, że jeden model wygrywa w każdym zadaniu. Możliwości i opóźnienia LLM różnią się w zależności od modelu, ustawień, narzędzi i danych wejściowych.
| Wymiar | Jev | Generatywny LLM |
|---|---|---|
| Wyjście | Zdefiniowane wybory, wyniki, prawdopodobieństwa | Wygenerowany tekst lub kod; wiele modeli obsługuje również wyjście ustrukturyzowane |
| Użyteczne zastosowanie | Routing, selekcja, sygnały rankingowe, ograniczone sprawdzenia | Pisanie, wyjaśnianie, otwarte rozumowanie i generowanie |
| Wejście | Tekst lub ustrukturyzowany stan tekstowy | Tekst; niektóre modele akceptują również obrazy, dźwięk lub wideo |
| Kto kontroluje akcję? | Twoja aplikacja łączy oceny i wykonuje reguły | Twoja aplikacja nadal musi weryfikować wyjścia i działania narzędzi |
| Niepewność | Wyjścia prawdopodobieństwa zaprojektowane dla skalibrowanych decyzji; nadal zawodne | Pisemne zapewnienie o pewności wymaga weryfikacji specyficznej dla zadania |
05 / Wystarczająco szybki, by być częścią interakcji
Post z premiery TYPESAFE z 15 września podaje ten zakres dla wywołań w formie decyzji. Zauważa również, że opublikowane ewaluacje były zazwyczaj uruchamiane z zachodniego wybrzeża USA. Jest to migawka zgłoszona przez dostawcę, a nie benchmark JEVLAB ani gwarancja opóźnienia dla Twojej lokalizacji.
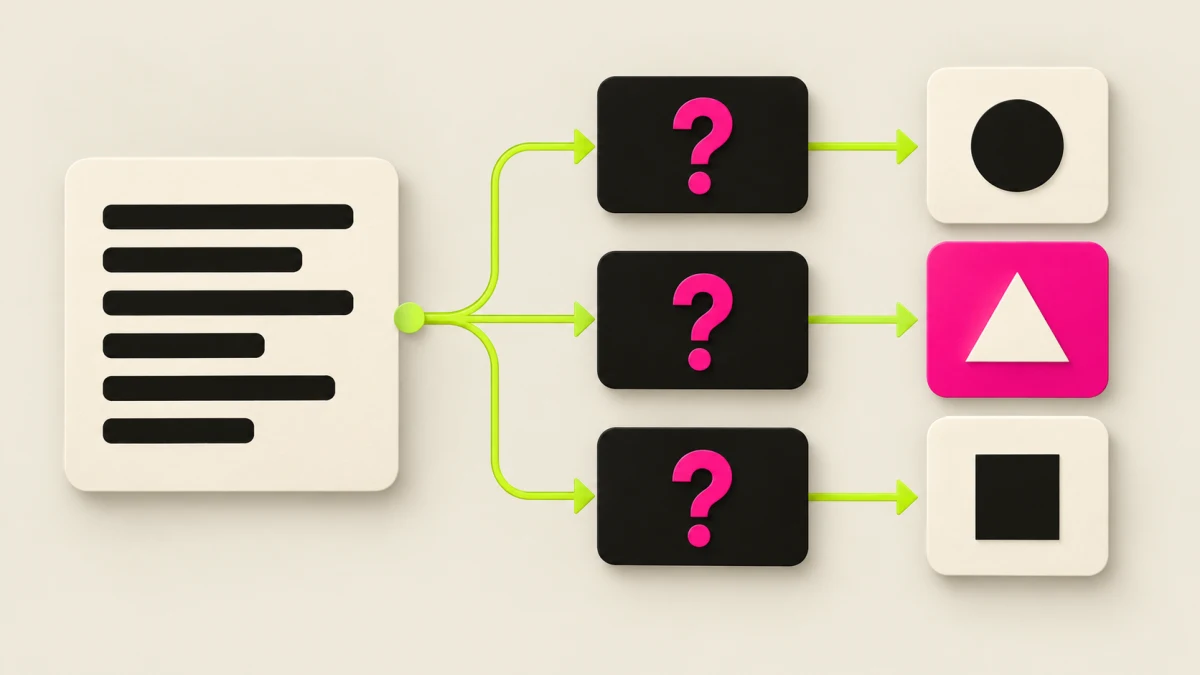
Zadawaj niezależne pytania dotyczące tego samego stanu jednocześnie. Jev ocenia je równolegle. Może to uniknąć łańcucha oddzielnych wywołań, ale więcej pytań nadal zwiększa liczbę tokenów wejściowych i musi mieścić się w limitach żądań. Późniejsze wywołanie jest potrzebne, gdy pytanie zależy od wcześniejszej odpowiedzi.
Ewaluacje przepływu pracy TYPESAFE porównują całe procesy. Ich etykiety referencyjne to etykiety konsensusu wygenerowane przez model, a nie zbiór danych rzeczywistych (ground truth) stworzony przez człowieka. Zapoznaj się z metodą i przetestuj własne przypadki przed przyjęciem twierdzeń o szybkości lub dokładności.
06 / Wykonaj swoje pierwsze wywołanie
- Poznaj przykłady zapytań w naszym Decision Lab bez konieczności logowania. Aby uruchomić rzeczywiste wywołanie modelu, otwórz Playground TypeSafe, zaloguj się tam i zacznij od krótkiego stanu oraz jasnego pytania.
- Utwórz klucz API w konsoli TypeSafe. Przechowuj go na swoim serwerze lub w lokalnej zmiennej środowiskowej, nigdy w kodzie przeglądarki ani w publicznym repozytorium.
- Wywołaj API bezpośrednio lub użyj oficjalnego SDK dla JavaScript lub Python. Poniższy przykład jest żądaniem ilustracyjnym; nie wykonuje żądania z tej strony.
- Zbieraj reprezentatywne przykłady, rejestruj wersję modelu, mierz błędy i opóźnienia end-to-end oraz decyduj, kiedy podjąć działanie lub poprosić o weryfikację. Wynik prawdopodobieństwa lub Score pewności nie jest autoryzacją.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json

{
  "state": {
    "message": "I cannot sign in to my account."
  },
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this message?",
      "criteria": {
        "billing": "Payments or invoices",
        "support": "Account access or technical problems",
        "sales": "Pricing or product questions"
      }
    }
  }
}Decision Lab / Wypróbuj kształt wywołania
Wybierz zadanie i edytuj jego tekst. Zapytanie zmienia się natychmiast w Twojej przeglądarce. Są to oryginalne szablony edukacyjne, a nie wyniki modelu na żywo; nie jest tu wymagany klucz API ani logowanie.
Choice wybiera jedną nazwaną opcję. Opisz każdą opcję wyraźnie i uwzględnij drogę ucieczki dla danych wejściowych, które nie pasują. Twój kod decyduje, co stanie się dalej.
Score używa uporządkowanych, opisowych poziomów. Jego wynik liczbowy opisuje ocenę w tej skali, a nie dokładną liczbę czy uniwersalny wynik jakości.
Noul zwraca prawdopodobieństwo, że jeden warunek jest prawdziwy. Zdefiniuj warunek w pełni w instrukcjach; klucz pytania jest tylko etykietą dla Twojego kodu.
Edytowalne przykłady używają języka angielskiego. Możesz zastąpić stan własnym językiem; przetestuj dokładność w tym języku, zanim polegniesz na wyniku.
{
  "model": "jev-latest",
  "state": "I need help signing in after changing my phone.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Choose the team that can best help with the message in state. Use other when none fits.",
      "criteria": {
        "accounts": "Sign-in or account access",
        "billing": "Charges, invoices or subscriptions",
        "other": "Another issue, or not enough information"
      }
    }
  }
}
Dalej: wyślij tę treść do POST /v1/systemone za pomocą swojego klucza API po stronie serwera. Konsola i API TypeSafe wymagają konta dostawcy. JEVLAB nie zbiera Twojego klucza ani nie wysyła tego przykładu do modelu.
Zanim wdrożysz / Cztery rzeczy do poprawnego wykonania
Wynik typu safe może nadal być błędną odpowiedzią. Buduj w oparciu o udokumentowane limity modelu, a nie w oparciu o idealne demo.
Mały, jawny stan
Wyślij istotne fakty z jasnymi nazwami pól. Najpierw zamień obrazy lub dźwięk na użyteczny tekst. Długi, niepowiązany kontekst i pośrednie odniesienia mogą zmniejszyć dokładność.
Pytania, które mówią to, co oznaczają
Napisz pełny warunek w instrukcjach, a nie tylko w kluczu pytania. Unikaj nakładających się wyborów i sprzecznych kryteriów. Oddziel niezależne oceny; połącz je w kodzie.
Zachowaj dokładną pracę w kodzie
Używaj kodu do arytmetyki, liczenia, porównywania dat i sprawdzania uprawnień. Używaj modelu generatywnego, gdy potrzebujesz nowej prozy lub kodu. Jev wybiera lub ocenia w zdefiniowanej przez Ciebie przestrzeni.
Mierz własny przepływ pracy
Używaj oznaczonych przykładów, w tym przypadków niejednoznacznych, wielojęzycznych i kontradyktoryjnych. Śledź błędne decyzje, wskaźnik fallback, opóźnienie end-to-end i użycie danych wejściowych. Rejestruj zwróconą wersję modelu; aliasy mogą ulec zmianie.
Przeczytaj udokumentowane tryby awarii Jev 1.13
Twoja lista kontrolna pierwszej budowy
Zaznaczone kroki pozostają tylko w tej przeglądarce. Żadne konto, synchronizacja ani śledzenie ukończenia nie są wysyłane do JEVLAB.
Przepisy do rozwoju
- Routing intencji
Wybieraj spośród obsługi, z jawnym fallbackiem dla zapytań spoza ich zakresu.
- Pytania równoległe
Zadawaj niezależne pytania o ten sam stan jednocześnie; obsługuj zależności w późniejszym kroku.
- Punktacja złożona
Oceniaj oddzielne wymiary, a następnie łącz ich wartości za pomocą wag, które kontrolujesz w kodzie.
- Routing pewności
Wybierz, czy kontynuować, zebrać więcej kontekstu czy poprosić o recenzję, używając przetestowanych progów.
07 / Twoja półka startowa
Trzymaj te odniesienia blisko. Oficjalna dokumentacja definiuje API; projekty społecznościowe pokazują możliwe zastosowania, a nie gwarancje.
 Szybki start
- Wprowadzenie modeli System One i Jev
- Manifest TypeSafe
- Zrozumienie Score pewności
- Modele, aktualne ceny i limity
- Ewaluacje przepływu pracy i metodologia
Z kolekcji JEVLAB
- typesafe-sdk-cpppewriebontal
- go-jevmattn
- jev-cookbookparamjeetn
- typesafe-sdk-rustzchee
- system-oneasynq-io
- jev-netbrightshore
Poznaj biblioteki źródłowe
- Made with Jev
Wyjaśnienia i praktyczne budowy, z przewodnikiem po dzieleniu generowania, decyzji i wykonania.
- Jevable
Wizualny strumień demonstracji społeczności. Obejrzyj oryginał i sprawdź, co każda demonstracja faktycznie wysyła do Jev.
- Awesome Jev
Szeroki indeks, który oddziela oficjalne zasoby, SDK społeczności i kategorie projektów. Sprawdź oryginalne repozytorium przed przyjęciem narzędzia.
Są to niezależne źródła odkryć. Uwzględnienie w katalogu nie jest audytem ani poparciem ze strony JEVLAB.
Pytania warte zadania
Czy Jev to chatbot czy agent kodujący?
Jev to model decyzyjny, który może wywoływać oprogramowanie. Agent kodujący może pomóc Ci zbudować to oprogramowanie, a model językowy może pisać w nim tekst. To różne role.
Czy Jev widzi wideo lub zrzut ekranu?
Udokumentowane API obecnie przyjmuje tekst. Demo może używać oddzielnego modelu wizyjnego, transkrypcji, DOM lub stanu gry, aby przygotować tekst, który ocenia Jev. Sprawdź cały ten potok podczas porównywania szybkości i kosztów.
Czy mogę zacząć bez konta?
Wszystko w tym przewodniku JEVLAB i Decision Lab jest dostępne bez logowania. Rzeczywiste wywołania API i oficjalny Playground TypeSafe wymagają dostępu do TypeSafe i klucza, jeśli dotyczy.
Czy szybki benchmark oznacza, że moja aplikacja będzie szybka?
Mierz od danych wejściowych do wyniku, który widzi Twój użytkownik. Sieć, wstępne przetwarzanie, wykonywanie narzędzi, ponowne próby i fallbacki również zajmują czas. Opublikowane ewaluacje dostawców i dema twórców opisują ich własne konfiguracje.
08 / Jak korzystać z JEVLAB
JEVLAB to niezależny przewodnik terenowy z linkami do źródeł. Nie jest obsługiwany przez TYPESAFE AI ani z nią powiązany. Strona główna służy do odkrywania prac; ten przewodnik służy do ich zrozumienia.
Przeglądaj laboratorium, aby otworzyć kolekcję. Szukaj według projektu, twórcy lub tematu i zawężaj wyniki za pomocą filtrów zastosowań i platform. Pasek boczny na komputerze przewija się niezależnie. Popular losowo układa pasujące materiały przy każdej nowej wizycie; Latest pokazuje najpierw najnowsze materiały. W obu trybach poszczególne karty wspierających są losowane z projektów w ich 90-dniowym okresie z dodatnim potwierdzonym saldem netto, proporcjonalnie do tej sumy. Projekty z 0 USD nie są wybierane. Projekt nie jest losowany ponownie, dopóki wszystkie kwalifikujące się projekty nie będą miały swojej kolejki, a następnie rozpoczyna się nowa runda.
Karty GitHub i stron internetowych zaczynają się od podglądu, z wyraźnymi układami tekstu poniżej. Filmy zachowują swoją szerszą prezentację. Gdy źródło udostępnia obsługiwaną publiczną metrykę, ikona oka oznacza wyświetlenia, a gwiazdka oznacza gwiazdki w serwisie GitHub zarejestrowane w momencie gromadzenia danych; żadna z nich nie jest liczbą kliknięć w JEVLAB. Brakujące metryki pozostają puste.
Otwórz kartę, aby zobaczyć notatki źródłowe, oryginalny link i kontrolę zapisu. Tłumaczenia są pomocami w czytaniu; sprawdź oryginał twórcy pod kątem kontekstu, aktualnych instrukcji i deklaracji wydajności.
Wspierający dzielą jedną ogólnoświatową tablicę. Pasek pokazuje pierwszą dziesiątkę, a pasek boczny pierwszą piątkę. Poszczególne karty między zasobami są losowane z każdego projektu w jego 90-dniowym okresie z dodatnim potwierdzonym wsparciem netto, w tym z projektów spoza pierwszej dziesiątki i od darczyńców wpłacających 1 USD, z szansami proporcjonalnymi do potwierdzonego wsparcia netto w bieżącym okresie i bez powtórzeń w rundzie. Otwórz Galerię wspierających, aby zobaczyć aktualną 90-dniową sumę każdego projektu. Wygasłe projekty pozostają na dole z 0 USD i bez miejsc w wyróżnieniach lub szans na wybór; nowe potwierdzone wsparcie dla tego samego adresu URL rozpoczyna nowy okres i nową sumę od zera. Aby wesprzeć, wyszukaj adres URL projektu, skopiuj jego wiadomość i użyj Kontynuuj z Buy Me a Coffee; wklej wiadomość do kasy przed dokonaniem płatności. Wsparcie określa pozycje na tablicy i szanse na wcześniejsze pojawienie się w kanale, a nie jakość redakcyjną. Wyświetlenia nie są gwarantowane.
Live szacuje liczbę ostatnio aktywnych odwiedzających. Total Visits sumuje dzienne wizyty we wszystkich językach; nie jest liczbą unikalnych osób w całej historii witryny. Publiczne wizyty i kliknięcia zewnętrzne obejmują wartości początkowe operatora oraz późniejsze zmierzone zdarzenia.
Źródła sprawdzone 22 września 2026 r. Ilustracje są grafikami objaśniającymi JEVLAB. Tłumaczenia są wspomagane przez AI; oficjalne źródła pozostają autorytatywne w kwestii aktualnych szczegółów API.