
 Enviar descoberta
 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文
 繁體中文
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Voltar ao laboratório
JEVLAB / FIELD GUIDE
Um guia prático para o Jev
Entenda o modelo, experimente sua primeira decisão e descubra o que as pessoas estão construindo.
Escolha seu ponto de partida
Uma ideia, uma decisão funcional, depois um fluxo de trabalho mensurável. Comece de onde você está.
Entenda o Jev
Veja o que ele recebe, o que ele entrega e quando um modelo de linguagem ainda é a ferramenta certa.
02Construa uma pequena decisão
Modele uma solicitação no Decision Lab, depois leve-a para seu próprio servidor ou para o Playground oficial.
03Torne-o confiável
Explore a incerteza, modos de falha comuns e uma lista de verificação curta para sua primeira avaliação.
Leia, experimente e mantenha sua lista de verificação aqui sem uma conta.
01 / Pequenas decisões, dentro do seu software
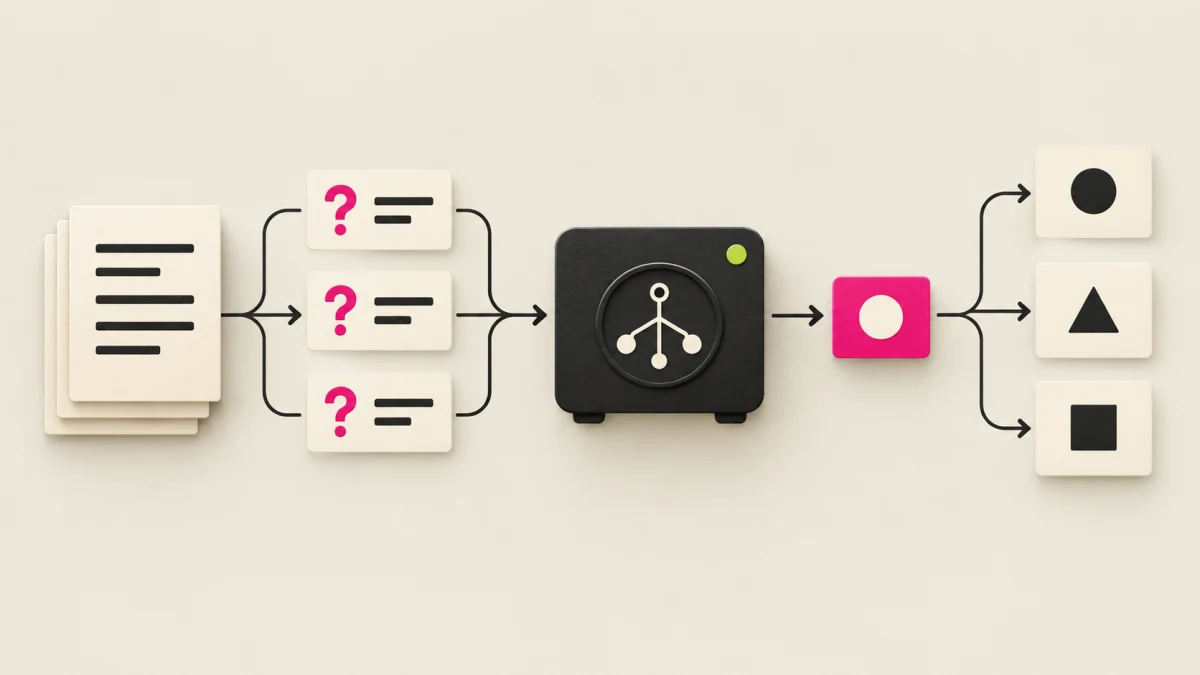
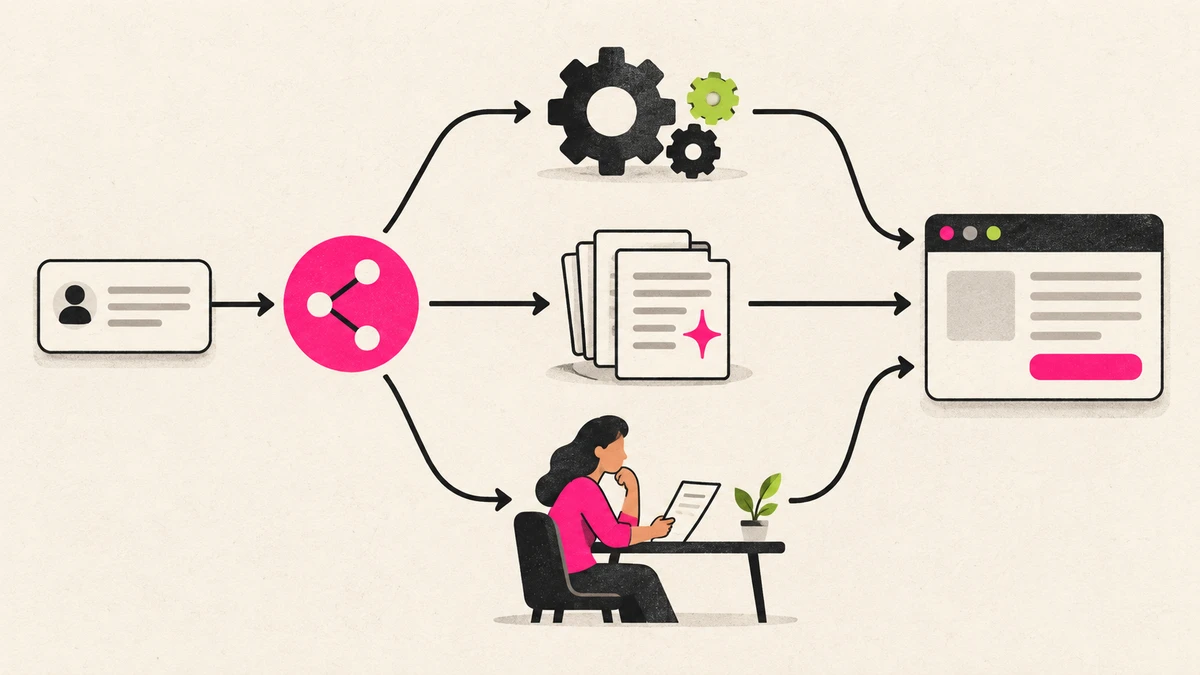
Pense em uma caixa de entrada de suporte. Seu software conhece as equipes disponíveis, mas precisa entender a mensagem de um cliente. O Jev pode selecionar uma equipe, avaliar a urgência ou pontuar a mensagem em uma escala que você definir. Seu código então aplica as regras de roteamento. O modelo fornece um julgamento; ele não executa a ação.
O Jev atualmente aceita texto, incluindo JSON e matrizes de texto. Ele não visualiza imagens, não ouve áudio, não gera prosa e não escreve código. Uma demonstração baseada em imagem precisa primeiro de outro componente para transformar a imagem em texto utilizável ou observações estruturadas.
02 / Por que construir um tipo diferente de modelo?
O objetivo da TYPESAFE é fazer com que julgamentos de IA restritos se comportem como componentes úteis em softwares comuns. Sua abordagem de treinamento RLCD foca em decisões e incerteza calibrada. Abrir mão da geração de texto livre torna possível uma interface diferente: a aplicação define o espaço de resposta e combina os resultados.
Um formato de saída válido não é prova de que a resposta é verdadeira. Avalie erros em seus próprios exemplos e mantenha ações consequentes atrás de regras de aplicação explícitas.
03 / Três formas de perguntar
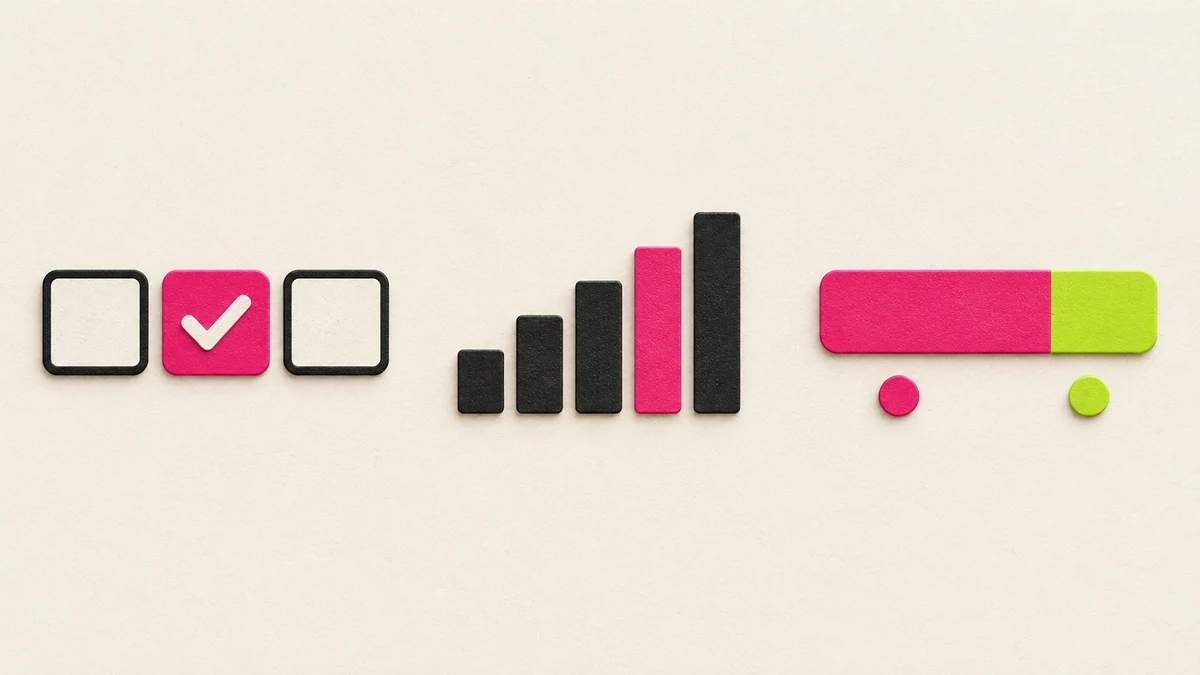
- Choice
- Escolha uma opção de um conjunto que você fornece, como faturamento, suporte técnico ou vendas. A resposta inclui a opção selecionada e uma distribuição entre as opções.
- Score
- Coloque uma observação em níveis ordenados e descritivos, como calmo, frustrado e muito frustrado. A pontuação retornada pode ficar entre os níveis; não é uma probabilidade geral de correção.
- Noul
- Pergunte se uma afirmação é verdadeira. Noul retorna a probabilidade de sim, de 0 a 1. Faça perguntas separadas para rótulos que podem ser verdadeiros ao mesmo tempo.
Leia a incerteza antes de agir
Choice e Score retornam probabilidades e um valor de confiança separado derivado de sua distribuição. A probabilidade e a confiança da opção vencedora são números diferentes. Noul tem uma probabilidade e nenhum campo de confiança separado.
Exemplo de ensino · confiança fixa 0.72
 Pedir revisão ou mais contexto
Mova o limite para ver uma ramificação de código mudar. Esta é uma ilustração fixa, não uma previsão do Jev ou um limite recomendado. Teste os limites contra o custo de erros; passar do limite nunca concede permissão para agir.
04 / Jev e um LLM realizam trabalhos diferentes
Estas são diferenças de interface, não uma alegação de que um modelo vence todas as tarefas. As capacidades e a latência de um LLM variam de acordo com o modelo, configurações, ferramentas e entrada.
| Dimensão | Jev | LLM Generativo |
|---|---|---|
| Saída | Escolhas definidas, pontuações, probabilidades | Texto ou código gerado; muitos modelos também suportam saída estruturada |
| Uso ideal | Roteamento, seleção, sinais de classificação, verificações delimitadas | Escrita, explicação, raciocínio aberto e geração |
| Entrada | Texto ou estado de texto estruturado | Texto; alguns modelos também aceitam imagens, áudio ou vídeo |
| Quem controla a ação? | Sua aplicação combina julgamentos e executa regras | Sua aplicação ainda deve validar saídas e ações de ferramentas |
| Incerteza | Saídas de probabilidade projetadas para decisões calibradas; ainda falíveis | Uma alegação de confiança escrita precisa de validação específica da tarefa |
05 / Rápido o suficiente para integrar a interação
O post de lançamento da TYPESAFE em 15 de setembro relata este intervalo para suas chamadas em formato de decisão. Também observa que suas avaliações publicadas foram geralmente executadas a partir da Costa Oeste dos EUA. Este é um instantâneo relatado pelo fornecedor, não um benchmark do JEVLAB ou uma garantia de latência para sua localização.
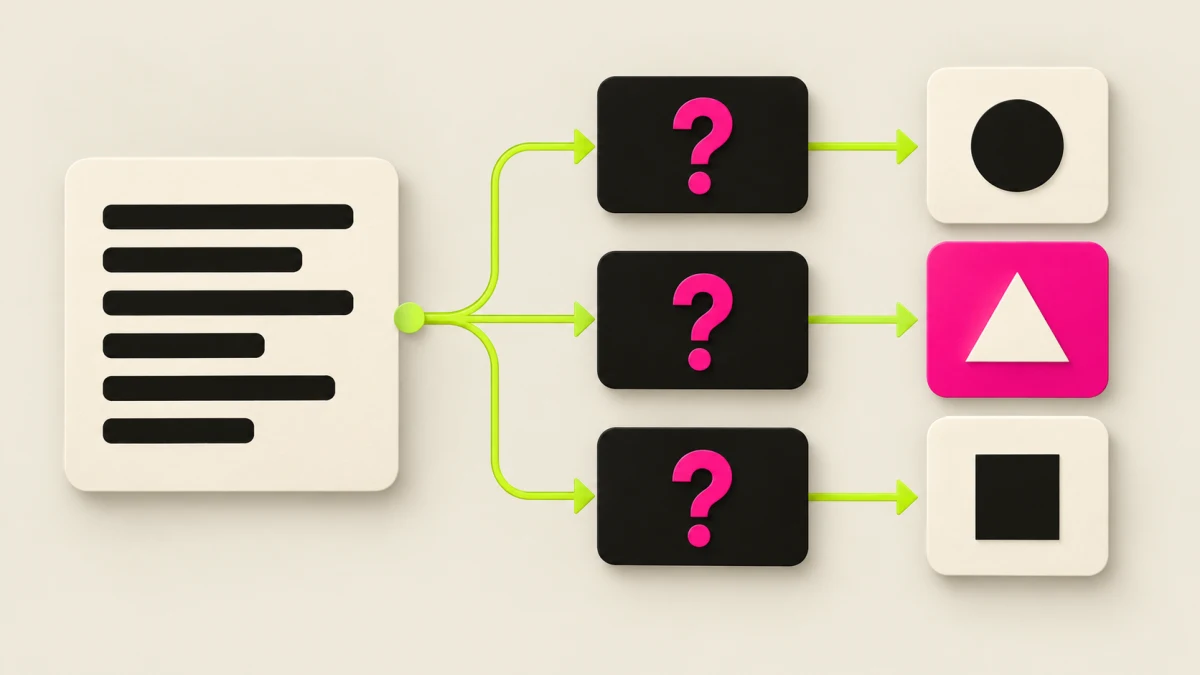
Faça perguntas independentes sobre o mesmo estado simultaneamente. O Jev as avalia em paralelo. Isso pode evitar uma cadeia de chamadas separadas, mas mais perguntas ainda adicionam tokens de entrada e devem caber nos limites da solicitação. Uma chamada posterior é necessária quando uma pergunta depende de uma resposta anterior.
As avaliações de fluxo de trabalho da TYPESAFE comparam fluxos de trabalho completos. Seus rótulos de referência são rótulos de consenso gerados por modelo, não um conjunto de verdade absoluta humana. Leia o método e teste seus próprios casos antes de adotar uma alegação de velocidade ou precisão.
06 / Faça sua primeira chamada
- Explore os exemplos de solicitação em nosso Decision Lab sem precisar fazer login. Para executar uma chamada de modelo real, abra o Playground da TypeSafe, faça login lá e comece com um estado curto e uma pergunta clara.
- Crie uma chave de API no console TypeSafe. Mantenha-a em seu servidor ou em uma variável de ambiente local, nunca no código do navegador ou em um repositório público.
- Chame a API diretamente ou use o SDK oficial para JavaScript ou Python. O exemplo abaixo é uma solicitação ilustrativa; ele não faz uma solicitação a partir desta página.
- Colete exemplos representativos, registre a versão do modelo, meça erros e a latência de ponta a ponta, e escolha quando agir ou solicitar uma revisão. Uma pontuação de probabilidade ou confiança não é uma autorização.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json

{
  "state": {
    "message": "I cannot sign in to my account."
  },
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this message?",
      "criteria": {
        "billing": "Payments or invoices",
        "support": "Account access or technical problems",
        "sales": "Pricing or product questions"
      }
    }
  }
}Decision Lab / Experimente o formato de uma chamada
Escolha uma tarefa e edite seu texto. A solicitação muda imediatamente no seu navegador. Estes são modelos de ensino originais, não resultados de modelos ao vivo; nenhuma chave de API ou login é necessário aqui.
Choice escolhe uma opção nomeada. Descreva cada opção claramente e inclua uma rota de escape para entradas que não se encaixam. Seu código decide o que acontece a seguir.
Score usa níveis ordenados e descritivos. Seu resultado numérico descreve um julgamento nessa escala, não uma contagem exata ou uma pontuação de qualidade universal.
Noul retorna a probabilidade de uma condição ser verdadeira. Defina a condição completamente nas instruções; uma chave de pergunta é apenas um rótulo para seu código.
Os exemplos editáveis usam inglês. Você pode substituir o estado pelo seu próprio idioma; teste a precisão nesse idioma antes de confiar no resultado.
{
  "model": "jev-latest",
  "state": "I need help signing in after changing my phone.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Choose the team that can best help with the message in state. Use other when none fits.",
      "criteria": {
        "accounts": "Sign-in or account access",
        "billing": "Charges, invoices or subscriptions",
        "other": "Another issue, or not enough information"
      }
    }
  }
}
Próximo: envie este corpo para POST /v1/systemone com sua chave de API do lado do servidor. O console e a API da TypeSafe exigem uma conta de provedor. O JEVLAB não coleta sua chave nem envia este exemplo para um modelo.
Antes de publicar / Quatro coisas para acertar
Uma saída type-safe ainda pode ser a resposta errada. Construa em torno dos limites documentados do modelo, não em torno de uma demonstração perfeita.
Estado pequeno e explícito
Envie os fatos relevantes com nomes de campo claros. Transforme imagens ou áudio em texto útil primeiro. Contexto longo e não relacionado e referências indiretas podem reduzir a precisão.
Perguntas que dizem o que significam
Escreva a condição completa nas instruções, não apenas em uma chave de pergunta. Evite escolhas sobrepostas e critérios contraditórios. Separe julgamentos independentes; combine-os no código.
Mantenha o trabalho exato no código
Use código para aritmética, contagem, comparações de data e verificações de permissão. Use um modelo generativo quando precisar de nova prosa ou código. O Jev escolhe ou julga dentro do espaço que você define.
Meça seu próprio fluxo de trabalho
Use exemplos rotulados, incluindo casos ambíguos, multilíngues e adversários. Rastreie decisões erradas, taxa de fallback, latência de ponta a ponta e uso de entrada. Registre a versão do modelo retornada; aliases podem mudar.
Leia os modos de falha documentados do Jev 1.13
Sua lista de verificação de primeira construção
As etapas marcadas permanecem apenas neste navegador. Nenhuma conta, sincronização ou rastreamento de conclusão é enviado ao JEVLAB.
Receitas para evoluir
- Roteamento de intenção
Escolha entre manipuladores, com um fallback explícito para solicitações fora de seu escopo.
- Perguntas paralelas
Faça perguntas independentes sobre o mesmo estado juntas; lide com dependências em uma etapa posterior.
- Pontuação composta
Julgue dimensões separadas, depois combine seus valores com pesos que você controla no código.
- Roteamento de confiança
Escolha se deve prosseguir, coletar mais contexto ou pedir revisão usando limites testados.
07 / Sua prateleira inicial
Mantenha estas referências por perto. A documentação oficial define a API; projetos da comunidade mostram aplicações possíveis, não garantias.
 Início rápido
- Apresentando os modelos System One e Jev
- O manifesto TypeSafe
- Entendendo a confiança
- Modelos, preços atuais e limites
- Avaliações de fluxo de trabalho e metodologia
Da coleção JEVLAB
- typesafe-sdk-cpppewriebontal
- go-jevmattn
- jev-cookbookparamjeetn
- typesafe-sdk-rustzchee
- system-oneasynq-io
- jev-netbrightshore
Explore as bibliotecas de origem
- Made with Jev
Explicações e construções práticas, com um guia para separar geração, decisões e execução.
- Jevable
Um fluxo visual de demonstrações da comunidade. Assista ao original e inspecione o que cada demonstração realmente envia para o Jev.
- Awesome Jev
Um índice amplo que separa recursos oficiais, SDKs da comunidade e categorias de projeto. Verifique o repositório original antes de adotar uma ferramenta.
Estas são fontes de descoberta independentes. A inclusão em um diretório não é uma auditoria ou um endosso do JEVLAB.
Perguntas que valem a pena fazer
O Jev é um chatbot ou um agente de codificação?
O Jev é um modelo de decisão que o software pode chamar. Um agente de codificação pode ajudá-lo a construir esse software, e um modelo de linguagem pode escrever texto dentro dele. Esses são papéis diferentes.
O Jev pode ver um vídeo ou uma captura de tela?
A API documentada atualmente aceita texto. Uma demonstração pode usar um modelo de visão, transcrição, DOM ou estado de jogo separado para preparar o texto que o Jev avalia. Inspecione todo esse pipeline ao comparar velocidade e custo.
Posso começar sem uma conta?
Tudo neste guia do JEVLAB e no Decision Lab está disponível sem login. Chamadas de API reais e o Playground oficial da TypeSafe exigem acesso à TypeSafe e uma chave, quando aplicável.
Um benchmark rápido significa que meu aplicativo será rápido?
Meça desde a entrada até o resultado que seu usuário vê. Rede, pré-processamento, execução de ferramentas, novas tentativas e fallbacks também levam tempo. Avaliações de fornecedores publicadas e demonstrações de criadores descrevem suas próprias configurações.
08 / Como usar o JEVLAB
O JEVLAB é um guia de campo independente e vinculado a fontes. Ele não é operado pela nem afiliado à TypeSafe AI. A página inicial serve para descobrir trabalhos; este guia serve para entendê-los.
Explore o laboratório para abrir a coleção. Pesquise por projeto, criador ou tópico e refine os resultados com filtros de caso de uso e plataforma. A barra lateral do desktop rola independentemente. A opção Popular mistura recursos correspondentes em uma nova visita; a opção Recentes mostra os recursos recém-adicionados primeiro. Em ambos os modos, os cartões individuais de Apoiadores são sorteados a partir de projetos dentro de seu período de 90 dias com um total líquido positivo confirmado, proporcionalmente a esse total. Projetos com $0 não são selecionados. Um projeto não é sorteado novamente até que todos os projetos elegíveis tenham sido sorteados uma vez, então uma nova rodada começa.
Os cartões do GitHub e de sites começam com sua prévia, com layouts de texto distintos abaixo. Vídeos mantêm sua apresentação mais ampla. Quando uma fonte expõe uma métrica pública suportada, um olho significa visualizações e uma estrela significa estrelas do GitHub capturadas no momento da coleta; nenhum deles é uma contagem de cliques do JEVLAB. Métricas ausentes são deixadas em branco.
Abra um cartão para ver as notas da fonte, o link original e o controle de salvamento. As traduções são auxiliares de leitura; verifique o original do criador para contexto, instruções atuais e alegações de desempenho.
Os apoiadores compartilham um quadro mundial. A faixa mostra os dez primeiros e a barra lateral mostra os cinco primeiros. Os cartões individuais entre os recursos são sorteados de cada projeto dentro de seu período de 90 dias com suporte líquido positivo confirmado, incluindo projetos fora dos dez primeiros e contribuidores de $1, com chances proporcionais ao suporte líquido confirmado do período atual e sem repetições dentro de uma rodada. Abra o Mural de apoiadores para ver o total atual de 90 dias de cada projeto. Projetos expirados permanecem na parte inferior com $0 e sem colocações de reconhecimento ou chances de seleção; novo suporte confirmado para a mesma URL inicia um novo período e um novo total a partir de zero. Para contribuir, procure a URL do projeto, copie sua mensagem e use Continuar com Buy Me a Coffee; cole a mensagem no checkout antes de pagar. O suporte determina as posições no quadro e as chances de uma aparição anterior no feed, não a qualidade editorial. Impressões não são garantidas.
Live estima visitantes ativos recentemente. Total Visits soma as visitas diárias de todos os idiomas; não conta pessoas únicas ao longo da vida do site. Visitas e cliques externos públicos incluem valores iniciais do operador e eventos medidos depois.
Fontes verificadas em 22 de setembro de 2026. As ilustrações são artes explicativas do JEVLAB. As traduções são assistidas por IA; as fontes oficiais permanecem autoritativas para detalhes atuais da API.