
 情報を送る
 English
 한국어
 Español
 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 ラボに戻る
JEVLAB / FIELD GUIDE
Jev 実践ガイド
モデルを理解し、最初の判断を試し、人々が何を構築しているかを発見しましょう。
出発点を選択する
1つのアイデア、1つの機能する決定、そして測定されたワークフロー。現在の場所から始めましょう。
Jevを理解する
何を入力し、何が出力されるか、そして言語モデルがいつ適切なツールとなるかを確認します。
021つの小さな決定を構築する
Decision Labでリクエストを作成し、それを自身のサーバーまたは公式のPlaygroundに持ち込みます。
03信頼性を高める
不確実性、一般的な失敗モード、および最初の評価のための短いチェックリストを探索します。
アカウントなしで、ここで読み、実験し、チェックリストを保持できます。
01 / ソフトウェア内部での小さな意思決定
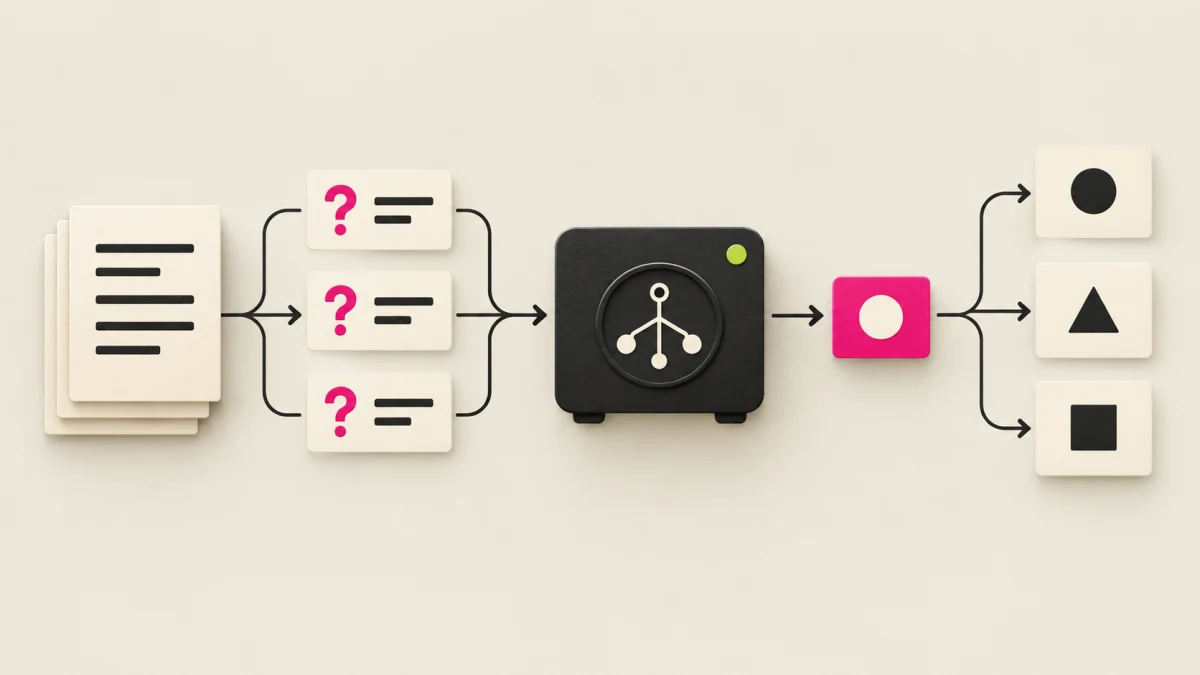
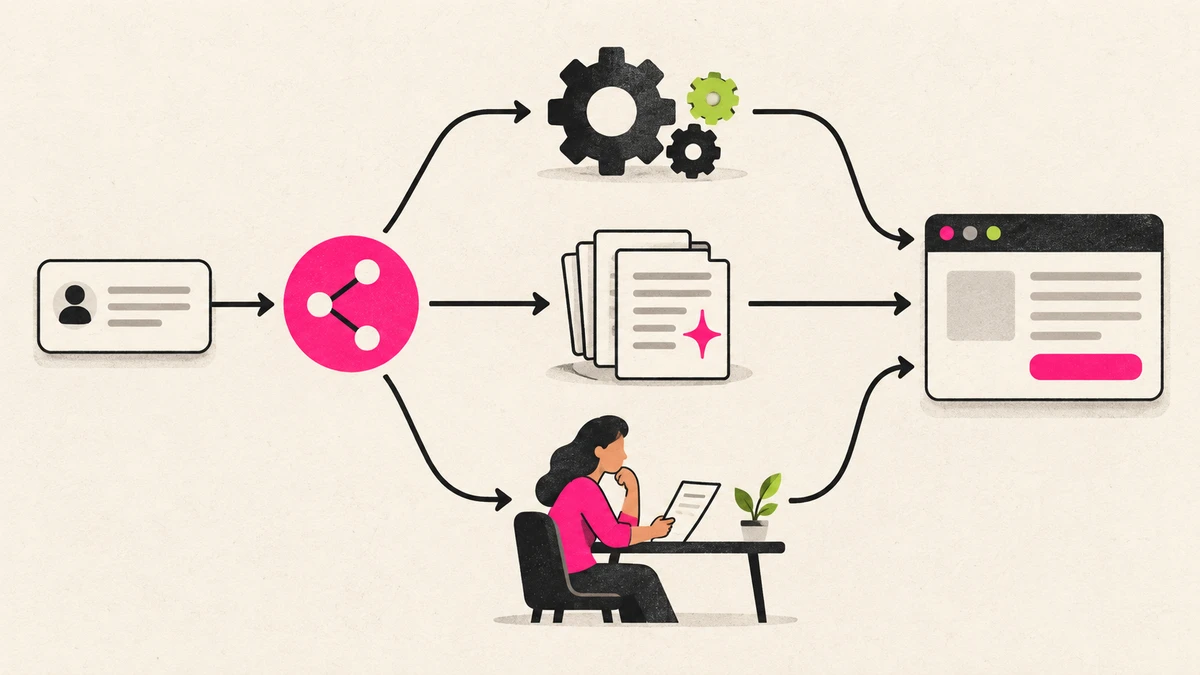
サポートの受信トレイを想像してください。ソフトウェアは利用可能なチームを把握していますが、顧客のメッセージを理解する必要があります。Jevはチームの選択、緊急度の評価、または定義したスケールに基づいたメッセージのスコアリングを行うことができます。その後、コードがルーティングルールを適用します。モデルは判断を提供しますが、アクションを実行するわけではありません。
Jevは現在、JSONやテキストの配列を含むテキストを受け付けます。画像を見たり、音声を聴いたり、文章を生成したり、コードを書いたりすることはできません。画像ベースのデモでは、まず画像をテキストや構造化された観測データに変換する別のコンポーネントが必要です。
02 / なぜ異なる種類のモデルを構築するのか?
TYPESAFEの目標は、狭い範囲のAI判断を、通常のソフトウェアにおける有用なコンポーネントのように機能させることです。そのRLCDトレーニングアプローチは、意思決定と調整された不確実性をターゲットにしています。自由形式のテキスト生成をあきらめることで、異なるインターフェースが可能になります。つまり、アプリケーションが回答空間を定義し、結果を組み合わせるのです。
有効な出力形式は、回答が真実であることの証明ではありません。独自の例でエラーを評価し、重要なアクションは明示的なアプリケーションルールの背後に配置してください。
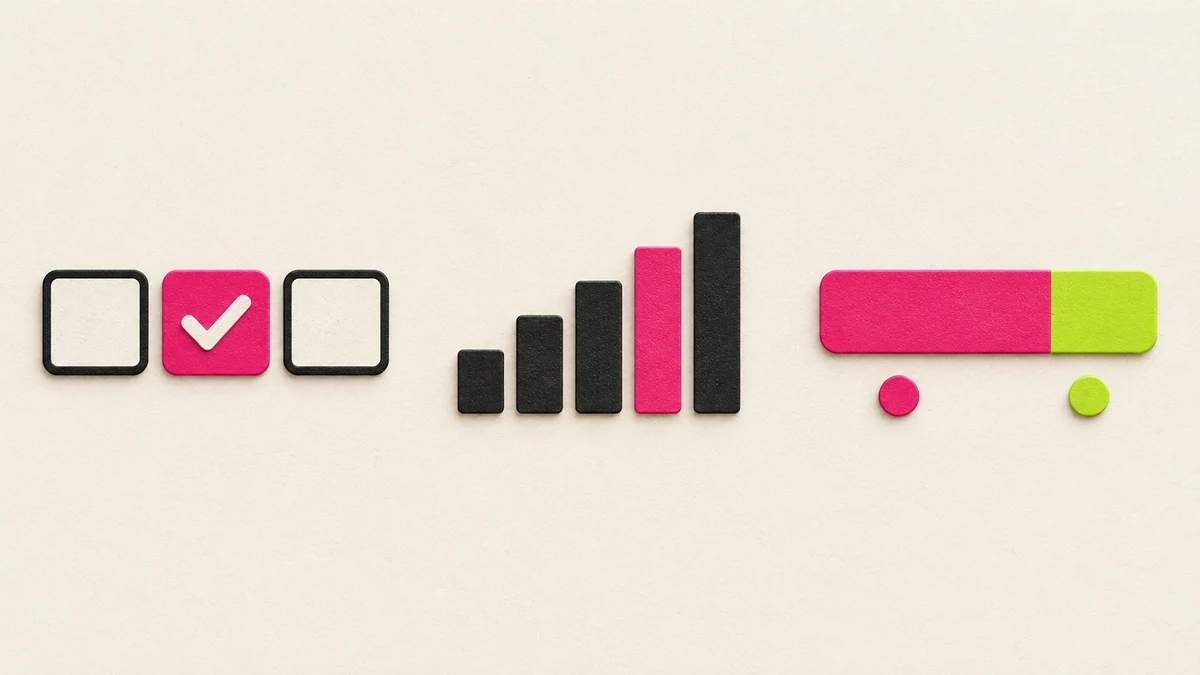
03 / 3つの質問方法
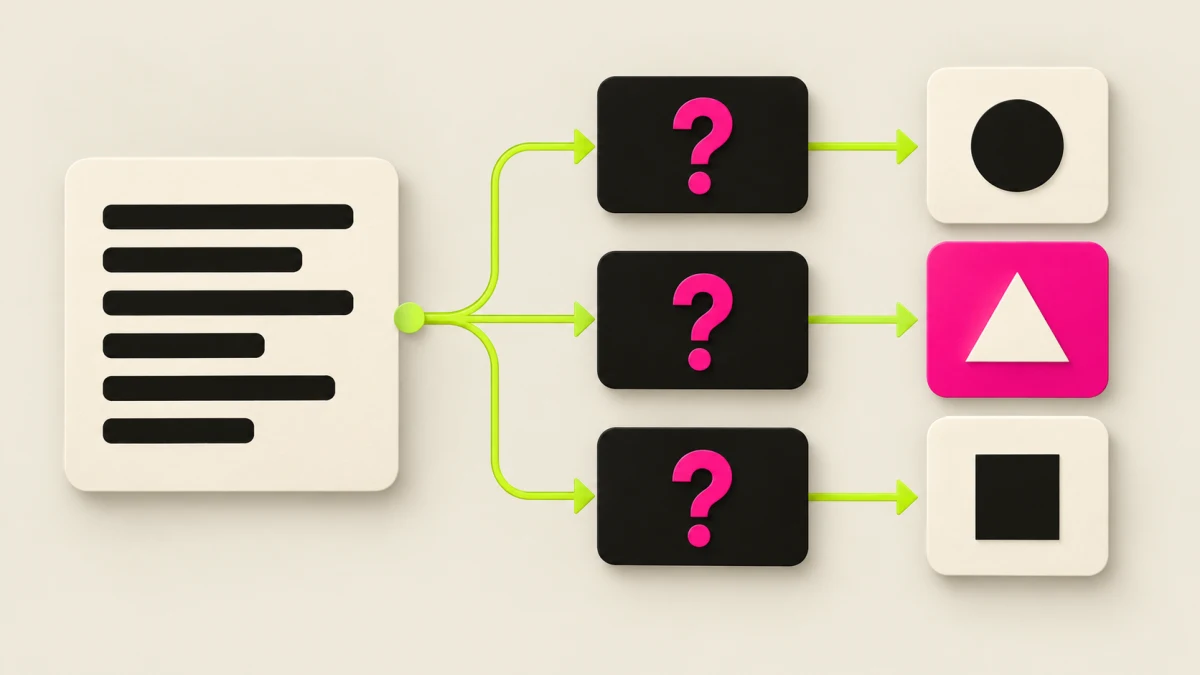
- Choice
- 請求、技術サポート、販売など、提供するセットから1つのオプションを選択します。応答には、選択されたオプションとオプション全体の分布が含まれます。
- Score
- 「冷静」「不満」「非常に不満」など、順序付けられた記述レベルに観測値を配置します。返されるスコアはレベルの中間に位置することがあり、一般的な正解確率ではありません。
- Noul
- ステートメントが正しいかどうかを尋ねます。Noulは0から1までの「はい」の確率を返します。同時に真となり得るラベルについては、個別の質問を行ってください。
行動する前に不確実性を読み取る
ChoiceとScoreは、確率と、その分布から導出された個別の信頼度値を返します。勝利したオプションの確率と信頼度は異なる数値です。Noulには確率があり、個別の信頼度フィールドはありません。
学習用例 · 固定信頼度 0.72
 レビューまたは詳細なコンテキストを依頼する
しきい値を動かして、コードの分岐が変化する様子を確認してください。これは固定された図解であり、Jevの予測や推奨されるしきい値ではありません。ミスのコストに対して境界をテストしてください。しきい値を超えたからといって、行動する許可が与えられるわけではありません。
04 / JevとLLMは異なる役割を担う
これらはインターフェースの違いであり、どちらかのモデルがすべてのタスクで優れているという主張ではありません。LLMの能力とレイテンシは、モデル、設定、ツール、入力によって異なります。
| 次元 | Jev | 生成型LLM |
|---|---|---|
| 出力 | 定義された選択肢、スコア、確率 | 生成されたテキストまたはコード。多くのモデルは構造化出力もサポートしています |
| 有用な用途 | ルーティング、選択、ランキング信号、境界チェック | 執筆、説明、自由形式の推論と生成 |
| 入力 | テキストまたは構造化されたテキスト状態 | テキスト。一部のモデルは画像、音声、動画も受け付けます |
| アクションの制御者 | アプリケーションが判断を組み合わせてルールを実行する | アプリケーション側で出力とツールのアクションを検証する必要がある |
| 不確実性 | 調整された意思決定のために設計された確率出力。ただし誤る可能性はある | 書面による信頼性の主張にはタスク固有の検証が必要 |
05 / インタラクションに耐えうる速度
TYPESAFEの9月15日のローンチ投稿では、意思決定型の呼び出しについてこの範囲が報告されています。また、公開された評価は一般的に米国西海岸から実行されたことにも言及しています。これはベンダーが報告したスナップショットであり、JEVLABのベンチマークや、ユーザーの場所におけるレイテンシの保証ではありません。
同じ状態に関する独立した質問をまとめて行います。Jevはそれらを並列に評価します。これにより個別の呼び出しの連鎖を回避できますが、質問が増えると入力トークンが増加し、リクエスト制限内に収める必要があります。質問が以前の回答に依存する場合は、後の呼び出しが必要です。
TYPESAFEのワークフロー評価は、ワークフロー全体を比較します。その参照ラベルはモデルが生成した合意ラベルであり、人間の正解セットではありません。速度や精度の主張を採用する前に、手法を読み、独自のケースでテストしてください。
06 / 最初の呼び出しを行う
- サインインせずに、Decision Labでリクエスト例を探索できます。実際のモデル呼び出しを実行するには、TypeSafeのPlaygroundを開き、そこでサインインして、短い状態と明確な質問から始めてください。
- TypeSafeコンソールでAPIキーを作成してください。キーはサーバー内またはローカルの環境変数に保持し、ブラウザコードや公開リポジトリには絶対に含めないでください。
- APIを直接呼び出すか、公式のJavaScriptまたはPython SDKを使用してください。以下の例は説明用であり、このページからリクエストが送信されることはありません。
- 代表的な例を収集し、モデルバージョンを記録し、エラーとエンドツーエンドのレイテンシを測定した上で、実行またはレビュー依頼の判断を行ってください。確率や信頼度(Confidence Score)は承認を意味するものではありません。
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json

{
  "state": {
    "message": "I cannot sign in to my account."
  },
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this message?",
      "criteria": {
        "billing": "Payments or invoices",
        "support": "Account access or technical problems",
        "sales": "Pricing or product questions"
      }
    }
  }
}Decision Lab / 呼び出しの形状を試す
タスクを選択してテキストを編集します。ブラウザ内でリクエストが即座に変更されます。これらはオリジナルの学習用テンプレートであり、ライブモデルの結果ではありません。ここではAPIキーやサインインは不要です。
Choiceは名前付きのオプションを1つ選択します。各オプションを明確に記述し、適合しない入力のためのエスケープルートを含めてください。次に何が起こるかはコードで決定します。
Scoreは順序付けられた記述レベルを使用します。その数値結果は、正確なカウントや普遍的な品質スコアではなく、その尺度における判断を表します。
Noulは、ある条件が真である確率を返します。指示の中で条件を完全に定義してください。質問キーはコードのためのラベルに過ぎません。
編集可能な例では英語を使用しています。状態を独自の言語に置き換えることができますが、結果に依存する前にその言語での精度をテストしてください。
{
  "model": "jev-latest",
  "state": "I need help signing in after changing my phone.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Choose the team that can best help with the message in state. Use other when none fits.",
      "criteria": {
        "accounts": "Sign-in or account access",
        "billing": "Charges, invoices or subscriptions",
        "other": "Another issue, or not enough information"
      }
    }
  }
}
次へ:サーバーサイドのAPIキーを使用して、このボディをPOST /v1/systemoneに送信します。TypeSafeのコンソールとAPIにはプロバイダーアカウントが必要です。JEVLABはキーを収集したり、この例をモデルに送信したりすることはありません。
リリースする前に / 押さえておくべき4つのこと
型安全な出力であっても、間違った答えである可能性があります。完璧なデモではなく、モデルの文書化された制限に基づいて構築してください。
小さく明確な状態
明確なフィールド名を使用して関連する事実を送信してください。画像や音声は、まず有用なテキストに変換してください。長く無関係なコンテキストや間接的な参照は、精度を低下させる可能性があります。
意味を明確にする質問
質問キーだけでなく、指示の中に完全な条件を記述してください。重複する選択肢や矛盾する基準は避けてください。独立した判断は分離し、コード内で組み合わせてください。
正確な作業はコードで行う
算術、カウント、日付の比較、権限チェックにはコードを使用してください。新しい文章やコードが必要な場合に生成モデルを使用します。Jevは、あなたが定義した空間内で選択または判断を行います。
独自のワークフローを測定する
曖昧なケース、多言語のケース、敵対的なケースを含むラベル付きの例を使用してください。誤った決定、フォールバック率、エンドツーエンドのレイテンシ、入力使用量を追跡します。返されたモデルバージョンをログに記録してください。エイリアスは変更される可能性があります。
最初のビルド用チェックリスト
チェックしたステップはこのブラウザ内にのみ保持されます。アカウント、同期、完了状況の追跡はJEVLABに送信されません。
成長のためのレシピ
- インテントルーティング
ハンドラー間で選択を行い、スコープ外のリクエストに対しては明示的なフォールバックを用意します。
- 並列質問
同じ状態について独立した質問を同時に行い、依存関係は後のステップで処理します。
- 複合スコアリング
個別の次元を判断し、コード内で制御する重みを使用してそれらの値を組み合わせます。
- 信頼度ルーティング
テスト済みのしきい値を使用して、続行するか、より多くのコンテキストを収集するか、レビューを依頼するかを選択します。
07 / 最初の棚
これらのリファレンスを手元に置いてください。公式ドキュメントがAPIを定義し、コミュニティプロジェクトは可能性を示すものであり、保証ではありません。
JEVLABコレクションより
- typesafe-sdk-cpppewriebontal
- go-jevmattn
- jev-cookbookparamjeetn
- typesafe-sdk-rustzchee
- system-oneasynq-io
- jev-netbrightshore
ソースライブラリを探索する
- Made with Jev
生成、決定、実行を分割するためのガイドを含む、解説と実践的なビルド。
- Jevable
コミュニティデモの視覚的なストリーム。オリジナルを視聴し、各デモが実際にJevに何を送信しているかを調査します。
- Awesome Jev
公式リソース、コミュニティSDK、プロジェクトカテゴリを分離した広範なインデックス。ツールを採用する前に元のリポジトリを確認してください。
これらは独立した発見ソースです。ディレクトリへの掲載は、JEVLABによる監査や推奨ではありません。
尋ねる価値のある質問
Jevはチャットボットですか、それともコーディングエージェントですか?
Jevはソフトウェアが呼び出せる決定モデルです。コーディングエージェントはそのソフトウェアの構築を支援し、言語モデルはその中でテキストを書くことができます。これらは異なる役割です。
Jevは動画やスクリーンショットを見ることができますか?
文書化されたAPIは現在テキストを受け取ります。デモでは、Jevが評価するテキストを準備するために、別の視覚モデル、文字起こし、DOM、またはゲーム状態を使用する場合があります。速度とコストを比較する際は、そのパイプライン全体を調査してください。
アカウントなしで始められますか?
このJEVLABガイドとDecision Labのすべては、サインインなしで利用可能です。実際のAPI呼び出しと公式のTypeSafe Playgroundには、TypeSafeへのアクセスと該当する場合はキーが必要です。
高速なベンチマークは、アプリケーションが高速になることを意味しますか?
入力からユーザーが見る結果までを測定してください。ネットワーク、前処理、ツール実行、再試行、フォールバックにも時間がかかります。公開されているベンダー評価や作成者のデモは、それぞれのセットアップを説明しています。
08 / JEVLABの使い方
JEVLABは独立したソースリンク型のフィールドガイドです。TypeSafe AIによって運営・提携されているものではありません。ランディングページは作品を発見するためのものであり、このガイドはそれを理解するためのものです。
「Explore the lab」からコレクションを開きます。プロジェクト、作成者、またはトピックで検索し、ユースケースやプラットフォームのフィルターで結果を絞り込むことができます。デスクトップのサイドバーは個別にスクロールします。訪問のたびにリソースをシャッフルして表示する「Popular」、新しく追加されたリソースを優先する「Latest」の2つのモードがあります。どちらのモードでも、個別のサポーターカードは、90日間の有効期間内で正の確定純合計額を持つプロジェクトから、その合計額に比例して抽出されます。合計額が$0のプロジェクトは選択されません。すべての対象プロジェクトが1回ずつ抽出されるまで同じプロジェクトは再抽出されず、その後新しいラウンドが始まります。
GitHubとウェブサイトのカードはプレビューが先頭に表示され、その下に個別のテキストレイアウトが配置されます。動画はより広いプレゼンテーションを維持します。ソースがサポートされている公開メトリクスを公開している場合、目のアイコンは閲覧数、星のアイコンは収集時に取得されたGitHubのスター数を表します。これらはどちらもJEVLABのクリック数ではありません。メトリクスがない場合は空白のままになります。
カードを開くと、ソースノート、元のリンク、保存コントロールが表示されます。翻訳は読解補助であり、文脈や最新の指示、パフォーマンスの主張については作成者のオリジナルを確認してください。
サポーターは全世界共通のボードを共有します。ストリップには上位10件、サイドバーには上位5件が表示されます。リソース間に表示される個別のカードは、上位10件外や$1の寄付者を含む、90日間の有効期間内で正の確定純支援額を持つすべてのプロジェクトから抽出されます。抽出確率は現在の期間の確定純支援額に比例し、1ラウンド内での重複はありません。「サポーターの殿堂」を開くと、各プロジェクトの現在の90日間の合計額を確認できます。期限切れのプロジェクトは$0として下部に残り、掲載や選択の対象にはなりません。同じURLに対して新たに支援が確定すると、新しい期間が始まり、合計額はゼロから再スタートします。支援を行うには、プロジェクトのURLを検索し、メッセージをコピーして「Buy Me a Coffeeで続ける」を使用してください。支払い前にチェックアウト画面でメッセージを貼り付けてください。支援額はボード上の順位とフィードへの表示順序を決定するものであり、編集上の評価ではありません。インプレッション数は保証されません。
Liveは最近活動している訪問者の推定値です。Total Visitsは全言語の日別訪問数の合計で、全期間のユニーク人数ではありません。公開の訪問数と外部クリック数には運営者の初期値とその後の実測値が含まれます。
ソース確認日:2026年9月22日。図版はJEVLABの解説用アートワークです。翻訳はAI支援によるものであり、現在のAPI詳細については公式ソースが権威となります。