
 Enviar recurso
 English
 한국어
 日本語
 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Volver al laboratorio
JEVLAB / FIELD GUIDE
Una guía práctica de Jev
Comprenda el modelo, pruebe su primera decisión y descubra qué está construyendo la gente.
Elige tu punto de partida
Una idea, una decisión funcional, luego un flujo de trabajo medido. Empieza donde estés.
Entender Jev
Mira qué toma, qué produce y cuándo un modelo de lenguaje sigue siendo la herramienta adecuada.
02Construir una pequeña decisión
Da forma a una solicitud en el Decision Lab, luego llévala a tu propio servidor o al Playground oficial.
03Hacerlo confiable
Explora la incertidumbre, los modos de falla comunes y una lista de verificación breve para tu primera evaluación.
Lee, experimenta y mantén tu lista de verificación aquí sin una cuenta.
01 / Pequeñas decisiones, dentro de tu software
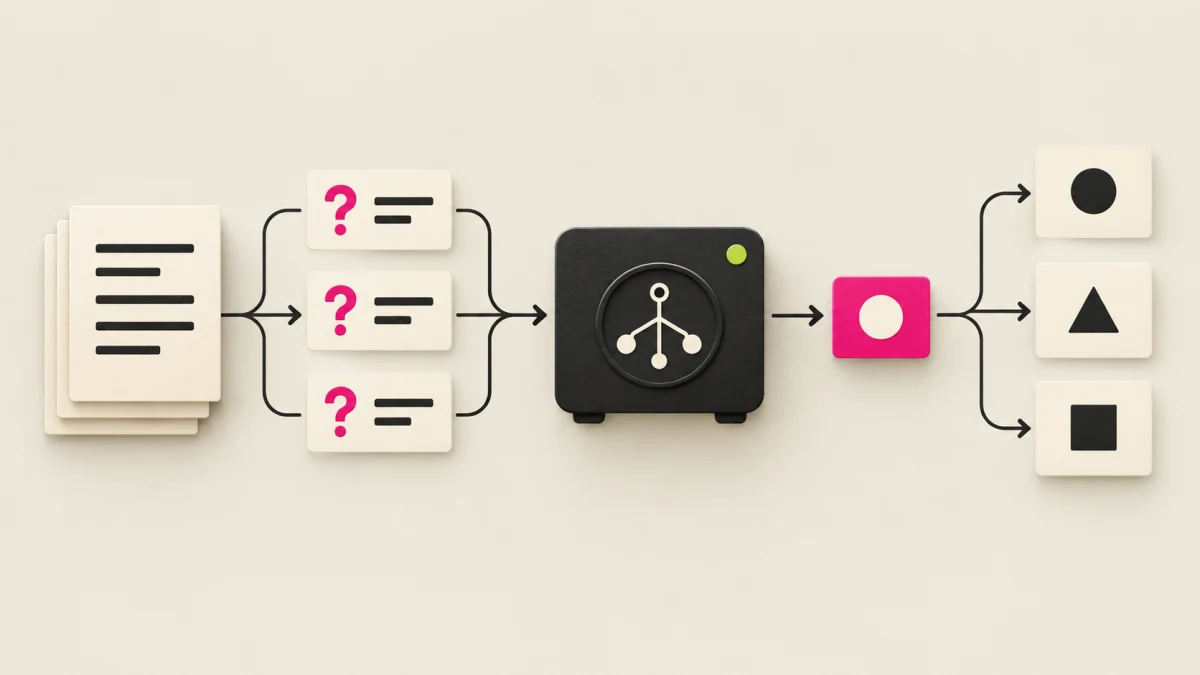
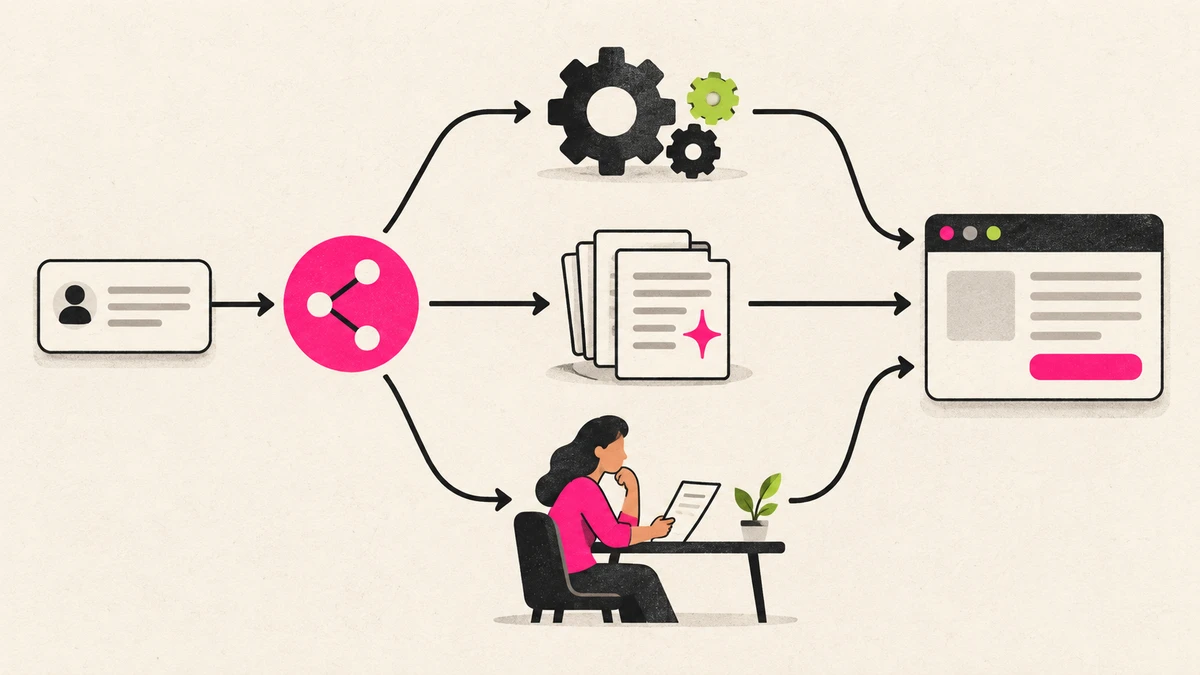
Piensa en una bandeja de entrada de soporte. Tu software conoce los equipos disponibles, pero necesita entender el mensaje de un cliente. Jev puede seleccionar un equipo, evaluar la urgencia o puntuar el mensaje según una escala que tú definas. Tu código aplica entonces las reglas de enrutamiento. El modelo proporciona un juicio; no ejecuta la acción.
Jev acepta actualmente texto, incluyendo JSON y matrices de texto. No ve imágenes, no escucha audio, no genera prosa ni escribe código. Una demostración basada en imágenes necesita primero otro componente para convertir la imagen en texto utilizable u observaciones estructuradas.
02 / ¿Por qué construir un tipo de modelo diferente?
El objetivo de TypeSafe es hacer que los juicios de IA estrecha se comporten como componentes útiles en el software ordinario. Su enfoque de entrenamiento RLCD se centra en las decisiones y la incertidumbre calibrada. Renunciar a la generación de texto libre hace posible una interfaz diferente: la aplicación define el espacio de respuesta y combina los resultados.
Una forma de salida válida no es prueba de que la respuesta sea verdadera. Evalúa los errores en tus propios ejemplos y mantén las acciones consecuentes detrás de reglas de aplicación explícitas.
03 / Tres formas de preguntar
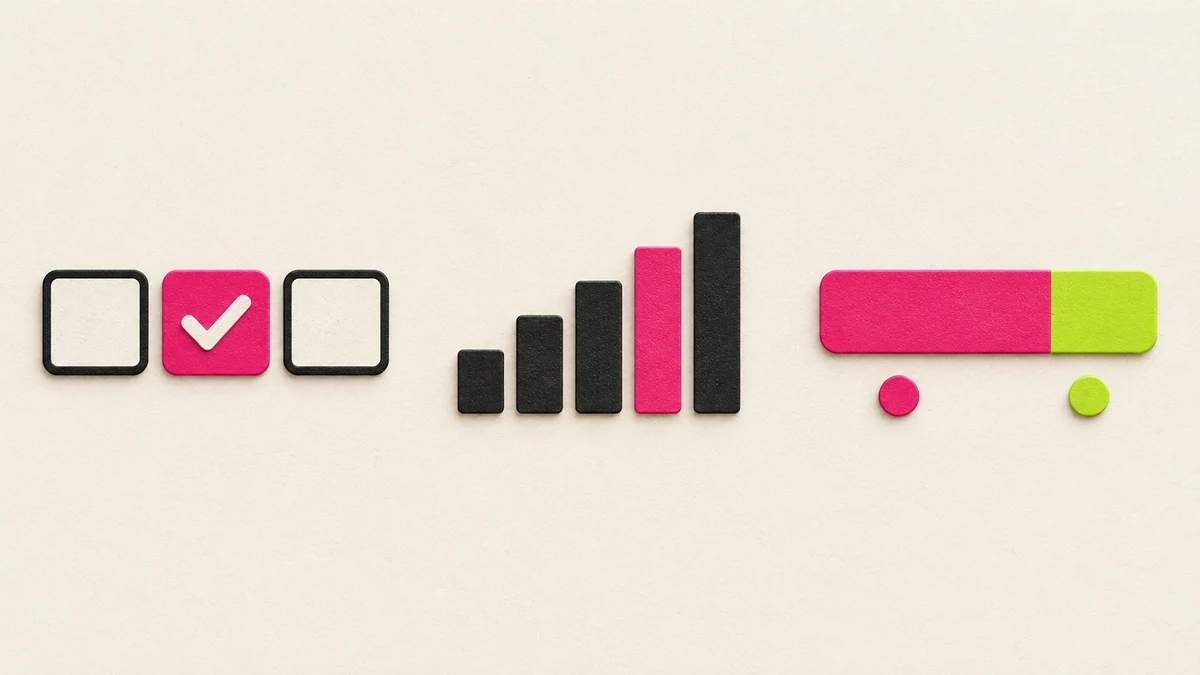
- Choice
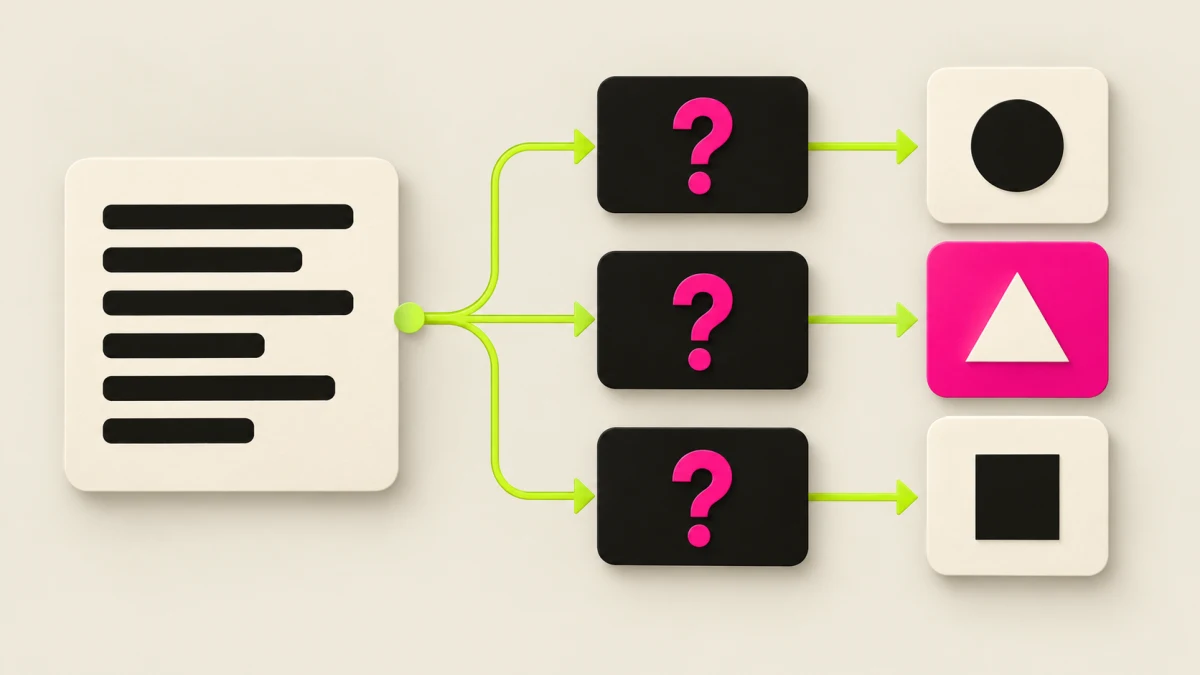
- Elige una opción de un conjunto que tú proporciones, como facturación, soporte técnico o ventas. La respuesta incluye la opción seleccionada y una distribución sobre las opciones.
- Score
- Coloca una observación en niveles ordenados y descriptivos, como tranquilo, frustrado y muy frustrado. La puntuación devuelta puede situarse entre niveles; no es una probabilidad general de corrección.
- Noul
- Pregunta si una afirmación es cierta. Noul devuelve la probabilidad de sí, de 0 a 1. Haz preguntas separadas para etiquetas que puedan ser ciertas al mismo tiempo.
Lee la incertidumbre antes de actuar
Choice y Score devuelven probabilidades y un valor de confianza separado derivado de su distribución. La probabilidad y la confianza de la opción ganadora son números diferentes. Noul tiene una probabilidad y ningún campo de confianza separado.
Ejemplo de enseñanza · confianza fija 0.72
 Pedir revisión o más contexto
Mueve el umbral para ver cómo cambia una rama de código. Esta es una ilustración fija, no una predicción de Jev ni un umbral recomendado. Prueba los límites frente al costo de los errores; superar el umbral nunca otorga permiso para actuar.
04 / Jev y un LLM realizan trabajos diferentes
Estas son diferencias de interfaz, no una afirmación de que un modelo gane en todas las tareas. Las capacidades y la latencia de los LLM varían según el modelo, la configuración, las herramientas y la entrada.
| Dimensión | Jev | LLM generativo |
|---|---|---|
| Salida | Opciones definidas, puntuaciones, probabilidades | Texto o código generado; muchos modelos también admiten salida estructurada |
| Un ajuste útil | Enrutamiento, selección, señales de clasificación, comprobaciones acotadas | Redacción, explicación, razonamiento y generación abierta |
| Entrada | Texto o estado de texto estructurado | Texto; algunos modelos también aceptan imágenes, audio o vídeo |
| ¿Quién controla la acción? | Tu aplicación combina juicios y ejecuta reglas | Tu aplicación aún debe validar las salidas y las acciones de las herramientas |
| Incertidumbre | Salidas de probabilidad diseñadas para decisiones calibradas; aún falibles | Una afirmación de confianza escrita necesita validación específica de la tarea |
05 / Lo suficientemente rápido para estar en la interacción
La publicación de lanzamiento de TypeSafe del 15 de septiembre reporta este rango para sus llamadas con forma de decisión. También señala que sus evaluaciones publicadas se ejecutaron generalmente desde la costa oeste de EE. UU. Esta es una instantánea reportada por el proveedor, no un benchmark de JEVLAB ni una garantía de latencia para tu ubicación.
Haz preguntas independientes sobre el mismo estado juntas. Jev las evalúa en paralelo. Esto puede evitar una cadena de llamadas separadas, pero más preguntas añaden tokens de entrada y deben ajustarse a los límites de la solicitud. Se necesita una llamada posterior cuando una pregunta depende de una respuesta anterior.
Las evaluaciones de flujo de trabajo de TypeSafe comparan flujos de trabajo completos. Sus etiquetas de referencia son etiquetas de consenso generadas por modelos, no un conjunto de verdad fundamental humana. Lee el método y prueba tus propios casos antes de adoptar una afirmación de velocidad o precisión.
06 / Haz tu primera llamada
- Explora los ejemplos de solicitud en nuestro Decision Lab sin iniciar sesión. Para ejecutar una llamada real al modelo, abre el Playground de TypeSafe, inicia sesión allí y comienza con un estado breve y una pregunta clara.
- Crea una clave API en la consola de TypeSafe. Guárdala en tu servidor o en una variable de entorno local, nunca en el código del navegador o en un repositorio público.
- Llama a la API directamente o utiliza el SDK oficial de JavaScript o Python. El ejemplo a continuación es una solicitud ilustrativa; no realiza una solicitud desde esta página.
- Recopila ejemplos representativos, registra la versión del modelo, mide los errores y la latencia de extremo a extremo, y elige cuándo actuar o solicitar una revisión. Una puntuación de probabilidad o confianza no es una autorización.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json

{
  "state": {
    "message": "I cannot sign in to my account."
  },
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this message?",
      "criteria": {
        "billing": "Payments or invoices",
        "support": "Account access or technical problems",
        "sales": "Pricing or product questions"
      }
    }
  }
}Decision Lab / Prueba la forma de una llamada
Elige una tarea y edita su texto. La solicitud cambia inmediatamente en tu navegador. Estas son plantillas de enseñanza originales, no resultados de modelos en vivo; no se necesita clave de API ni inicio de sesión aquí.
Choice elige una opción nombrada. Describe cada opción claramente e incluye una ruta de escape para la entrada que no encaja. Tu código decide qué sucede después.
Score utiliza niveles descriptivos ordenados. Su resultado numérico describe un juicio en esa escala, no un recuento exacto o una puntuación de calidad universal.
Noul devuelve la probabilidad de que una condición sea verdadera. Define la condición completamente en las instrucciones; una clave de pregunta es solo una etiqueta para tu código.
Los ejemplos editables usan inglés. Puedes reemplazar el estado con tu propio idioma; prueba la precisión en ese idioma antes de confiar en el resultado.
{
  "model": "jev-latest",
  "state": "I need help signing in after changing my phone.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Choose the team that can best help with the message in state. Use other when none fits.",
      "criteria": {
        "accounts": "Sign-in or account access",
        "billing": "Charges, invoices or subscriptions",
        "other": "Another issue, or not enough information"
      }
    }
  }
}
Siguiente: envía este cuerpo a POST /v1/systemone con tu clave de API del lado del servidor. La consola y la API propias de TypeSafe requieren una cuenta de proveedor. JEVLAB no recopila tu clave ni envía este ejemplo a un modelo.
Antes de publicar / Cuatro cosas que debes hacer bien
La salida de tipo seguro aún puede ser la respuesta incorrecta. Construye alrededor de los límites documentados del modelo, no alrededor de una demostración perfecta.
Estado pequeño y explícito
Envía los hechos relevantes con nombres de campo claros. Convierte imágenes o audio en texto útil primero. El contexto largo e irrelevante y las referencias indirectas pueden reducir la precisión.
Preguntas que dicen lo que significan
Escribe la condición completa en las instrucciones, no solo en una clave de pregunta. Evita opciones superpuestas y criterios contradictorios. Separa los juicios independientes; combínalos en el código.
Mantén el trabajo exacto en el código
Usa código para aritmética, conteo, comparaciones de fechas y comprobaciones de permisos. Usa un modelo generativo cuando necesites prosa o código nuevo. Jev elige o juzga dentro del espacio que defines.
Mide tu propio flujo de trabajo
Usa ejemplos etiquetados, incluidos casos ambiguos, multilingües y adversarios. Rastrea decisiones incorrectas, tasa de respaldo, latencia de extremo a extremo y uso de entrada. Registra la versión del modelo devuelta; los alias pueden cambiar.
Lee los modos de falla documentados de Jev 1.13
Tu lista de verificación para la primera construcción
Los pasos marcados permanecen solo en este navegador. No se envía ninguna cuenta, sincronización o seguimiento de finalización a JEVLAB.
Recetas para crecer
- Enrutamiento de intención
Elige entre manejadores, con un respaldo explícito para solicitudes fuera de su alcance.
- Preguntas paralelas
Haz preguntas independientes sobre el mismo estado juntas; maneja las dependencias en un paso posterior.
- Puntuación compuesta
Juzga dimensiones separadas, luego combina sus valores con pesos que controlas en el código.
- Enrutamiento de confianza
Elige si proceder, recopilar más contexto o pedir una revisión usando umbrales probados.
07 / Tu estantería de inicio
Mantén estas referencias cerca. La documentación oficial define la API; los proyectos de la comunidad muestran posibles aplicaciones, no garantías.
 Inicio rápido
- Presentamos los modelos System One y Jev
- El manifiesto de TypeSafe
- Entender la confianza
- Modelos, precios actuales y límites
- Evaluaciones de flujo de trabajo y metodología
De la colección JEVLAB
- typesafe-sdk-cpppewriebontal
- go-jevmattn
- jev-cookbookparamjeetn
- typesafe-sdk-rustzchee
- system-oneasynq-io
- jev-netbrightshore
Explora las bibliotecas de fuentes
- Made with Jev
Explicaciones y construcciones prácticas, con una guía para dividir la generación, las decisiones y la ejecución.
- Jevable
Un flujo visual de demostraciones de la comunidad. Mira el original e inspecciona lo que cada demostración envía realmente a Jev.
- Awesome Jev
Un índice amplio que separa los recursos oficiales, los SDK de la comunidad y las categorías de proyectos. Revisa el repositorio original antes de adoptar una herramienta.
Estas son fuentes de descubrimiento independientes. La inclusión en un directorio no es una auditoría ni un respaldo de JEVLAB.
Preguntas que vale la pena hacer
¿Es Jev un chatbot o un agente de codificación?
Jev es un modelo de decisión que el software puede llamar. Un agente de codificación puede ayudarte a construir ese software, y un modelo de lenguaje puede escribir texto dentro de él. Estos son roles diferentes.
¿Puede Jev ver un video o una captura de pantalla?
La API documentada actualmente toma texto. Una demostración puede usar un modelo de visión, transcripción, DOM o estado de juego separado para preparar el texto que Jev evalúa. Inspecciona todo ese proceso al comparar velocidad y costo.
¿Puedo empezar sin una cuenta?
Todo en esta guía de JEVLAB y Decision Lab está disponible sin iniciar sesión. Las llamadas a la API real y el Playground oficial de TypeSafe requieren acceso a TypeSafe y una clave cuando corresponda.
¿Un benchmark rápido significa que mi aplicación será rápida?
Mide desde la entrada hasta el resultado que ve tu usuario. La red, el preprocesamiento, la ejecución de herramientas, los reintentos y los respaldos también toman tiempo. Las evaluaciones de proveedores publicadas y las demostraciones de los creadores describen sus propias configuraciones.
08 / Cómo usar JEVLAB
JEVLAB es una guía de campo independiente vinculada a fuentes. No es operada por ni está afiliada a TypeSafe AI. La página de inicio es para descubrir trabajos; esta guía es para entenderlos.
Explorar el laboratorio abre la colección. Busque por proyecto, creador o tema y acote los resultados con filtros de caso de uso y plataforma. La barra lateral de escritorio se desplaza de forma independiente. Popular mezcla los recursos coincidentes en cada nueva visita; Latest muestra primero los recursos recién añadidos. En ambos modos, las tarjetas individuales de los colaboradores se extraen de proyectos dentro de su período de 90 días con un total neto confirmado positivo, en proporción a ese total. Los proyectos con $0 no son seleccionados. Un proyecto no vuelve a ser seleccionado hasta que todos los proyectos elegibles hayan tenido un turno, momento en el que comienza una nueva ronda.
Las tarjetas de GitHub y sitios web encabezan con su vista previa, con diseños de texto distintos debajo. Los videos mantienen su presentación más amplia. Cuando una fuente expone una métrica pública compatible, un ojo significa vistas y una estrella significa estrellas de GitHub capturadas en el momento de la recopilación; ninguna es un recuento de clics de JEVLAB. Las métricas faltantes se dejan en blanco.
Abre una tarjeta para ver las notas de la fuente, el enlace original y el control de guardado. Las traducciones son ayudas de lectura; consulta el original del creador para obtener contexto, instrucciones actuales y afirmaciones de rendimiento.
Los colaboradores comparten un tablero mundial. La franja muestra los diez primeros y la barra lateral muestra los cinco primeros. Las tarjetas individuales entre recursos se extraen de cada proyecto dentro de su período de 90 días con apoyo neto confirmado positivo, incluidos los proyectos fuera de los diez primeros y los contribuyentes de $1, con probabilidades proporcionales al apoyo neto confirmado del período actual y sin repeticiones dentro de una ronda. Abra el Muro de colaboradores para ver el total actual de 90 días de cada proyecto. Los proyectos caducados permanecen en la parte inferior con $0 y sin ubicaciones de reconocimiento ni posibilidades de selección; el nuevo apoyo confirmado para la misma URL inicia un nuevo período y un nuevo total desde cero. Para contribuir, busque la URL del proyecto, copie su mensaje y utilice Continuar con Buy Me a Coffee; pegue el mensaje en la caja antes de pagar. El apoyo determina las posiciones en el tablero y las probabilidades de una aparición temprana en el feed, no la calidad editorial. No se garantizan las impresiones.
Live estima los visitantes activos recientemente. Total Visits suma las visitas diarias de todos los idiomas; no cuenta personas únicas durante toda la vida del sitio. Las visitas y los clics externos públicos incluyen valores iniciales del operador y eventos medidos después.
Fuentes verificadas el 22 de septiembre de 2026. Las ilustraciones son material explicativo de JEVLAB. Las traducciones son asistidas por IA; las fuentes oficiales siguen siendo autorizadas para los detalles actuales de la API.