
 Fund einreichen
 English
 한국어
 日本語
 Español
 Français
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Zurück zum Labor
JEVLAB / FIELD GUIDE
Ein praktischer Leitfaden zu Jev
Verstehen Sie das Modell, versuchen Sie Ihre erste Entscheidung und entdecken Sie, was andere damit bauen.
Wählen Sie Ihren Startpunkt
Eine Idee, eine funktionierende Entscheidung, dann ein gemessener Arbeitsablauf. Starten Sie dort, wo Sie gerade stehen.
Jev verstehen
Sehen Sie, was hineingeht, was herauskommt und wann ein Sprachmodell immer noch das richtige Werkzeug ist.
02Eine kleine Entscheidung treffen
Formulieren Sie eine Anfrage im Decision Lab und übertragen Sie diese dann auf Ihren eigenen Server oder in das offizielle Playground.
03Zuverlässigkeit sicherstellen
Untersuchen Sie Unsicherheiten, häufige Fehlerquellen und eine kurze Checkliste für Ihre erste Evaluierung.
Lesen, experimentieren und speichern Sie Ihre Checkliste hier ohne ein Konto.
01 / Kleine Entscheidungen innerhalb Ihrer Software
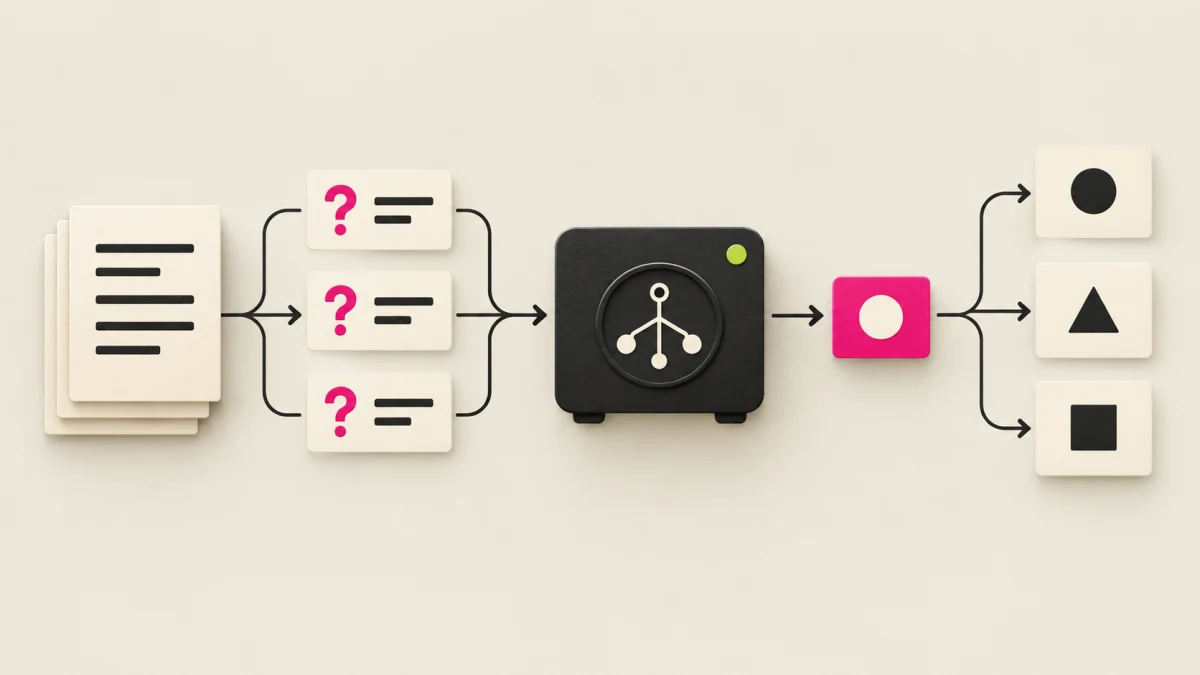
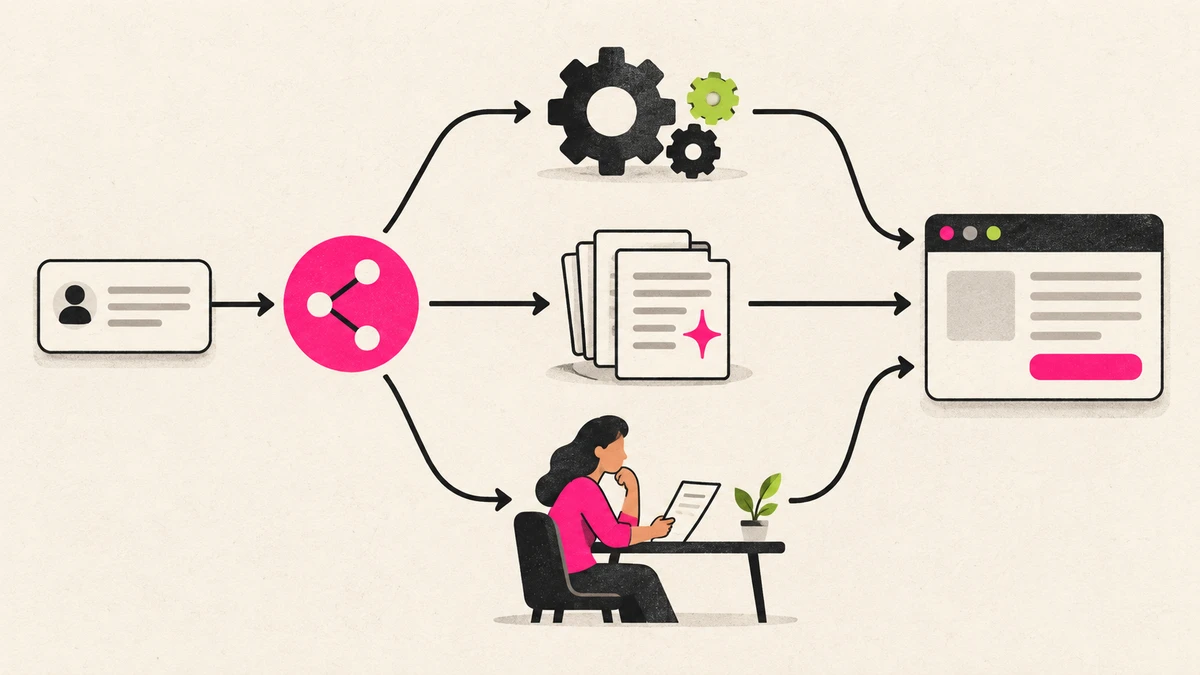
Denken Sie an einen Support-Posteingang. Ihre Software kennt die verfügbaren Teams, muss aber die Nachricht eines Kunden verstehen. Jev kann ein Team auswählen, die Dringlichkeit bewerten oder die Nachricht anhand einer von Ihnen definierten Skala bewerten. Ihr Code wendet dann die Routing-Regeln an. Das Modell liefert ein Urteil; es führt die Aktion nicht aus.
Jev akzeptiert derzeit Text, einschließlich JSON und Text-Arrays. Es sieht keine Bilder, hört kein Audio, generiert keine Prosa und schreibt keinen Code. Eine bildbasierte Demo benötigt zuerst eine andere Komponente, um das Bild in nutzbaren Text oder strukturierte Beobachtungen umzuwandeln.
02 / Warum ein anderes Modell entwickeln?
Das Ziel von TypeSafe ist es, dass präzise KI-Urteile wie nützliche Komponenten in gewöhnlicher Software funktionieren. Der RLCD-Trainingsansatz zielt auf Entscheidungen und kalibrierte Unsicherheit ab. Der Verzicht auf freie Textgenerierung ermöglicht eine andere Schnittstelle: Die Anwendung definiert den Antwortraum und kombiniert die Ergebnisse.
Eine gültige Ausgabeform ist kein Beweis dafür, dass die Antwort wahr ist. Bewerten Sie Fehler anhand Ihrer eigenen Beispiele und halten Sie konsequente Aktionen hinter expliziten Anwendungsregeln.
03 / Drei Arten zu fragen
- Choice
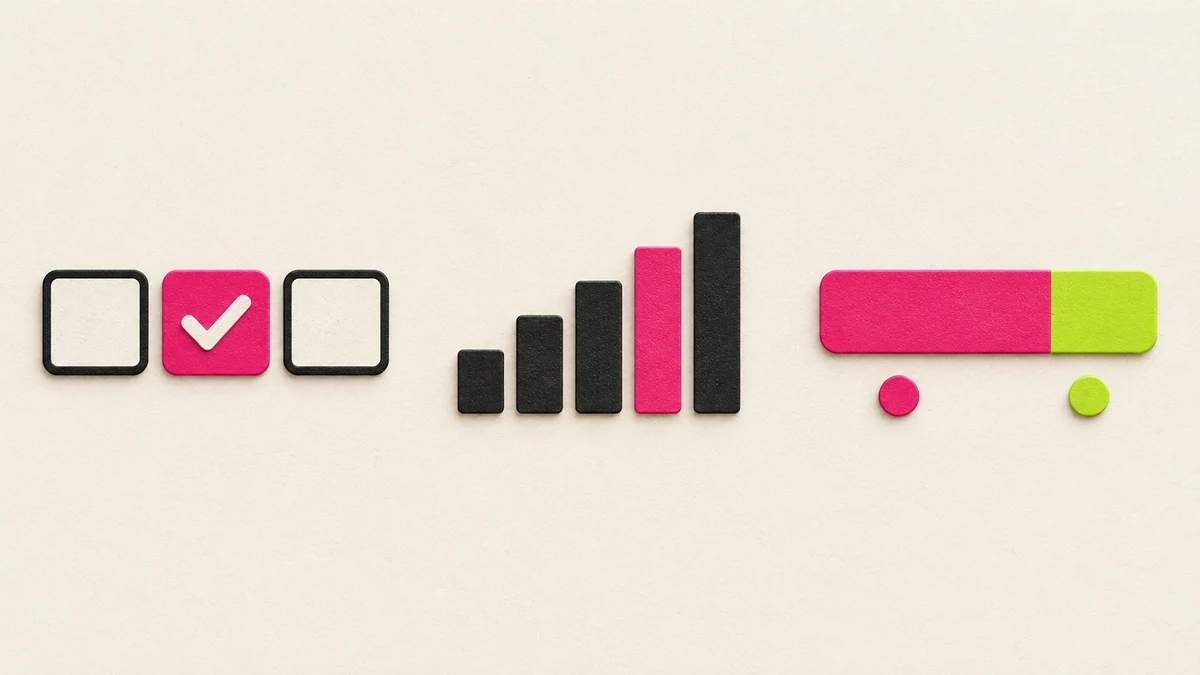
- Wählen Sie eine Option aus einer von Ihnen bereitgestellten Menge, wie z. B. Abrechnung, technischer Support oder Vertrieb. Die Antwort enthält die ausgewählte Option und eine Verteilung über die Optionen.
- Score
- Platzieren Sie eine Beobachtung auf geordneten, beschreibenden Ebenen, wie z. B. ruhig, frustriert und sehr frustriert. Der zurückgegebene Score kann zwischen den Ebenen liegen; es ist keine allgemeine Wahrscheinlichkeit für Korrektheit.
- Noul
- Fragen Sie, ob eine Aussage zutrifft. Noul gibt die Wahrscheinlichkeit für Ja zurück, von 0 bis 1. Stellen Sie separate Fragen für Labels, die gleichzeitig wahr sein können.
Unsicherheit lesen, bevor Sie handeln
Choice und Score geben Wahrscheinlichkeiten und einen separaten Konfidenzwert zurück, der aus ihrer Verteilung abgeleitet wird. Die Wahrscheinlichkeit und das Konfidenzniveau der gewinnenden Option sind unterschiedliche Zahlen. Noul hat eine Wahrscheinlichkeit, aber kein separates Konfidenzfeld.
Lehrbeispiel · feste Konfidenz 0,72
 Um Überprüfung oder mehr Kontext bitten
Verschieben Sie den Schwellenwert, um zu sehen, wie sich ein Code-Zweig ändert. Dies ist eine feste Illustration, keine Jev-Vorhersage oder ein empfohlener Schwellenwert. Testen Sie Grenzen gegen die Kosten von Fehlern; das Überschreiten des Schwellenwerts erteilt niemals die Erlaubnis zum Handeln.
04 / Jev und ein LLM erfüllen unterschiedliche Aufgaben
Dies sind Schnittstellenunterschiede, keine Behauptung, dass ein Modell jede Aufgabe gewinnt. LLM-Fähigkeiten und Latenz variieren je nach Modell, Einstellungen, Tools und Eingabe.
| Dimension | Jev | Generatives LLM |
|---|---|---|
| Ausgabe | Definierte Auswahlmöglichkeiten, Scores, Wahrscheinlichkeiten | Generierter Text oder Code; viele Modelle unterstützen auch strukturierte Ausgaben |
| Ein nützlicher Einsatzbereich | Routing, Auswahl, Ranking-Signale, begrenzte Prüfungen | Schreiben, Erklären, offenes Schlussfolgern und Generieren |
| Eingabe | Text oder strukturierter Textzustand | Text; einige Modelle akzeptieren auch Bilder, Audio oder Video |
| Wer steuert die Aktion? | Ihre Anwendung kombiniert Urteile und führt Regeln aus | Ihre Anwendung muss Ausgaben und Tool-Aktionen weiterhin validieren |
| Unsicherheit | Wahrscheinlichkeitsausgaben für kalibrierte Entscheidungen; dennoch fehleranfällig | Ein schriftlicher Vertrauensanspruch erfordert aufgabenspezifische Validierung |
05 / Schnell genug für die Interaktion
Der Startbeitrag von TypeSafe vom 15. September berichtet diesen Bereich für seine entscheidungsorientierten Aufrufe. Es wird auch darauf hingewiesen, dass die veröffentlichten Bewertungen im Allgemeinen von der US-Westküste aus durchgeführt wurden. Dies ist eine vom Anbieter gemeldete Momentaufnahme, kein JEVLAB-Benchmark oder eine Latenzgarantie für Ihren Standort.
Lesen Sie die offizielle Quelle
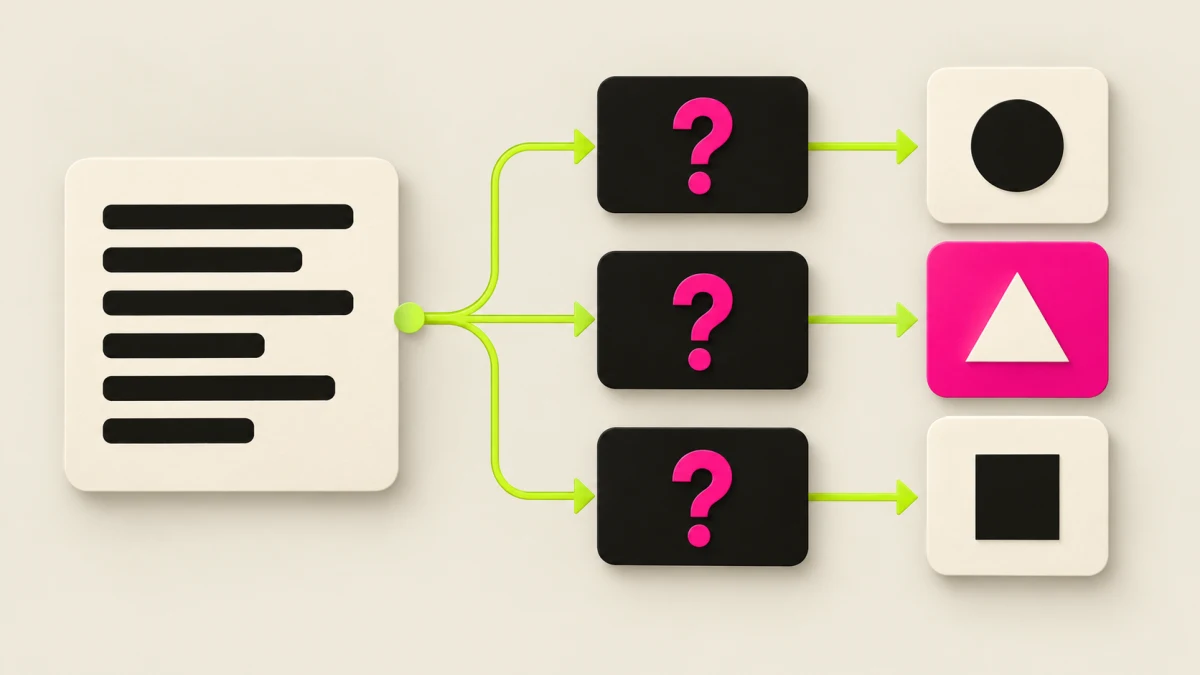
Stellen Sie unabhängige Fragen zum selben Zustand zusammen. Jev wertet sie parallel aus. Dies kann eine Kette separater Aufrufe vermeiden, aber mehr Fragen erhöhen die Eingabetoken und müssen in die Anforderungsgrenzen passen. Ein späterer Aufruf ist erforderlich, wenn eine Frage von einer früheren Antwort abhängt.
Lesen Sie die offizielle Quelle
Die Workflow-Bewertungen von TypeSafe vergleichen ganze Workflows. Ihre Referenz-Labels sind modellgenerierte Konsens-Labels, kein menschlicher Ground-Truth-Satz. Lesen Sie die Methode und testen Sie Ihre eigenen Fälle, bevor Sie eine Geschwindigkeits- oder Genauigkeitsbehauptung übernehmen.
06 / Machen Sie Ihren ersten Aufruf
- Erkunden Sie die Anfragebeispiele in unserem Decision Lab, ohne sich anzumelden. Um einen echten Modellaufruf zu starten, öffnen Sie das Playground von TypeSafe, melden Sie sich dort an und beginnen Sie mit einem kurzen Status und einer klaren Frage.
- Erstellen Sie einen API-Schlüssel in der TypeSafe-Konsole. Bewahren Sie ihn auf Ihrem Server oder in einer lokalen Umgebungsvariablen auf, niemals im Browser-Code oder in einem öffentlichen Repository.
- Rufen Sie die API direkt auf oder verwenden Sie das offizielle JavaScript- oder Python-SDK. Das folgende Beispiel ist eine illustrative Anfrage; es wird keine Anfrage von dieser Seite aus gestellt.
- Sammeln Sie repräsentative Beispiele, protokollieren Sie die Modellversion, messen Sie Fehler sowie die End-to-End-Latenz und entscheiden Sie, wann Sie handeln oder eine Überprüfung anfordern. Ein Wahrscheinlichkeits- oder Konfidenzwert ist keine Autorisierung.
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json

{
  "state": {
    "message": "I cannot sign in to my account."
  },
  "model": "jev-latest",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this message?",
      "criteria": {
        "billing": "Payments or invoices",
        "support": "Account access or technical problems",
        "sales": "Pricing or product questions"
      }
    }
  }
}Decision Lab / Die Form eines Aufrufs testen
Wählen Sie eine Aufgabe und bearbeiten Sie deren Text. Die Anfrage ändert sich sofort in Ihrem Browser. Dies sind ursprüngliche Lehrvorlagen, keine Live-Modellergebnisse; ein API-Schlüssel oder eine Anmeldung ist hier nicht erforderlich.
Choice wählt eine benannte Option aus. Beschreiben Sie jede Option klar und fügen Sie einen Ausweg für Eingaben hinzu, die nicht passen. Ihr Code entscheidet, was als Nächstes passiert.
Score verwendet geordnete, beschreibende Stufen. Das numerische Ergebnis beschreibt ein Urteil auf dieser Skala, nicht eine exakte Anzahl oder einen universellen Qualitätswert.
Noul gibt die Wahrscheinlichkeit zurück, dass eine Bedingung wahr ist. Definieren Sie die Bedingung vollständig in den Anweisungen; ein Frageschlüssel ist nur eine Bezeichnung für Ihren Code.
Die bearbeitbaren Beispiele verwenden Englisch. Sie können den Status durch Ihre eigene Sprache ersetzen; testen Sie die Genauigkeit in dieser Sprache, bevor Sie sich auf das Ergebnis verlassen.
{
  "model": "jev-latest",
  "state": "I need help signing in after changing my phone.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Choose the team that can best help with the message in state. Use other when none fits.",
      "criteria": {
        "accounts": "Sign-in or account access",
        "billing": "Charges, invoices or subscriptions",
        "other": "Another issue, or not enough information"
      }
    }
  }
}
Weiter: Senden Sie diesen Body an POST /v1/systemone mit Ihrem serverseitigen API-Schlüssel. Die Konsole und API von TypeSafe erfordern ein Anbieterkonto. JEVLAB speichert Ihren Schlüssel nicht und sendet dieses Beispiel nicht an ein Modell.
Bevor Sie veröffentlichen / Vier Dinge, die Sie richtig machen müssen
Typ-sichere Ausgabe kann trotzdem die falsche Antwort sein. Bauen Sie auf den dokumentierten Grenzen des Modells auf, nicht auf einer perfekten Demo.
Kleiner, expliziter Status
Senden Sie die relevanten Fakten mit klaren Feldnamen. Wandeln Sie Bilder oder Audio zuerst in nützlichen Text um. Langer, zusammenhangloser Kontext und indirekte Referenzen können die Genauigkeit verringern.
Fragen, die aussagen, was sie meinen
Schreiben Sie die vollständige Bedingung in die Anweisungen, nicht nur in einen Frageschlüssel. Vermeiden Sie sich überschneidende Auswahlmöglichkeiten und widersprüchliche Kriterien. Trennen Sie unabhängige Urteile; kombinieren Sie diese im Code.
Exakte Arbeit im Code behalten
Verwenden Sie Code für Arithmetik, Zählen, Datumsvergleiche und Berechtigungsprüfungen. Verwenden Sie ein generatives Modell, wenn Sie neue Prosa oder Code benötigen. Jev wählt oder urteilt innerhalb des von Ihnen definierten Raums.
Messen Sie Ihren eigenen Arbeitsablauf
Verwenden Sie beschriftete Beispiele, einschließlich mehrdeutiger, mehrsprachiger und kontradiktorischer Fälle. Verfolgen Sie falsche Entscheidungen, die Fallback-Rate, die End-to-End-Latenz und die Eingabenutzung. Protokollieren Sie die zurückgegebene Modellversion; Aliase können sich ändern.
Lesen Sie die dokumentierten Jev 1.13 Fehlerquellen
Ihre Checkliste für den ersten Build
Abgehakte Schritte bleiben nur in diesem Browser. Es werden kein Konto, keine Synchronisierung und keine Fortschrittsverfolgung an JEVLAB gesendet.
Rezepte zum Weiterentwickeln
- Intent-Routing
Wählen Sie zwischen Handlern, mit einem expliziten Fallback für Anfragen außerhalb ihres Bereichs.
- Parallele Fragen
Stellen Sie unabhängige Fragen zum selben Status gleichzeitig; behandeln Sie Abhängigkeiten in einem späteren Schritt.
- Zusammengesetzte Bewertung
Beurteilen Sie separate Dimensionen und kombinieren Sie deren Werte dann mit Gewichten, die Sie im Code steuern.
- Konfidenz-Routing
Wählen Sie mithilfe getesteter Schwellenwerte, ob Sie fortfahren, mehr Kontext sammeln oder um eine Überprüfung bitten möchten.
07 / Ihr Startregal
Halten Sie diese Referenzen griffbereit. Die offizielle Dokumentation definiert die API; Community-Projekte zeigen mögliche Anwendungen, keine Garantien.
 Schnellstart
- Einführung von System One Modellen & Jev
- Das TypeSafe-Manifest
- Konfidenz verstehen
- Modelle, aktuelle Preise & Limits
- Workflow-Evaluierungen & Methodik
Aus der JEVLAB-Sammlung
- typesafe-sdk-cpppewriebontal
- go-jevmattn
- jev-cookbookparamjeetn
- typesafe-sdk-rustzchee
- system-oneasynq-io
- jev-netbrightshore
Erkunden Sie die Quellbibliotheken
- Made with Jev
Erklärungen und praktische Builds, mit einem Leitfaden zur Trennung von Generierung, Entscheidungen und Ausführung.
- Jevable
Ein visueller Stream von Community-Demonstrationen. Sehen Sie sich das Original an und untersuchen Sie, was jede Demo tatsächlich an Jev sendet.
- Awesome Jev
Ein breiter Index, der offizielle Ressourcen, Community-SDKs und Projektkategorien trennt. Überprüfen Sie das ursprüngliche Repository, bevor Sie ein Tool übernehmen.
Dies sind unabhängige Entdeckungsquellen. Die Aufnahme in ein Verzeichnis ist keine Prüfung oder Empfehlung durch JEVLAB.
Fragen, die es wert sind, gestellt zu werden
Ist Jev ein Chatbot oder ein Coding-Agent?
Jev ist ein Entscheidungsmodell, das von Software aufgerufen werden kann. Ein Coding-Agent kann Ihnen beim Aufbau dieser Software helfen, und ein Sprachmodell kann Text darin schreiben. Dies sind unterschiedliche Rollen.
Kann Jev ein Video oder einen Screenshot sehen?
Die dokumentierte API akzeptiert derzeit Text. Eine Demo verwendet möglicherweise ein separates Vision-Modell, Transkription, DOM oder Spielstatus, um den Text vorzubereiten, den Jev bewertet. Überprüfen Sie die gesamte Pipeline, wenn Sie Geschwindigkeit und Kosten vergleichen.
Kann ich ohne Konto starten?
Alles in diesem JEVLAB-Leitfaden und Decision Lab ist ohne Anmeldung verfügbar. Echte API-Aufrufe und das offizielle TypeSafe Playground erfordern einen TypeSafe-Zugang und gegebenenfalls einen Schlüssel.
Bedeutet ein schneller Benchmark, dass meine Anwendung schnell sein wird?
Messen Sie von der Eingabe bis zum Ergebnis, das Ihr Benutzer sieht. Netzwerk, Vorverarbeitung, Tool-Ausführung, Wiederholungsversuche und Fallbacks kosten ebenfalls Zeit. Veröffentlichte Anbieterbewertungen und Demos der Ersteller beschreiben ihre eigenen Setups.
08 / Wie man JEVLAB benutzt
JEVLAB ist ein unabhängiger, quellenverknüpfter Feldführer. Es wird nicht von TypeSafe AI betrieben und ist nicht mit diesem verbunden. Die Landingpage dient der Entdeckung von Arbeiten; dieser Leitfaden dient dem Verständnis.
„Explore“ öffnet die Sammlung. Suchen Sie nach Projekt, Ersteller oder Thema und grenzen Sie die Ergebnisse mit Anwendungsfall- und Plattformfiltern ein. Die Desktop-Seitenleiste scrollt unabhängig. „Popular“ mischt die Ressourcen bei einem neuen Besuch; „Latest“ zeigt neu hinzugefügte Ressourcen zuerst an. In beiden Modi werden einzelne Unterstützer-Karten aus Projekten innerhalb ihres 90-Tage-Zeitraums mit einem positiven bestätigten Nettobetrag gezogen, proportional zu diesem Gesamtwert. Projekte mit 0 USD werden nicht ausgewählt. Ein Projekt wird erst wieder gezogen, wenn alle berechtigten Projekte einmal an der Reihe waren, dann beginnt eine neue Runde.
GitHub- und Website-Karten führen mit ihrer Vorschau, gefolgt von unterschiedlichen Textlayouts. Videos behalten ihre breitere Darstellung bei. Wenn eine Quelle eine unterstützte öffentliche Metrik anzeigt, steht ein Auge für Aufrufe und ein Stern für GitHub-Sterne zum Zeitpunkt der Erfassung; beides ist kein JEVLAB-Klickzähler. Fehlende Metriken bleiben leer.
Öffnen Sie eine Karte für die Quellennotizen, den Originallink und die Speichersteuerung. Übersetzungen sind Lesehilfen; prüfen Sie das Original des Erstellers auf Kontext, aktuelle Anweisungen und Leistungsansprüche.
Unterstützer teilen sich eine weltweite Tafel. Der Streifen zeigt die Top Ten und die Seitenleiste die Top Five. Einzelne Karten zwischen den Ressourcen werden aus jedem Projekt innerhalb seines 90-Tage-Zeitraums mit positivem bestätigtem Netto-Support gezogen, einschließlich Projekten außerhalb der Top Ten und 1-USD-Beiträgen, mit Chancen proportional zum bestätigten Netto-Support des aktuellen Zeitraums und ohne Wiederholungen innerhalb einer Runde. Öffnen Sie die „Ehrentafel der Unterstützer“, um den aktuellen 90-Tage-Gesamtwert jedes Projekts zu sehen. Abgelaufene Projekte verbleiben mit 0 USD am Ende ohne Platzierungen zur Anerkennung oder Auswahlchancen; neuer bestätigter Support für dieselbe URL startet einen neuen Zeitraum und einen neuen Gesamtwert ab null. Um einen Beitrag zu leisten, suchen Sie die Projekt-URL, kopieren Sie die Nachricht und nutzen Sie „Weiter mit Buy Me a Coffee“; fügen Sie die Nachricht vor der Zahlung in die Kasse ein. Der Support bestimmt die Positionen auf der Tafel und die Chancen auf ein früheres Erscheinen im Feed, nicht die redaktionelle Qualität. Impressionen sind nicht garantiert.
Live schätzt die zuletzt aktiven Besucher. Total Visits summiert tägliche Besuche aller Sprachen und zählt keine eindeutigen Personen über die gesamte Laufzeit. Öffentliche Besuchs- und externe Klickzahlen enthalten Startwerte des Betreibers sowie danach gemessene Ereignisse.
Quellen geprüft am 22. September 2026. Illustrationen sind erklärende JEVLAB-Grafiken. Übersetzungen sind KI-gestützt; offizielle Quellen bleiben maßgeblich für aktuelle API-Details.