
 Zgłoś materiał


 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe

 Русский
 Wróć do laboratorium
 JEVLAB NEWS Research & data
SpaceXAI wprowadza Grok 4.7
AI-assisted summaries and translations. Check original sources for context and performance claims.
SpaceXAI udostępniło model Grok 4.7, kładąc nacisk na ulepszone kodowanie i uczenie przez wzmacnianie w długotrwałych zadaniach. Choć model wykazuje lepszą efektywność kosztową i wydajność w pracy biurowej, ogólny wzrost jego możliwości intelektualnych jest oceniany jako umiarkowany.
Przetłumaczone podsumowanie · AI-assisted; check the original.
 Przetłumaczone podsumowanie · AI-assisted; check the original.

Cały wątek w skrócie
Własne podsumowania powiązanych wpisów CHOI z pomocą AI. Zdjęcia i filmy należą do ich twórców. Twierdzenia źródła nie zostały niezależnie zweryfikowane.
Premiera Grok 4.7
SpaceXAI ogłosiło wydanie Grok 4.7, dostępnego w Cursor, Grok Build oraz przez API.
Nowości techniczne
Wersja 4.7 wprowadza większy model bazowy i koncentruje się na uczeniu przez wzmacnianie w zadaniach wymagających długiego czasu przetwarzania.
Ocena wydajności
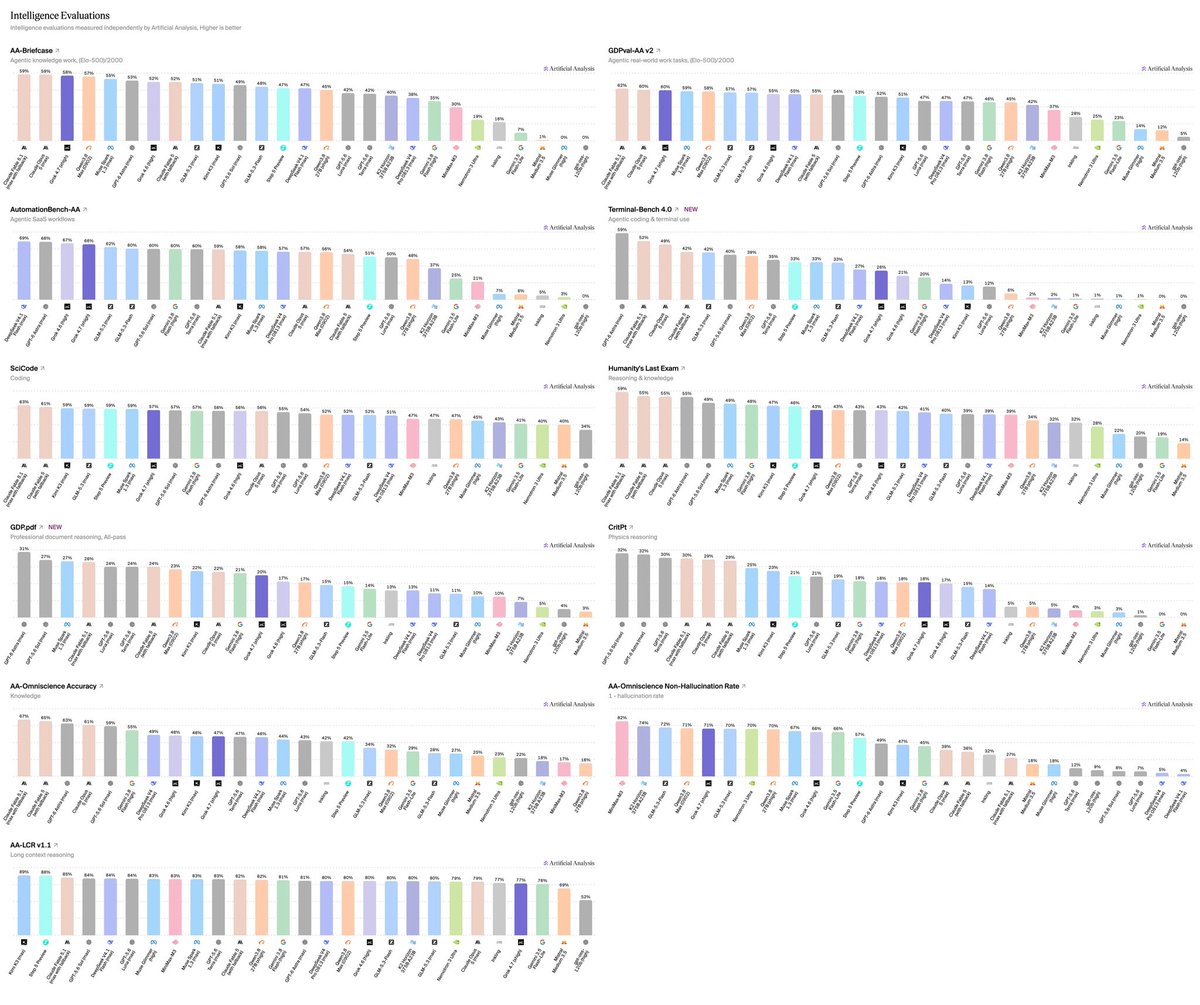
Według Choi, Grok 4.7 uzyskał 46 punktów w indeksie Artificial Analysis, co stanowi niewielki wzrost względem 44 punktów wersji 4.6.
Tokeny i czas
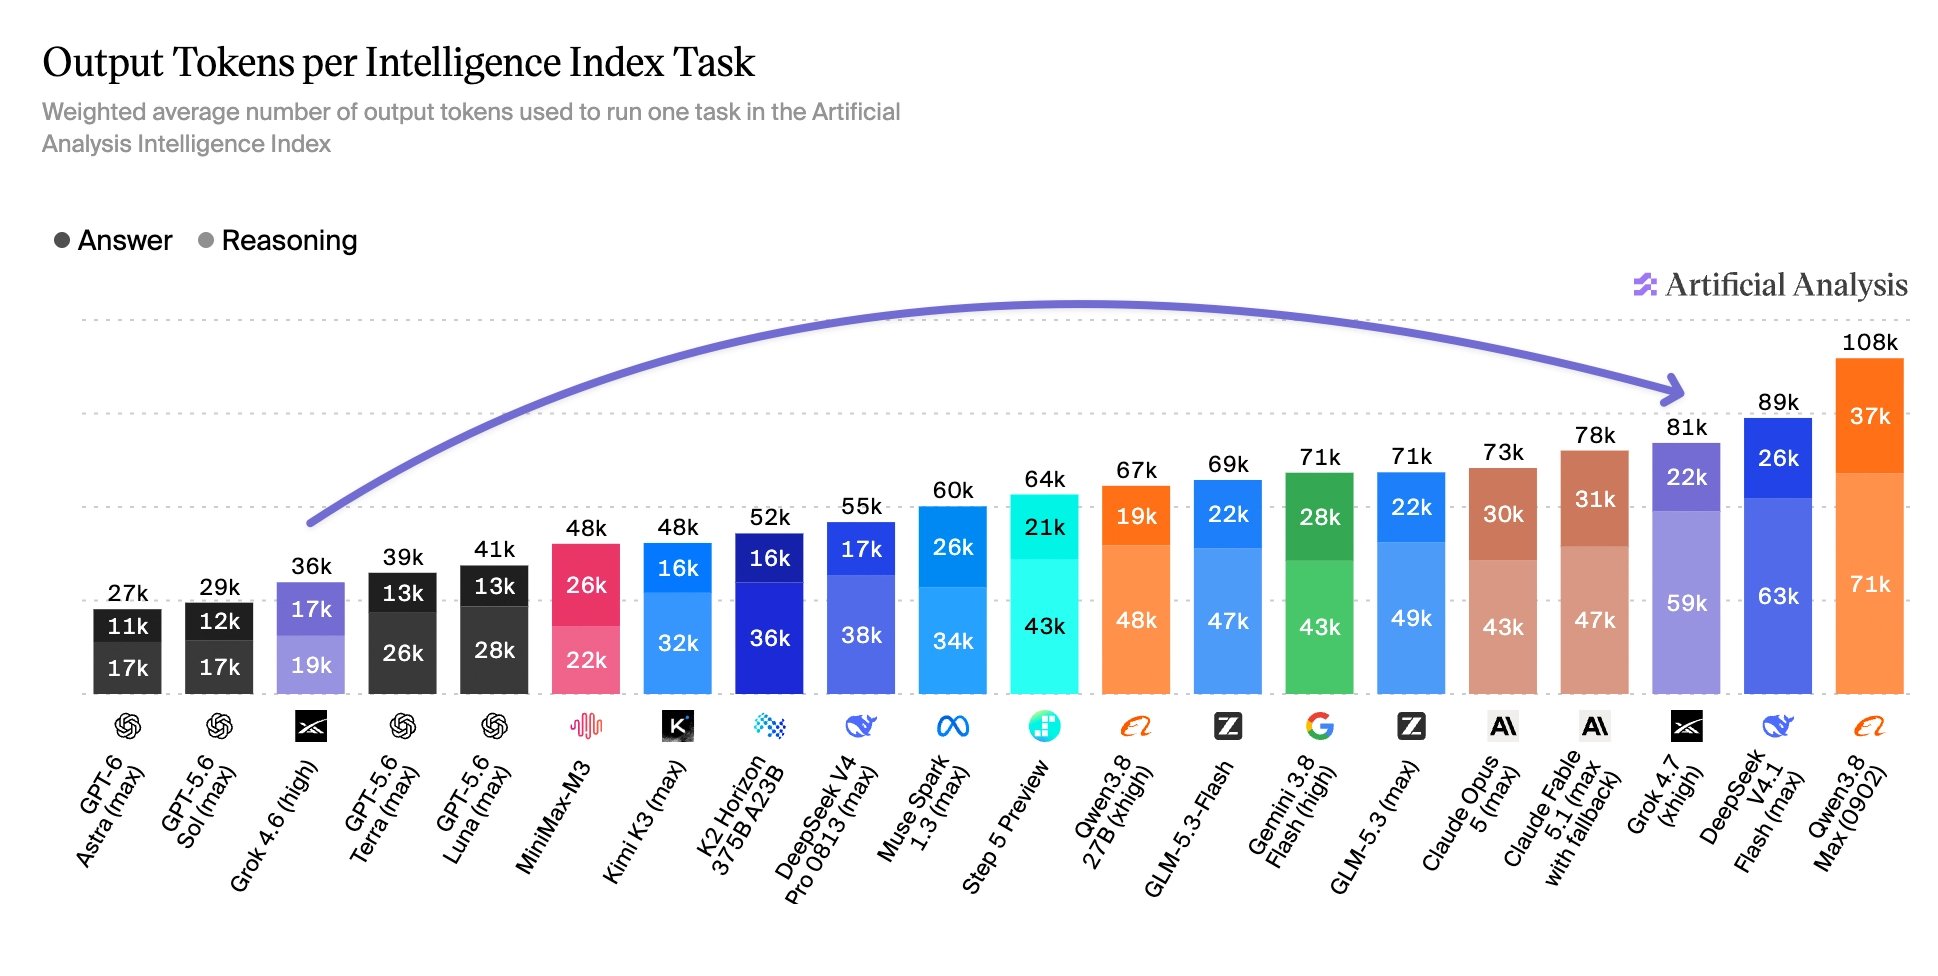
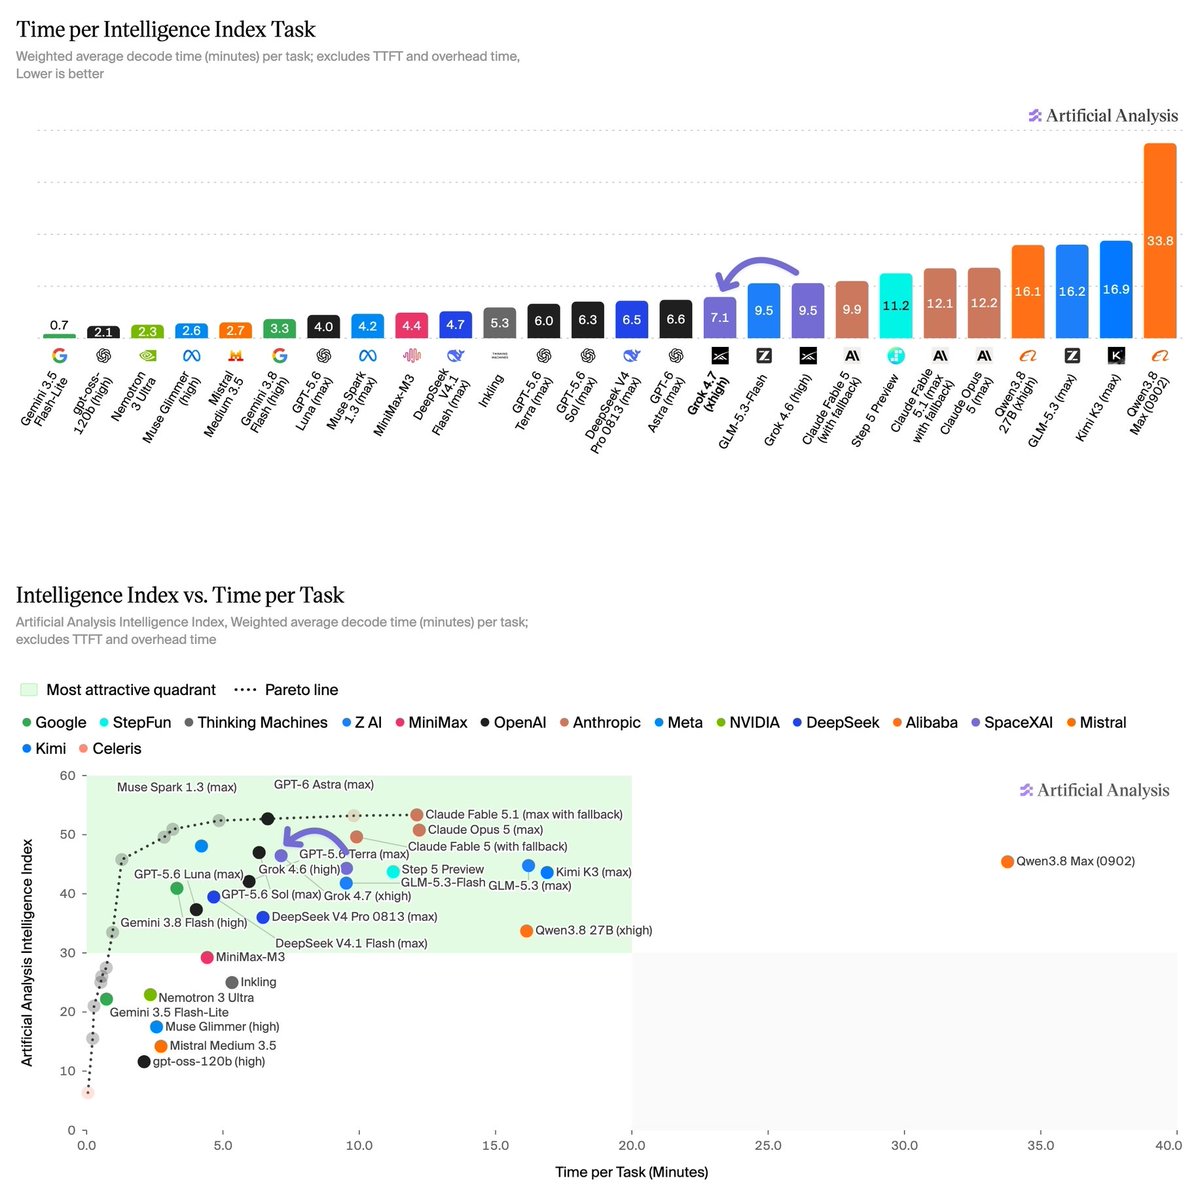
Liczba tokenów wyjściowych wzrosła o 125%, podczas gdy czas generowania skrócił się z 9,5 do 7,1 minuty.
Praca z dokumentami
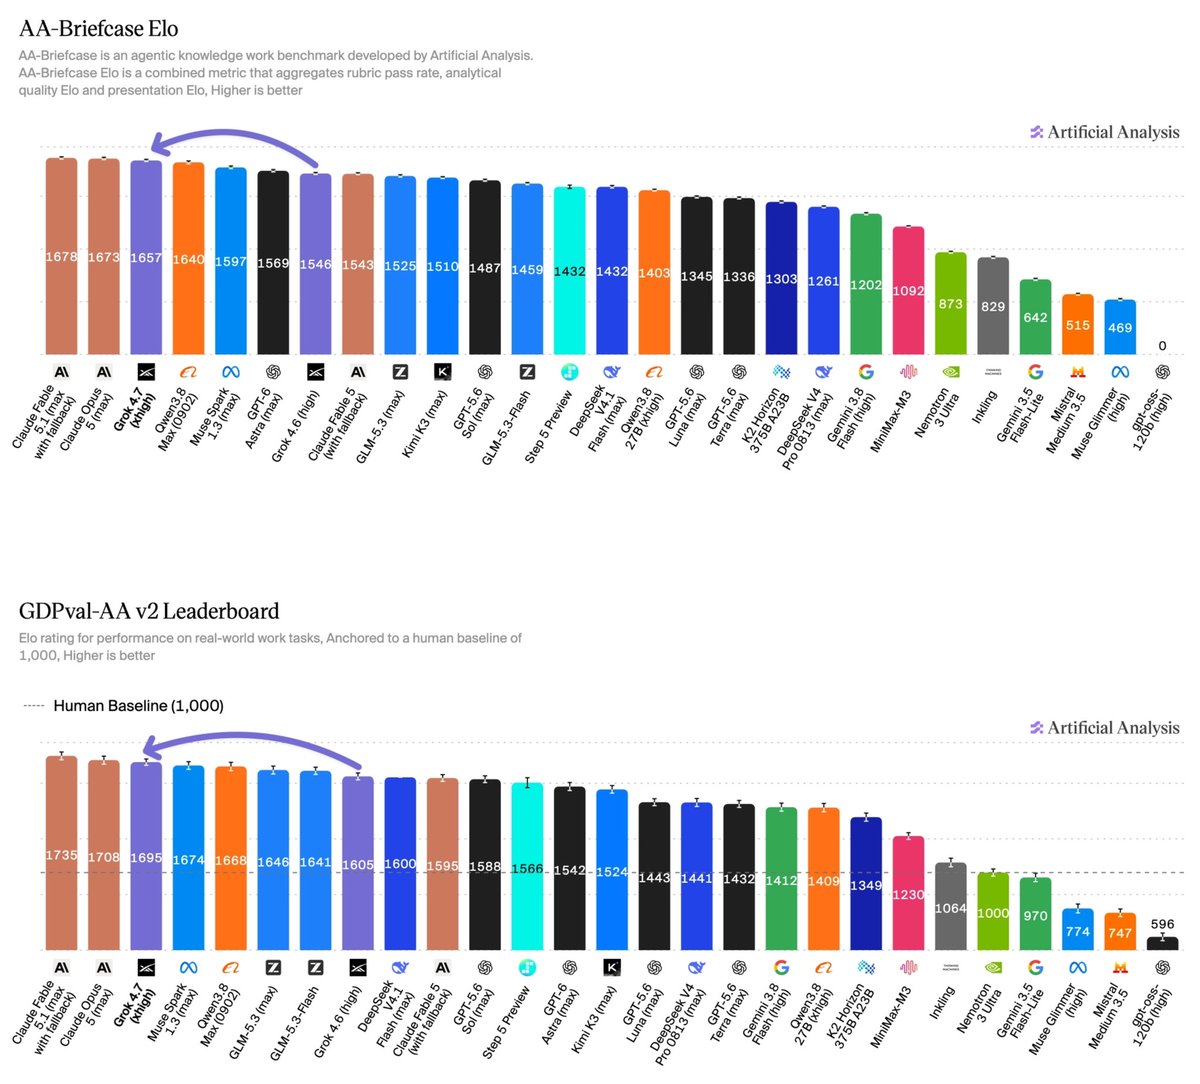
Model znacząco poprawił wyniki w analizie dokumentów, choć jakość prezentacji wyników końcowych nieznacznie spadła.
Zdolności programistyczne
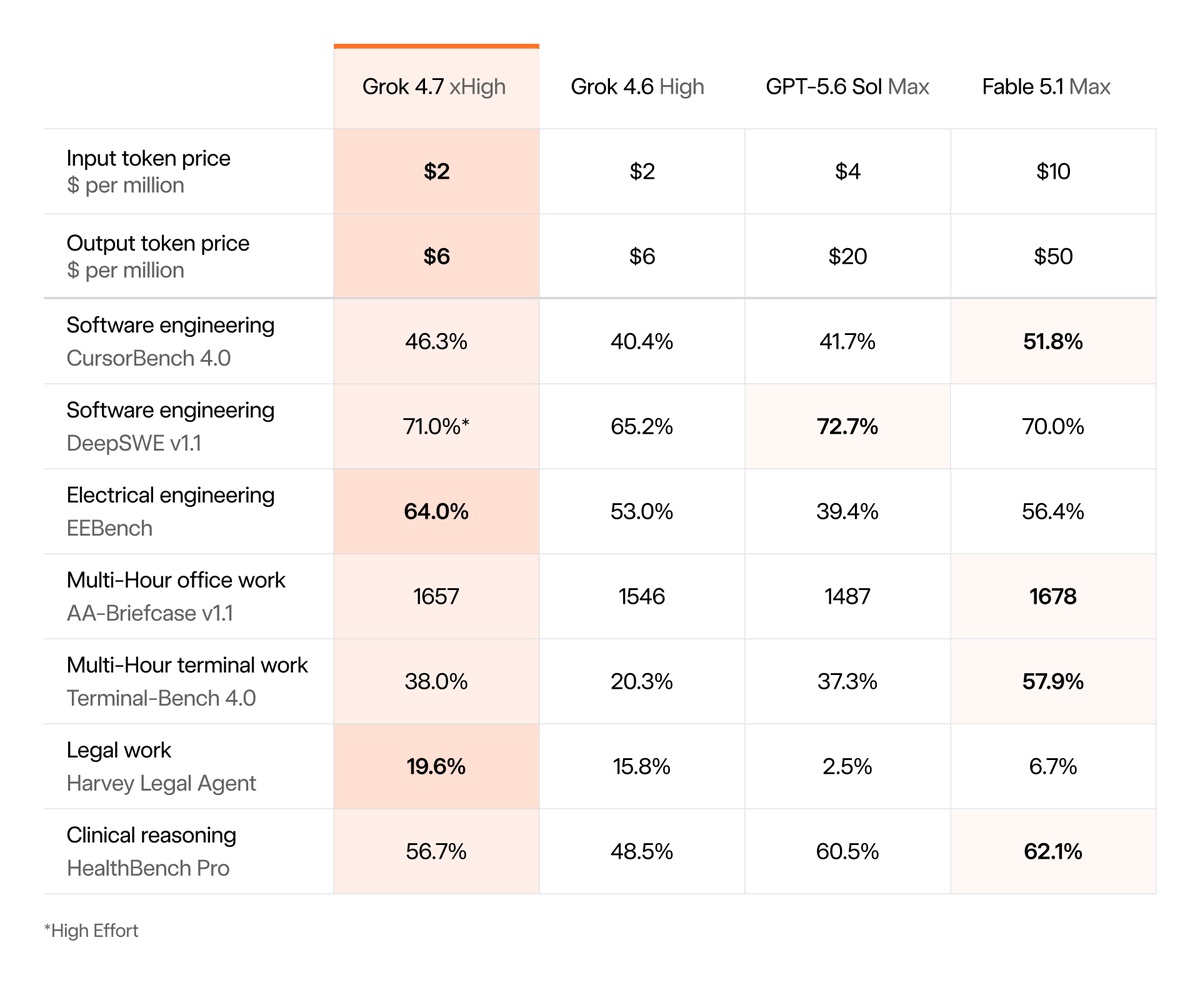
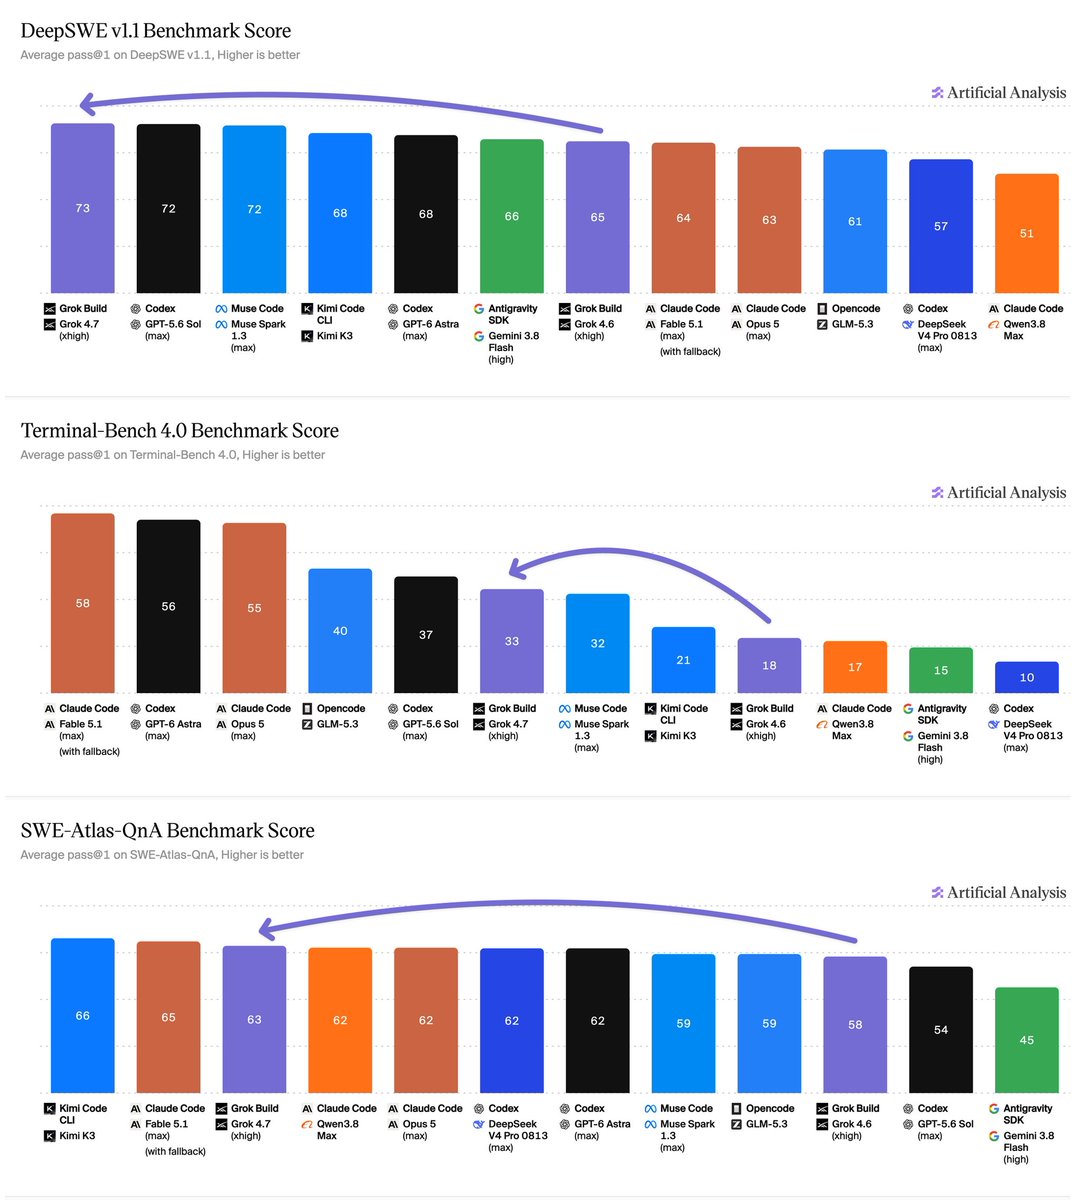
Indeks agenta kodującego wzrósł z 47 do 56 punktów, co pozwoliło wyprzedzić GPT-5.6 Sol i zająć czwarte miejsce w rankingu.
Pozostałe obszary
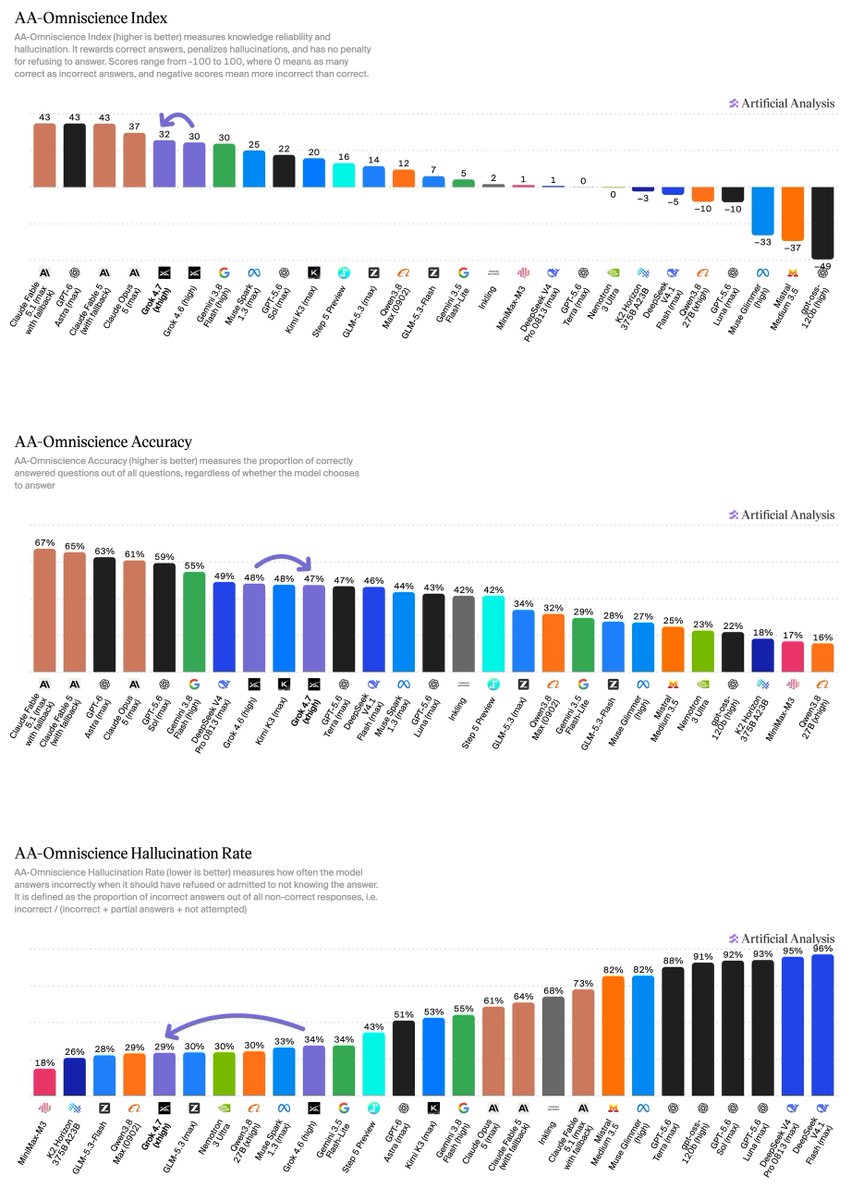
Wskaźniki dotyczące długiego kontekstu i wiarygodności wiedzy pozostały na zbliżonym poziomie do poprzedniej wersji.
Koszty API
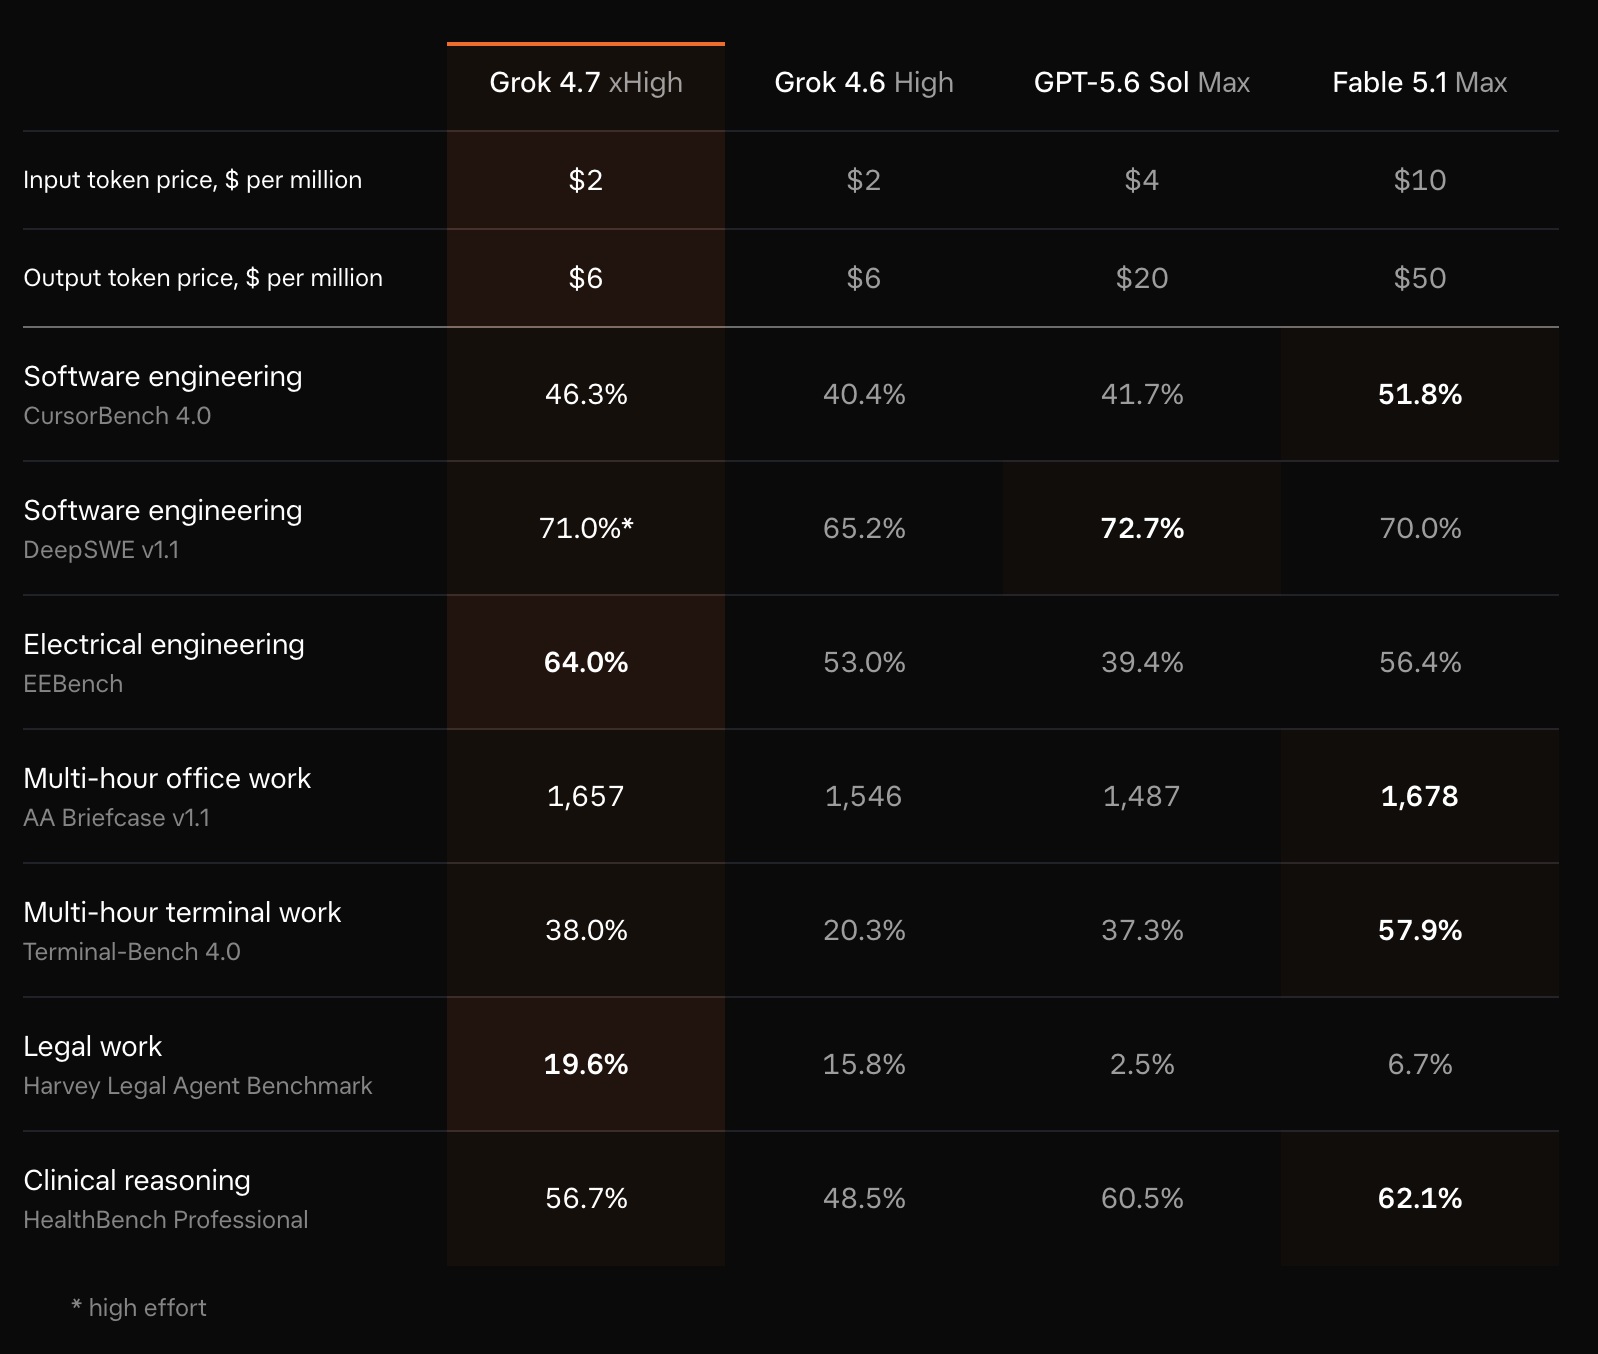
Grok 4.7 utrzymuje ceny z wersji 4.6, oferując konkurencyjne stawki w porównaniu do modeli takich jak Opus 5 czy Fable 5.1.
Efektywność kosztowa
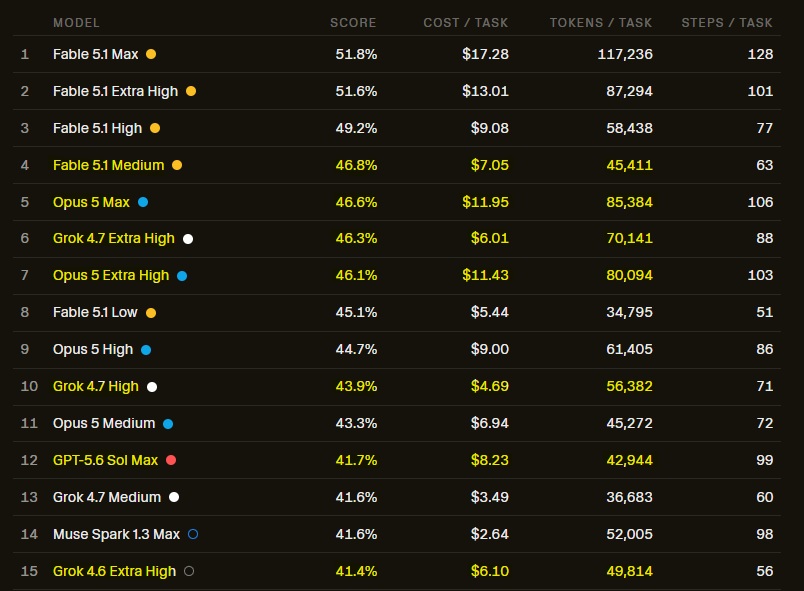
Testy CursorBench wskazują, że Grok 4.7 wykonuje zadania przy niższych kosztach niż Fable 5.1 przy zachowaniu zbliżonej wydajności.
Podsumowanie
Choi zauważa, że choć postęp w kodowaniu jest widoczny, ogólny wzrost inteligencji modelu jest mniejszy niż oczekiwano.
Źródło
Szczegółowe informacje o aktualizacji znajdują się na stronie xAI.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-21
- Discovered via
- www.threads.com
Top 10
Płatna reklama
- 01Wallpets 86 kliknięcia$125
- 02Walltank 106 kliknięcia$85
- 03Chowder 55 kliknięcia$50
- 04Falconer 47 kliknięcia$45
- 05Lemonpod 87 kliknięcia$40
- 06Menta 33 kliknięcia$35
- 07Sway 30 kliknięcia$30
- 08Peon-Ping 27 kliknięcia$25
- 09Zeron 89 kliknięcia$20
- 10Guideless 22 kliknięcia$15