
 Fund einreichen


 English
 한국어
 日本語
 Español
 Français

 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Zurück zum Labor
 JEVLAB NEWS Research & data
SpaceXAI veröffentlicht Grok 4.7
AI-assisted summaries and translations. Check original sources for context and performance claims.
SpaceXAI hat Grok 4.7 eingeführt, das durch verstärktes Reinforcement Learning bei komplexen Aufgaben und Programmierung überzeugt. Trotz spezifischer Verbesserungen bei der Dokumentenanalyse bleibt der allgemeine Intelligenzzuwachs hinter den Erwartungen zurück.
Übersetzte Zusammenfassung · AI-assisted; check the original.
 Übersetzte Zusammenfassung · AI-assisted; check the original.

Der gesamte Thread auf einen Blick
Eigene KI-gestützte Zusammenfassungen der zusammenhängenden Beiträge von CHOI. Bilder und Videos gehören ihren Urhebern. Aussagen wurden nicht unabhängig überprüft.
Grok 4.7 Start
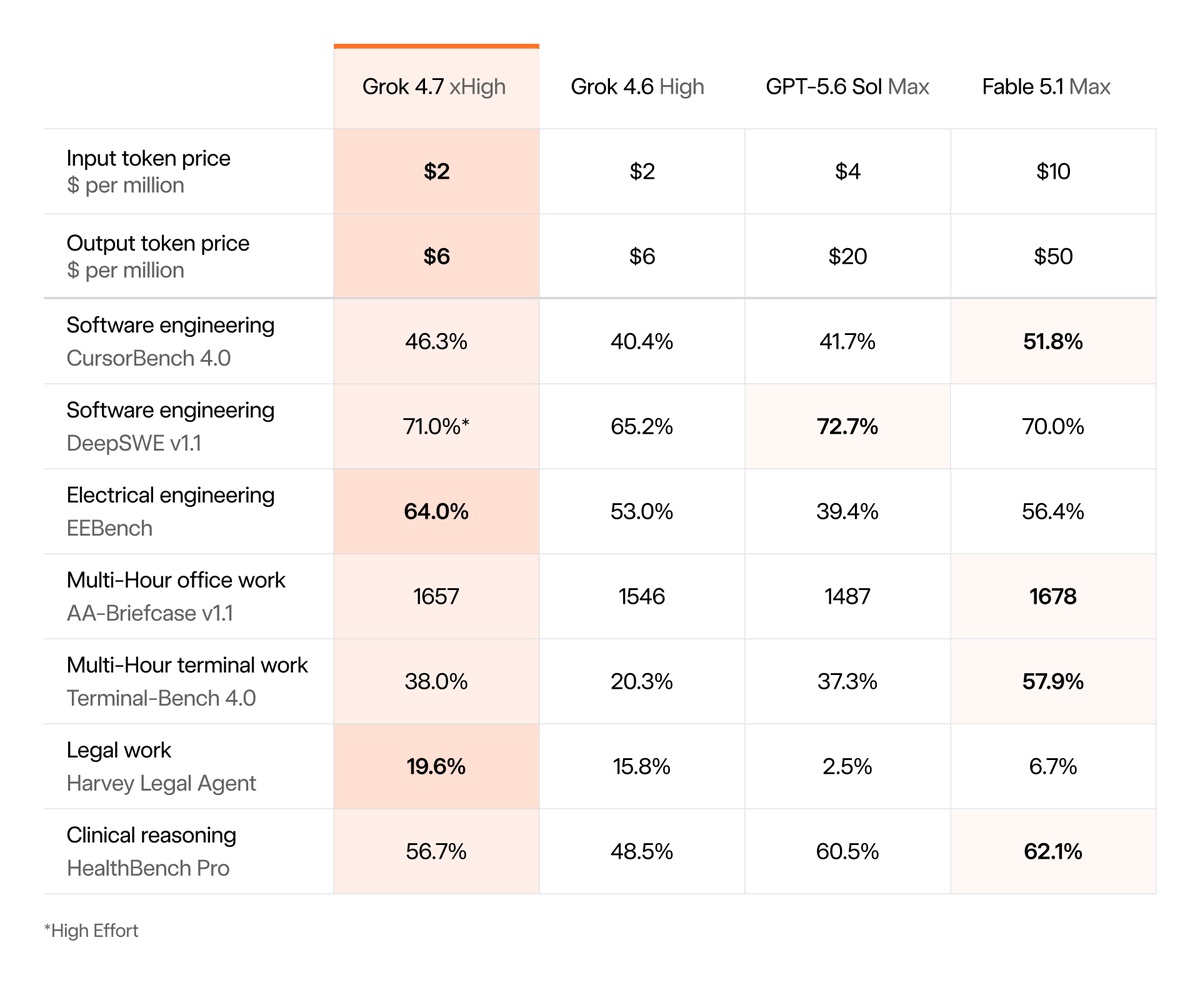
SpaceXAI hat die Veröffentlichung von Grok 4.7 bekannt gegeben, das ab sofort über Cursor, Grok Build und die API verfügbar ist.
Technische Ausrichtung
Das Modell nutzt ein größeres Basismodell und fokussiert sich auf langwierige Aufgaben durch intensives Reinforcement Learning. Eine Demo zeigt zudem detailliertere grafische Darstellungen.
Benchmark-Ergebnisse
Laut Artificial Analysis erreicht Grok 4.7 einen Wert von 46 Punkten, was einer leichten Steigerung gegenüber der Version 4.6 entspricht. Führende Modelle erreichen jedoch deutlich höhere Werte.
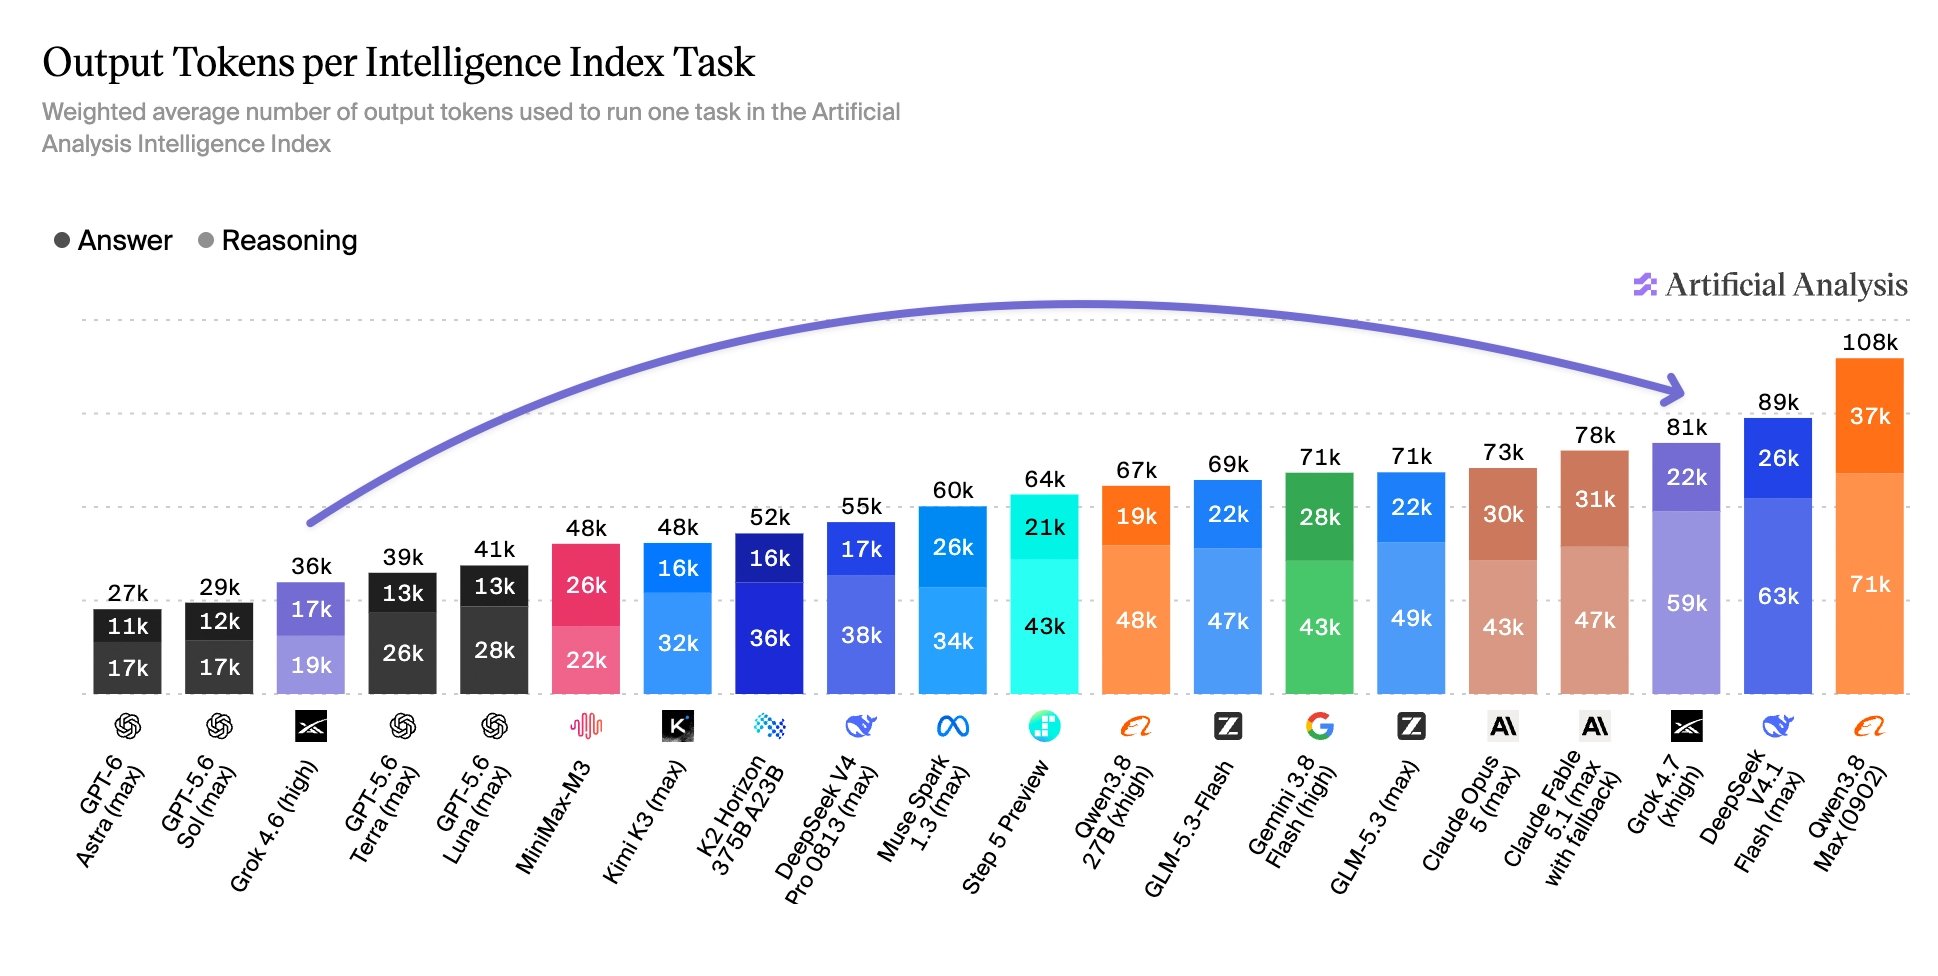
Token-Verbrauch
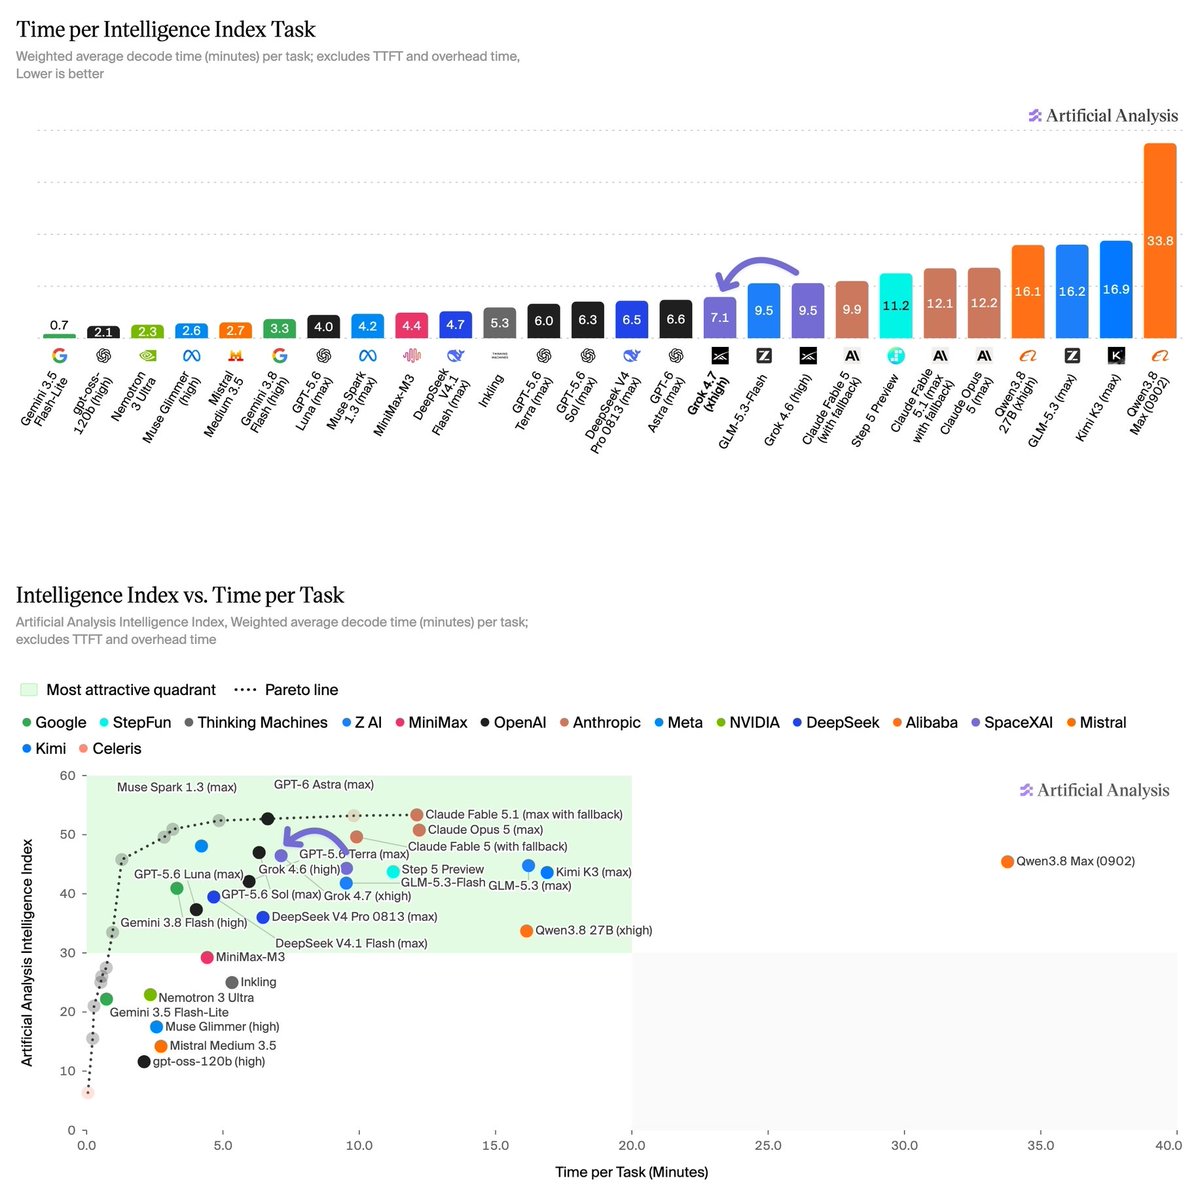
Der Token-Verbrauch pro Aufgabe stieg um 125 % auf 81.000, während die reine Generierungszeit auf 7,1 Minuten sank. Die Kosten steigen proportional zum erhöhten Token-Ausstoß.
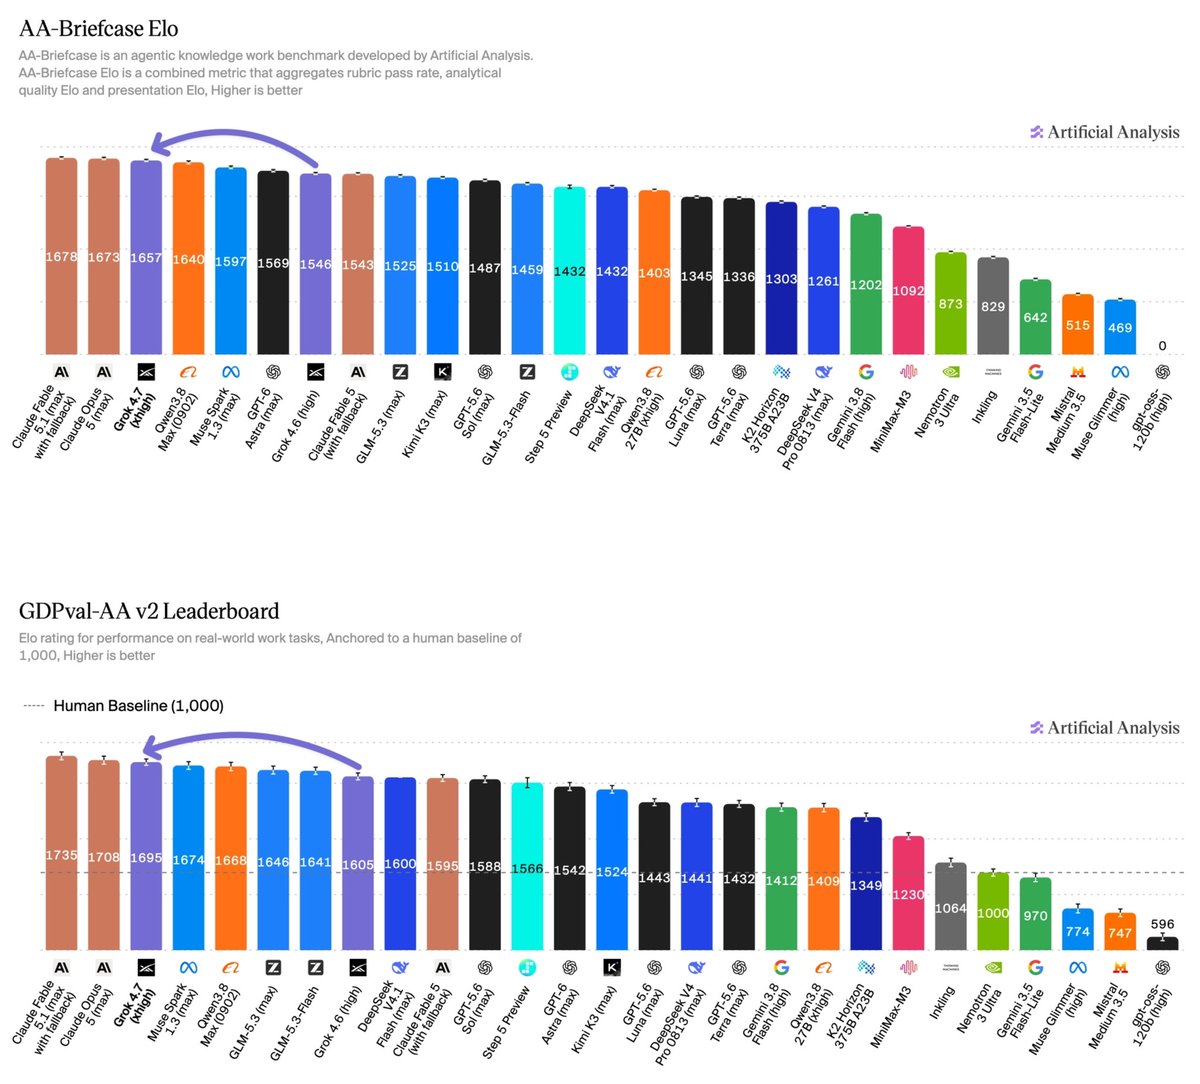
Dokumentenanalyse
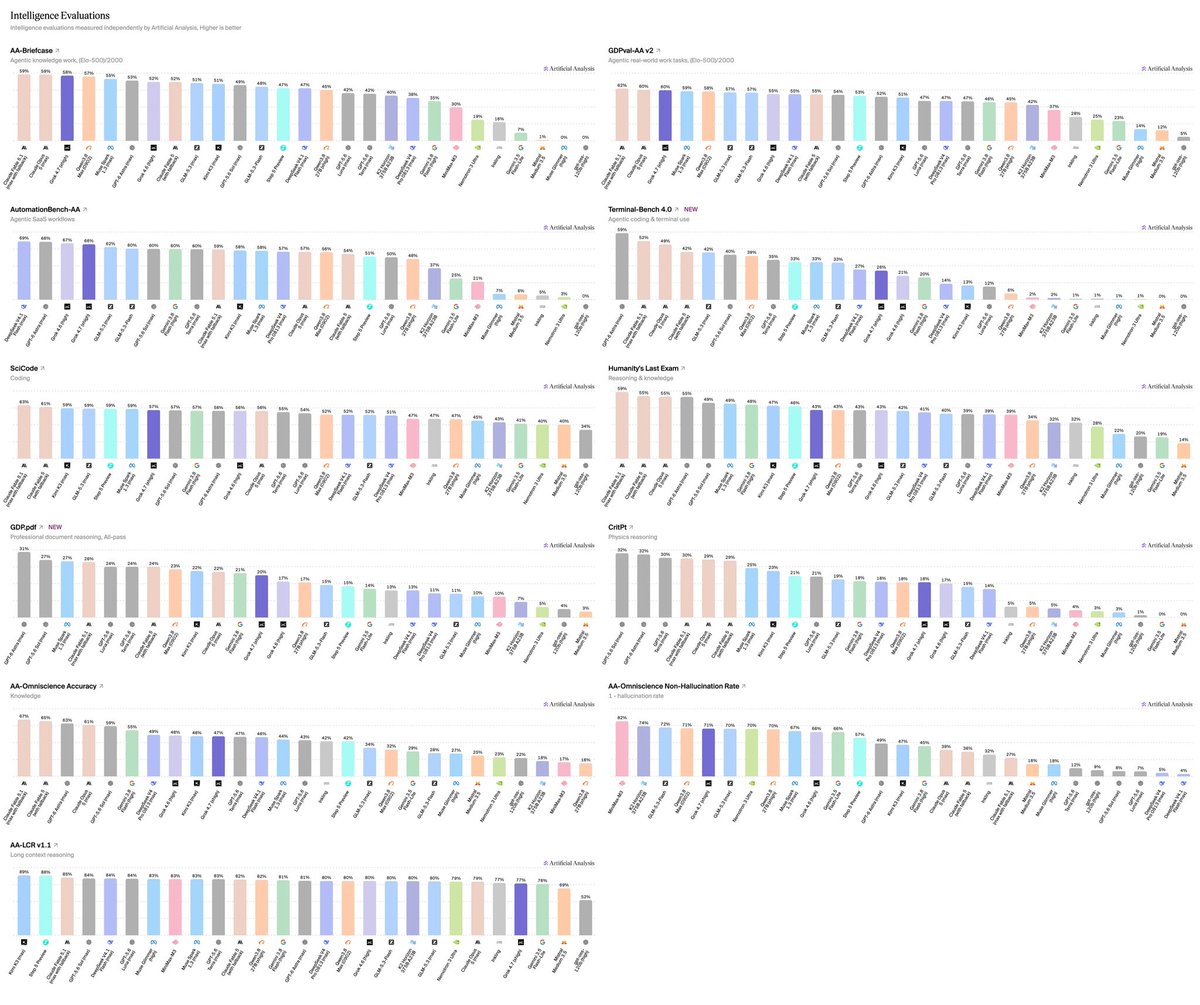
Bei komplexen Büroaufgaben erzielte das Modell deutliche Fortschritte. Während die Analysequalität stark zunahm, sank die Qualität der Ergebnisdarstellung leicht.
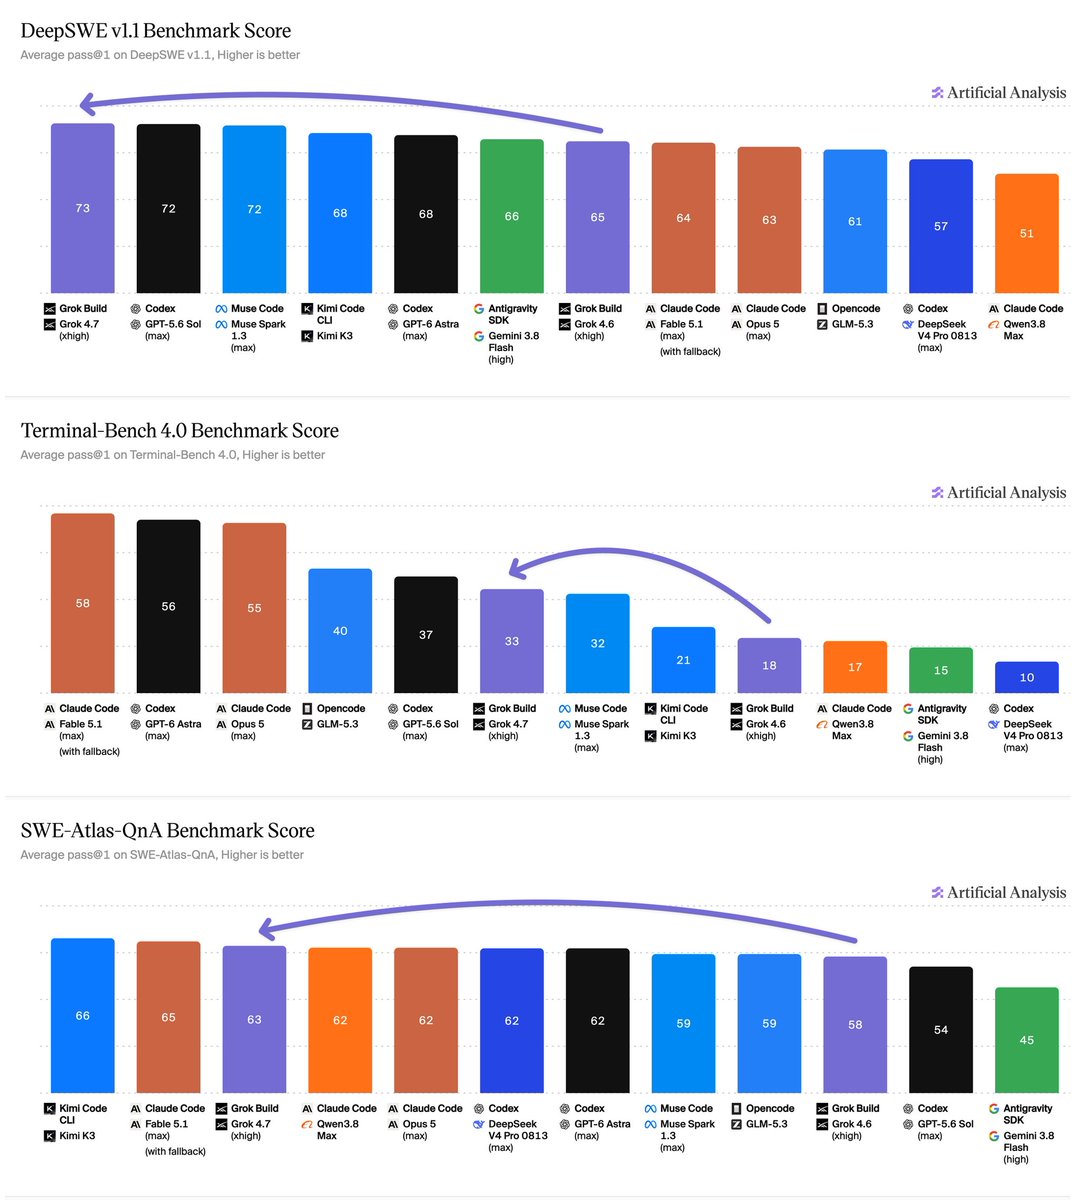
Coding-Agent-Leistung
Die Leistung als Coding-Agent stieg von 47 auf 56 Punkte. Grok 4.7 übertrifft damit GPT-5.6 Sol und zeigt Verbesserungen in allen Teilbereichen.
Stagnation in Teilbereichen
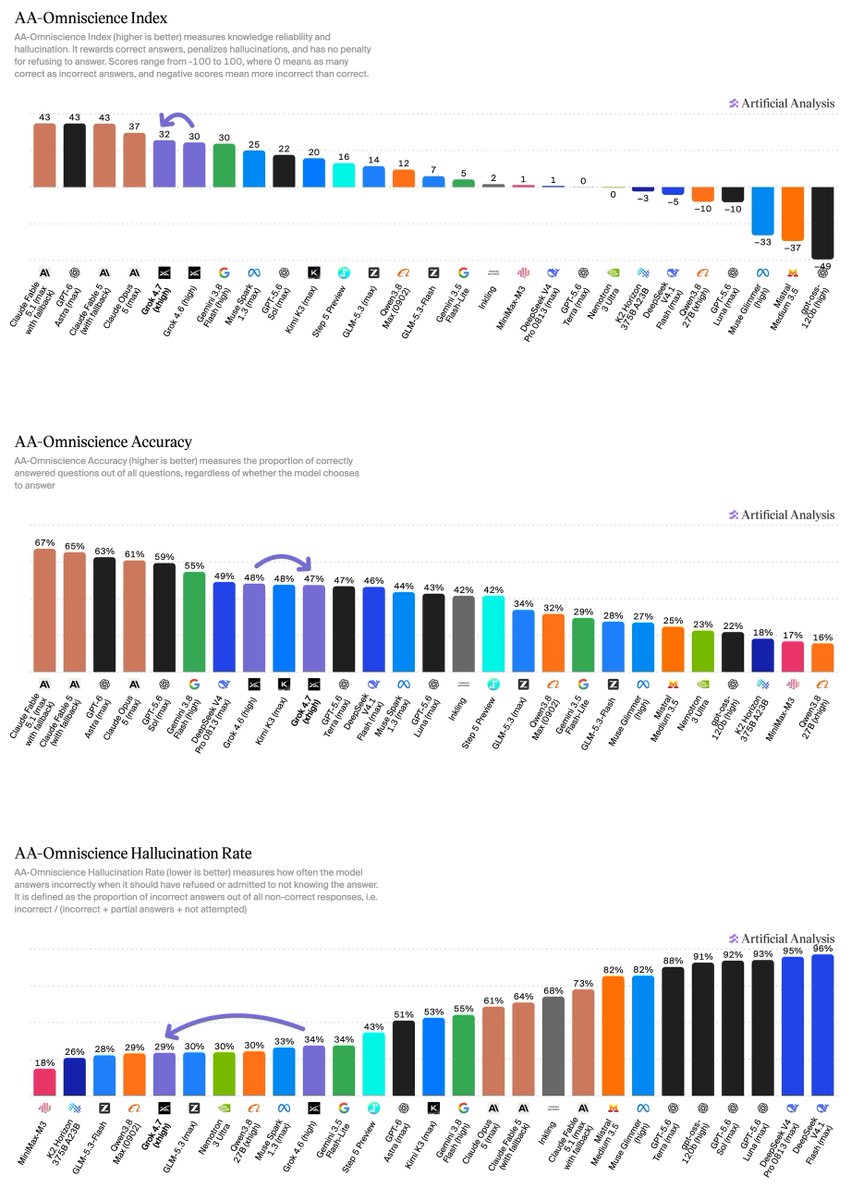
In anderen Bereichen wie dem langen Kontext-Raisonnement gab es kaum Fortschritte oder leichte Rückgänge. Die Halluzinationsrate sank zwar, die Genauigkeit blieb jedoch stabil.
API-Preisgestaltung
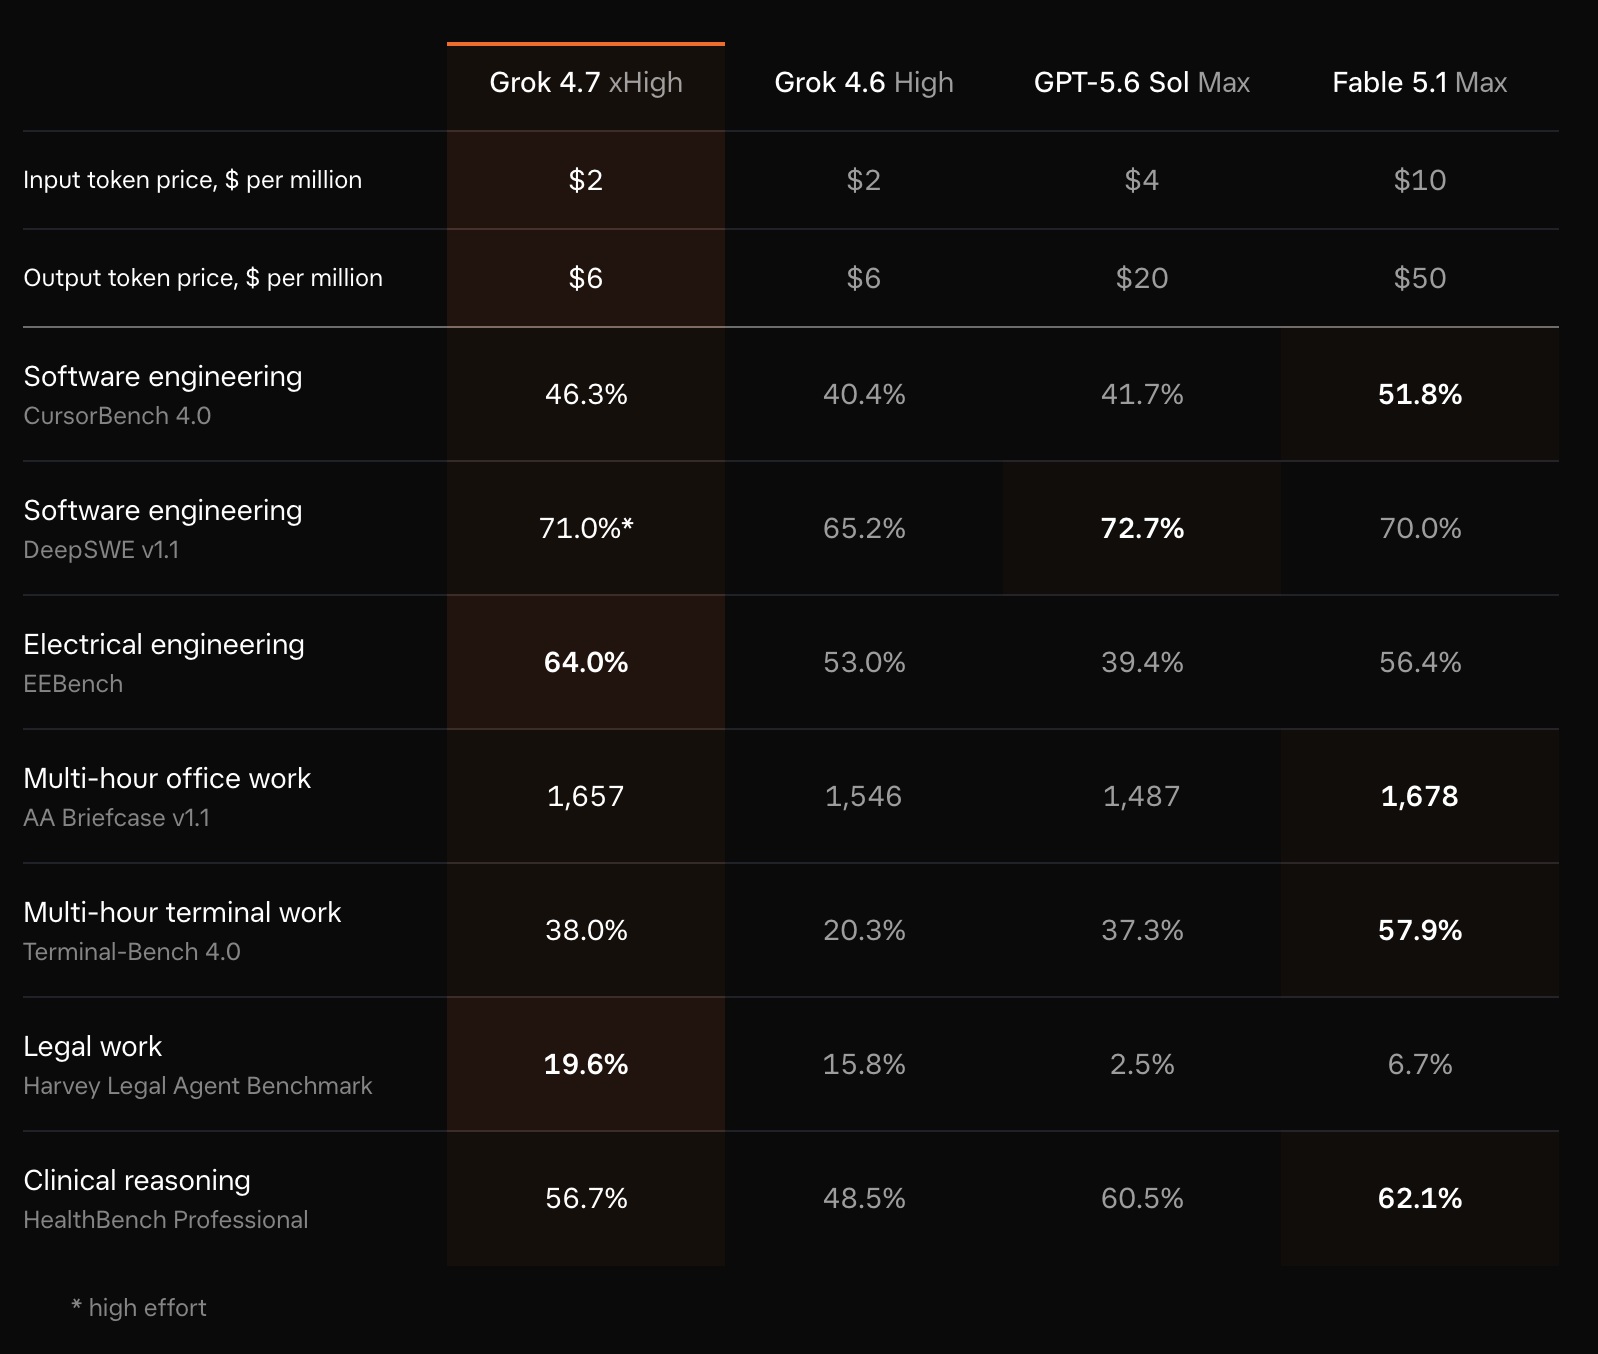
Grok 4.7 behält die Preisstruktur bei und bietet mit 2 $ (Input) und 6 $ (Output) pro Million Token ein wettbewerbsfähiges Preis-Leistungs-Verhältnis.
Kosten-Nutzen-Analyse
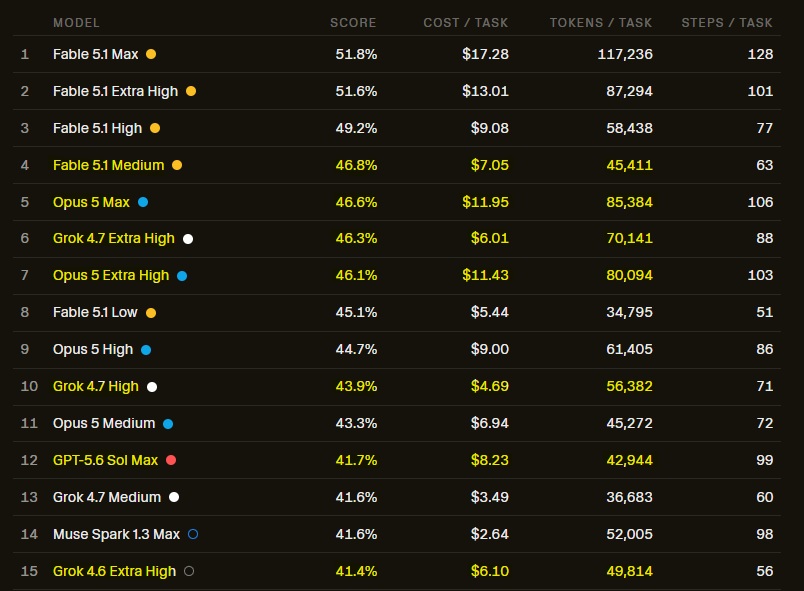
Im CursorBench zeigt sich, dass Grok 4.7 bei ähnlicher Leistung kosteneffizienter als GPT-5.6 Sol arbeitet. Bei maximalen Einstellungen liegen andere Modelle jedoch vorn.
Fazit
Grok 4.7 bietet wertvolle Verbesserungen bei spezifischen Arbeitsabläufen, rechtfertigt aber aufgrund des geringen Gesamtanstiegs noch keine Einstufung als Marktführer.
Weitere Informationen
Die offizielle Ankündigung von x.ai enthält alle technischen Details zur neuen Version.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-21
- Discovered via
- www.threads.com
Top 10
Bezahlte Werbung
- 01Wallpets 86 Klicks$125
- 02Walltank 106 Klicks$85
- 03Chowder 55 Klicks$50
- 04Falconer 47 Klicks$45
- 05Lemonpod 87 Klicks$40
- 06Menta 33 Klicks$35
- 07Sway 30 Klicks$30
- 08Peon-Ping 27 Klicks$25
- 09Zeron 89 Klicks$20
- 10Guideless 22 Klicks$15