
 提交資源


 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文

 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 返回實驗室
 JEVLAB NEWS Research & data
SpaceXAI 發布 Grok 4.7
AI-assisted summaries and translations. Check original sources for context and performance claims.
SpaceXAI 推出了 Grok 4.7,重點在於透過強化學習提升複雜任務與程式編寫能力。儘管在文件分析與程式碼生成方面有所進步,但整體智能水平的提升幅度相對有限。
翻譯摘要 · AI-assisted; check the original.
 翻譯摘要 · AI-assisted; check the original.

一覽完整討論串
使用AI獨立概述CHOI的連續貼文。圖片和影片歸原作者所有,原文中的主張未經獨立驗證。
Grok 4.7 發布
SpaceXAI 正式發布了 Grok 4.7,現已整合至 Cursor、Grok Build 與 Grok API 中。
技術升級
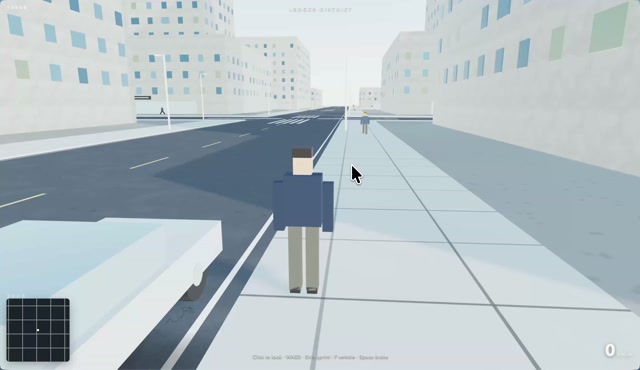
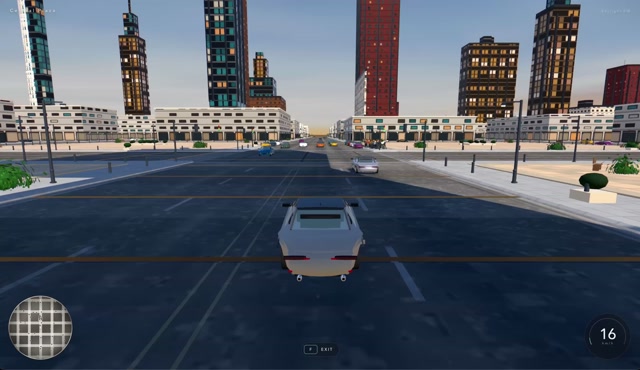
新版本引入了更大的基礎模型,並專注於透過強化學習處理長時間任務。演示顯示其在城市建築與車輛細節表現上更為細膩。
基準評估
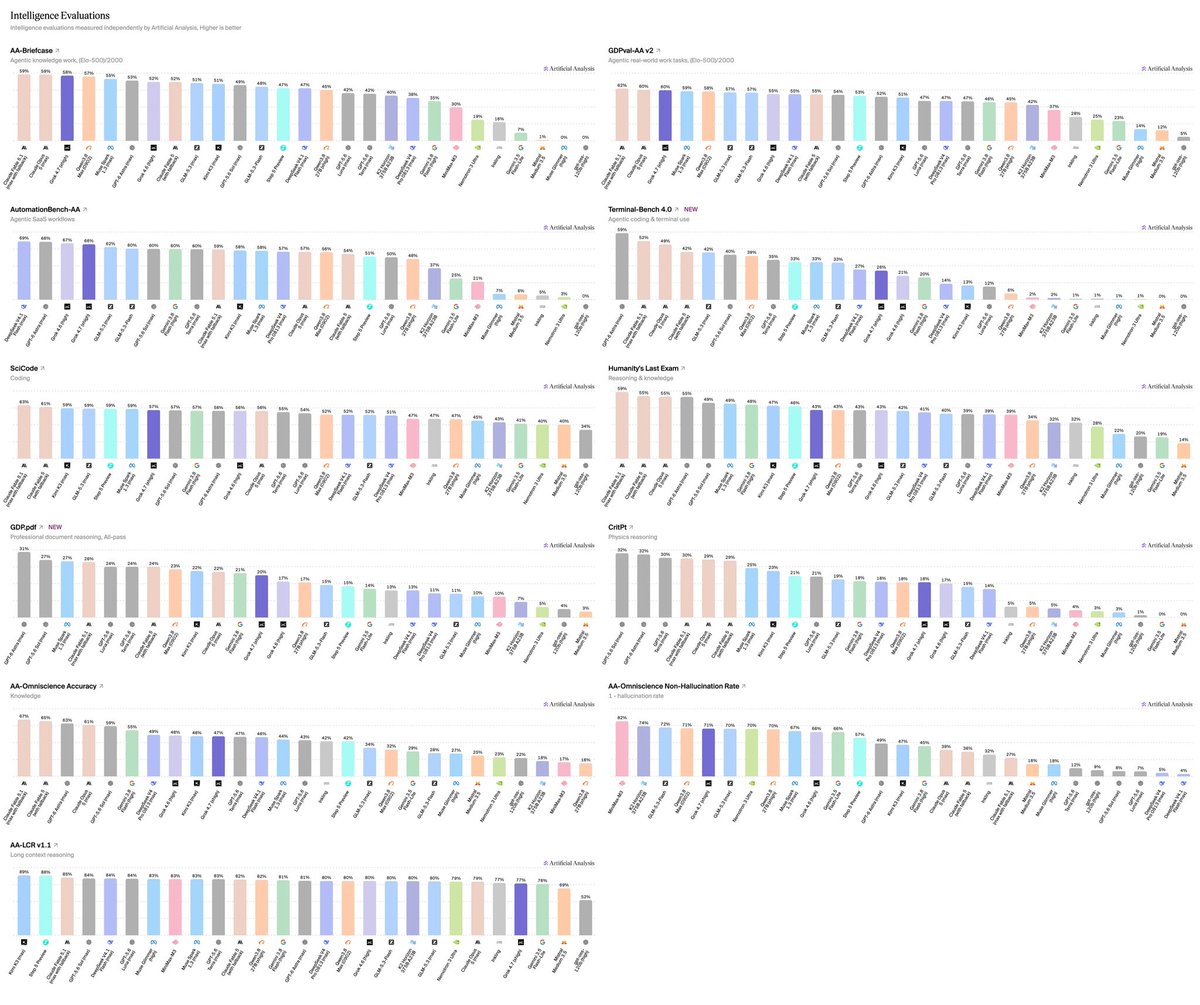
根據 Artificial Analysis 的數據,Grok 4.7 獲得 46 分,較 4.6 版本的 44 分有小幅提升,但與領先模型仍有差距。
推理成本與效率
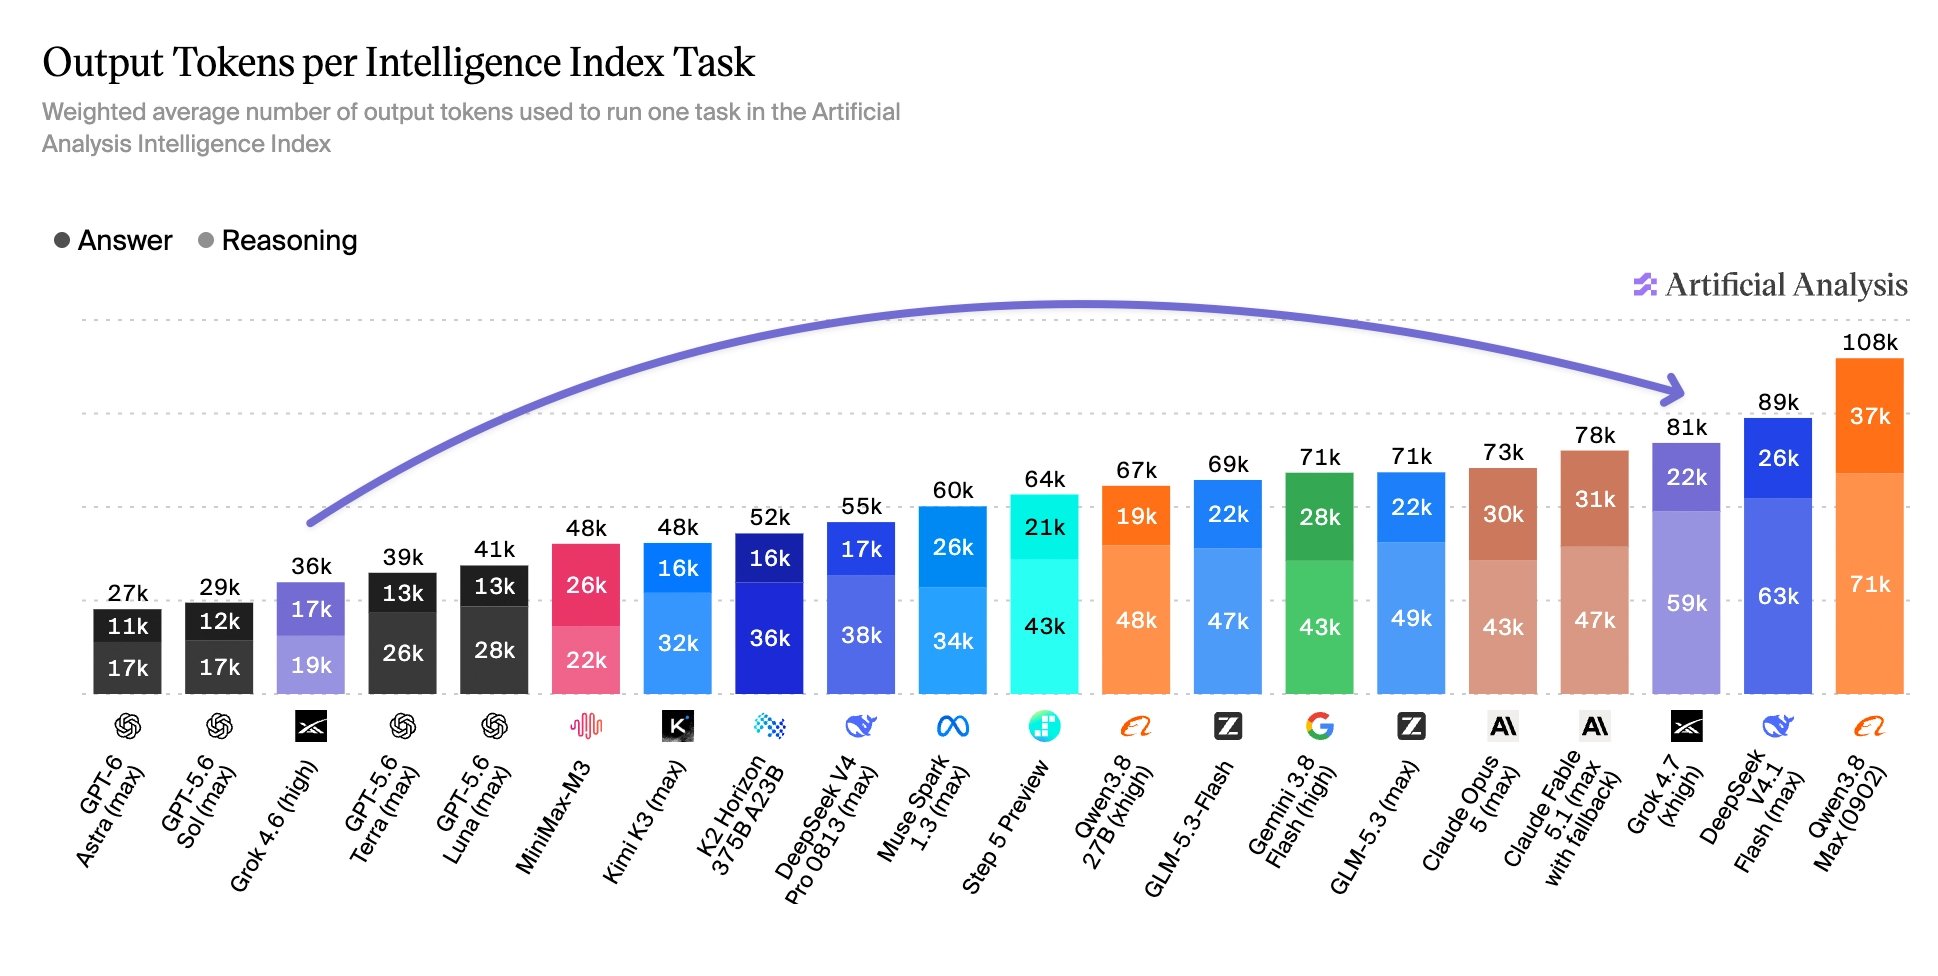
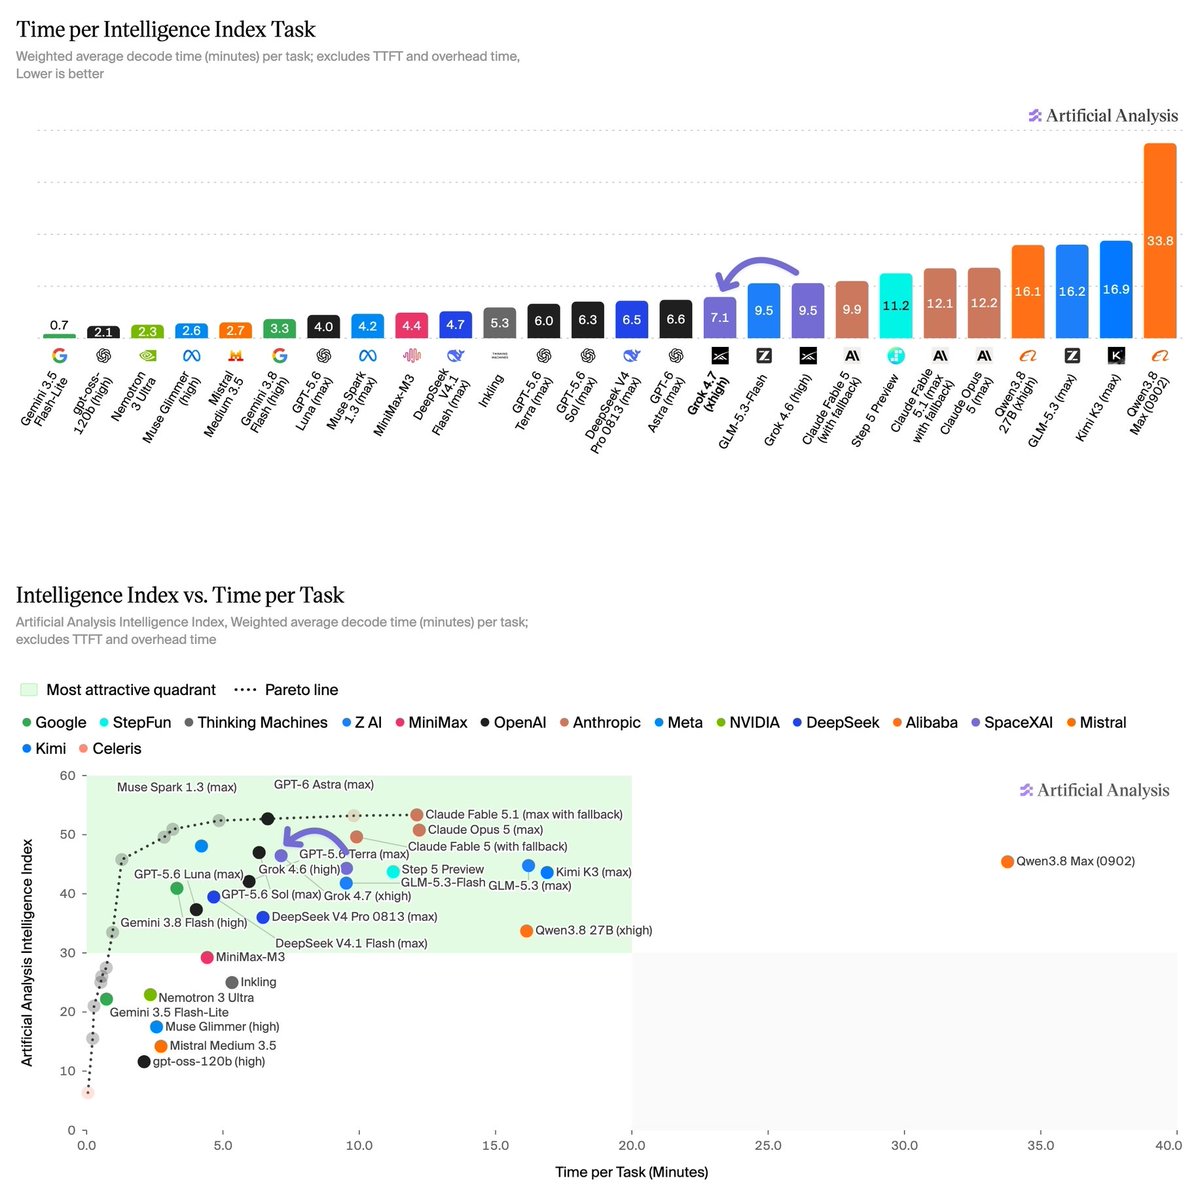
單任務輸出 Token 數量增加了 125%,生成時間縮短至 7.1 分鐘。更高的 Token 使用量意味著在相同單價下成本會增加。
辦公任務表現
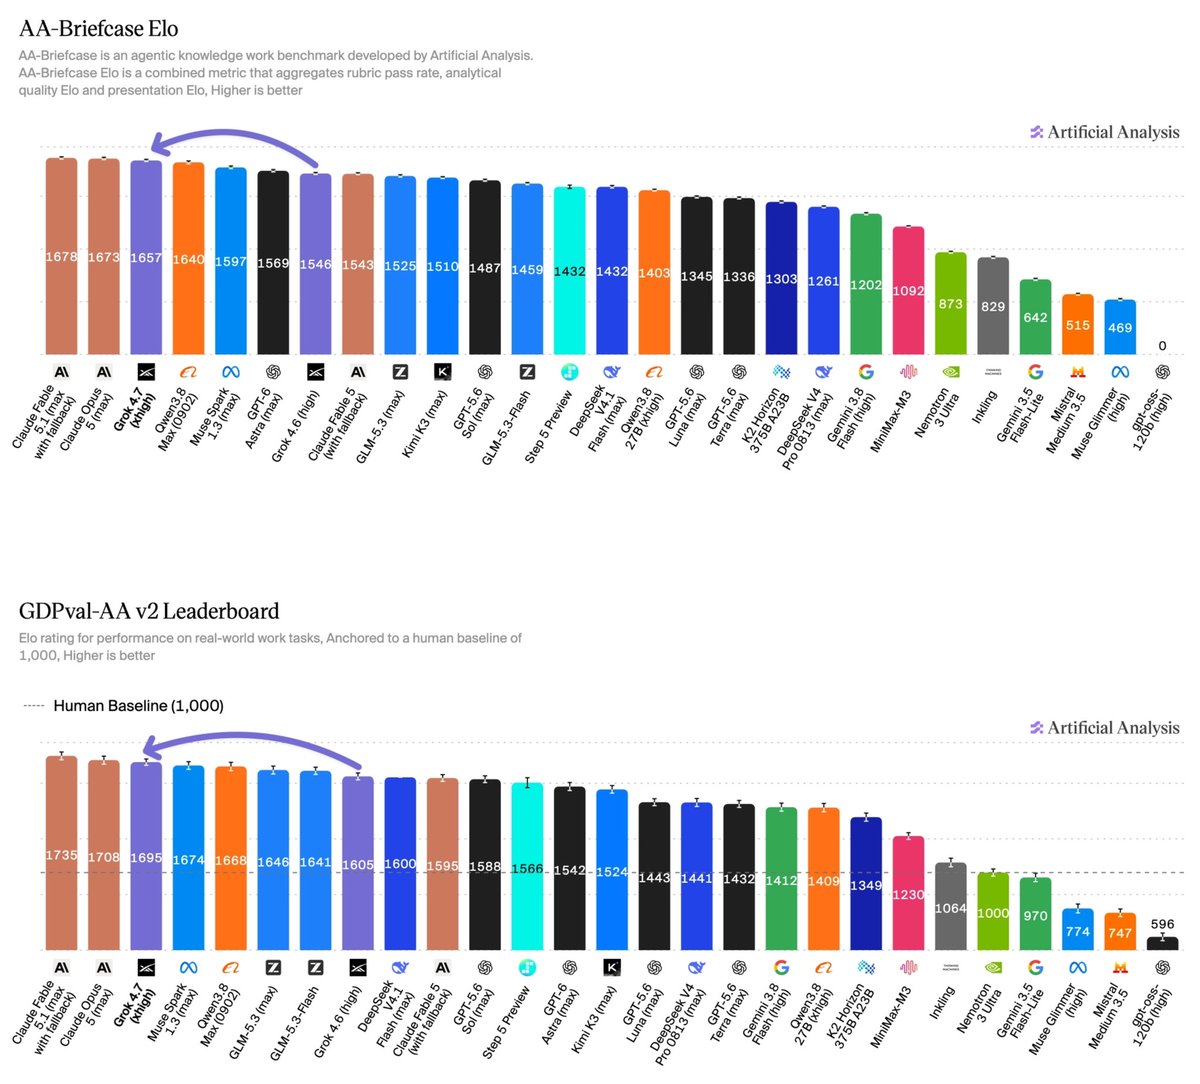
在文件處理任務中,Grok 4.7 表現出色,分析質量大幅提升,但在結果呈現質量上略有下降。
程式編寫能力提升
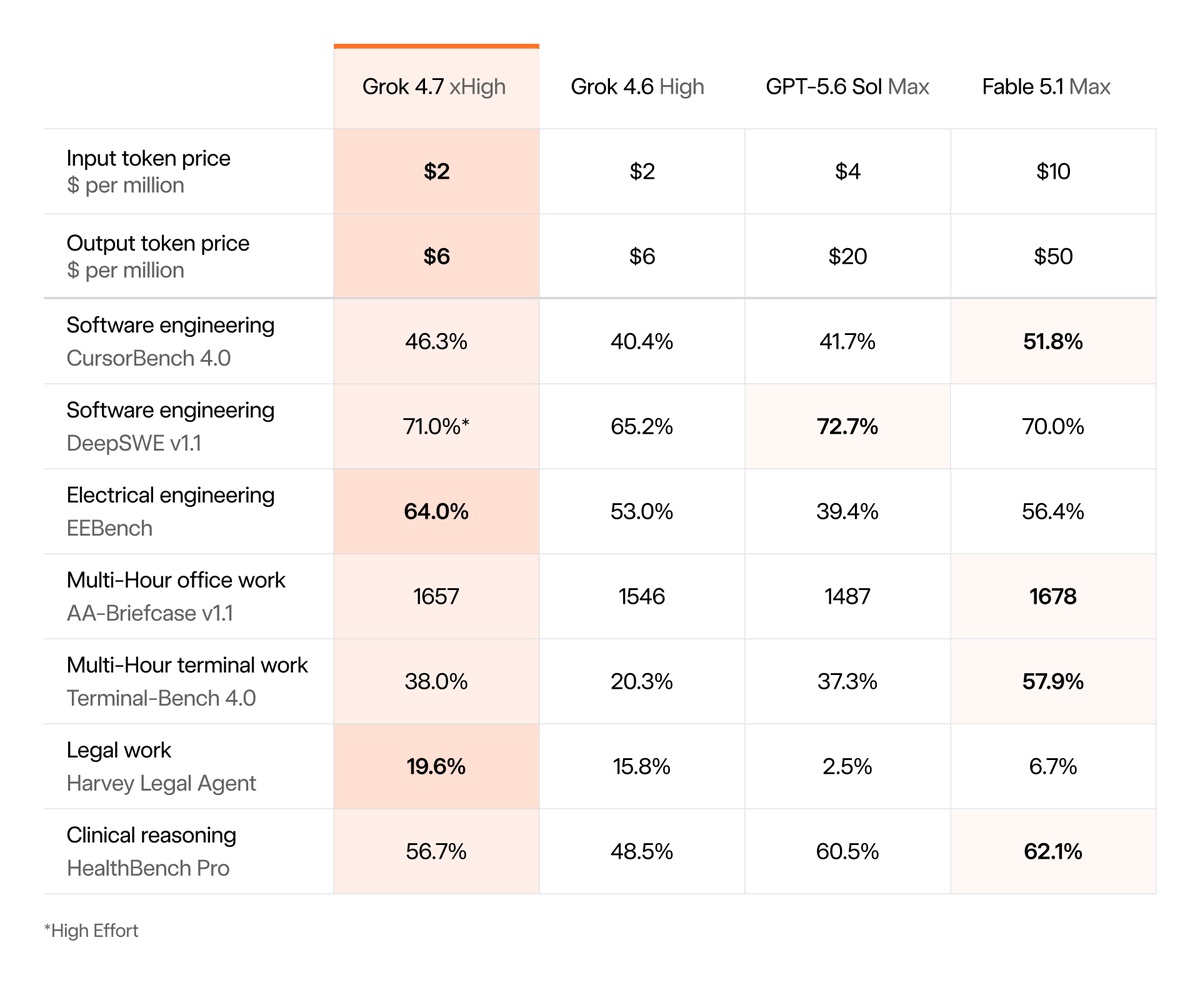
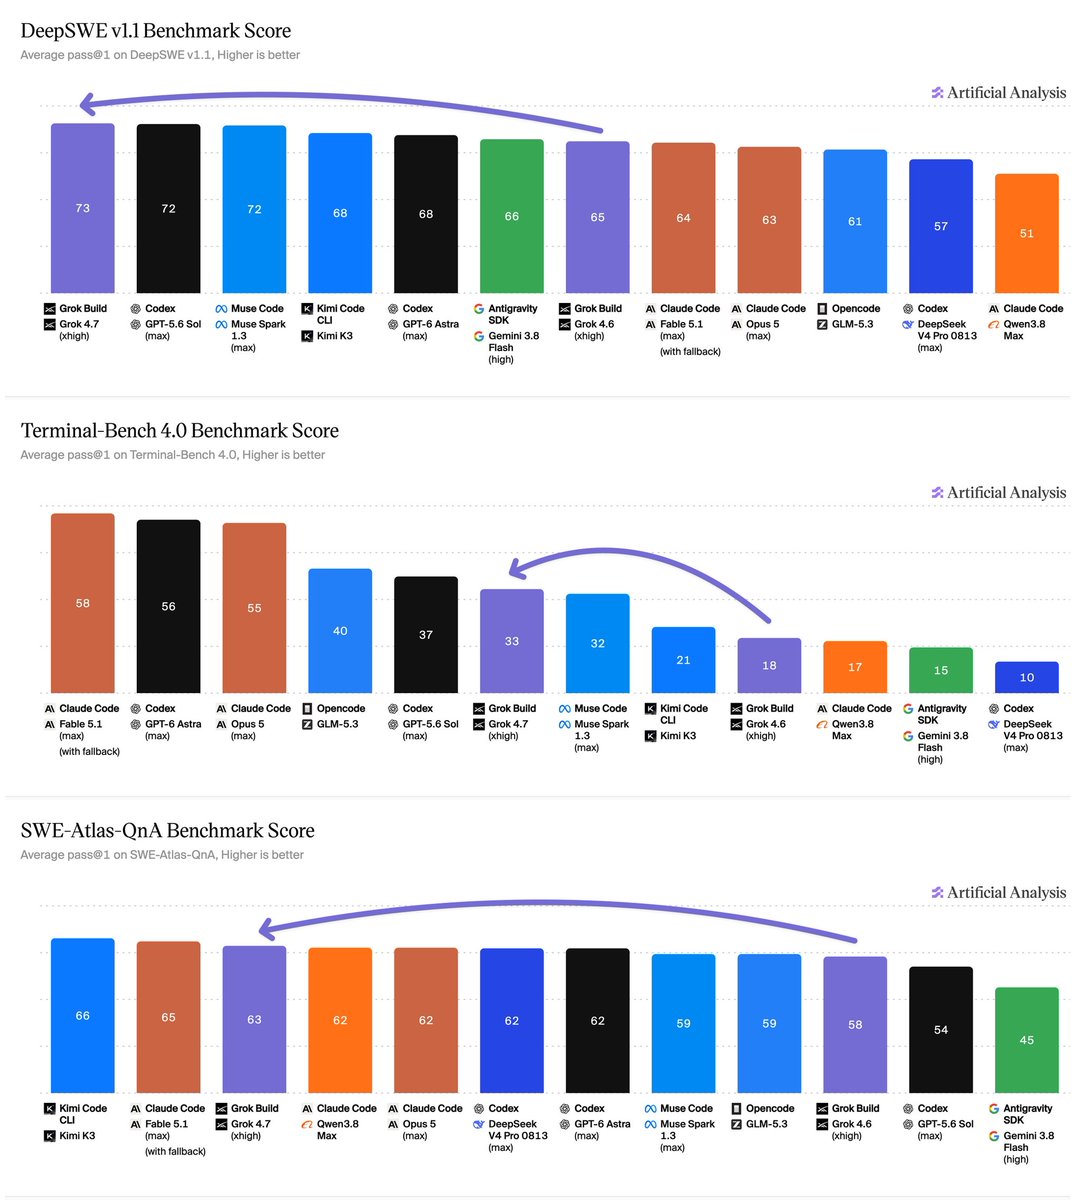
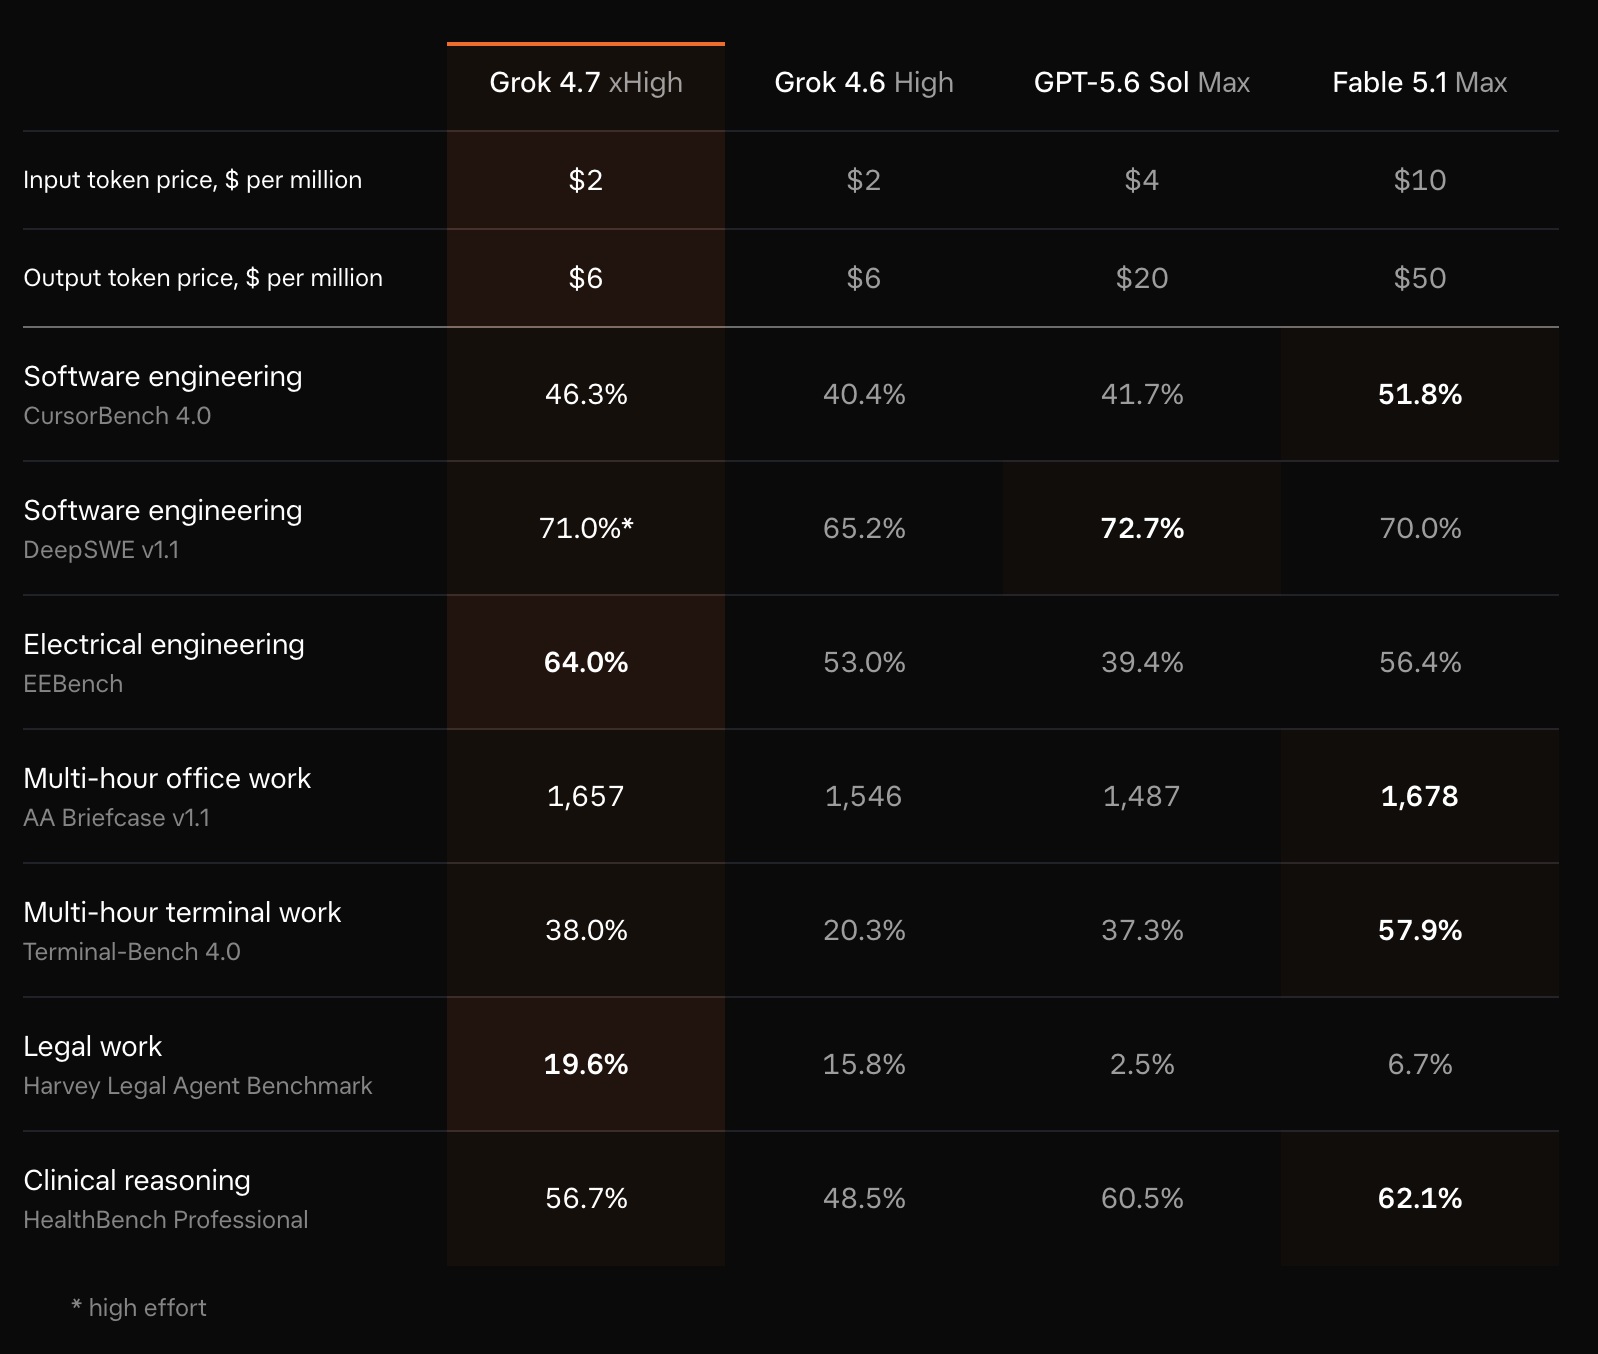
程式編寫代理指數從 47 升至 56,超過了 GPT-5.6 Sol,在多個程式編寫基準測試中均有顯著進步。
其他領域表現
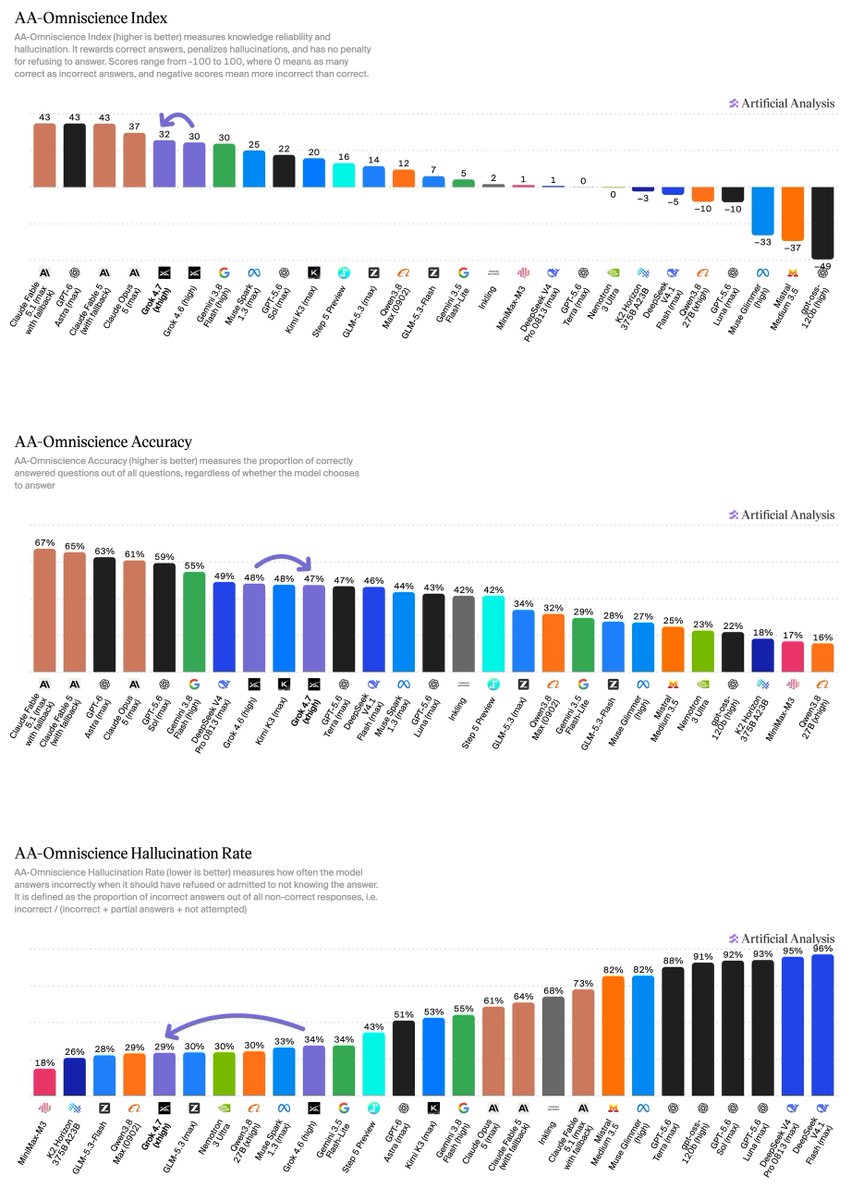
在長上下文推理等領域表現平平,甚至出現小幅下滑。幻覺率有所降低,但整體準確率保持不變。
API 定價
Grok 4.7 維持了極具競爭力的定價,每百萬 Token 輸入/輸出分別為 2 美元與 6 美元。
成本效益分析
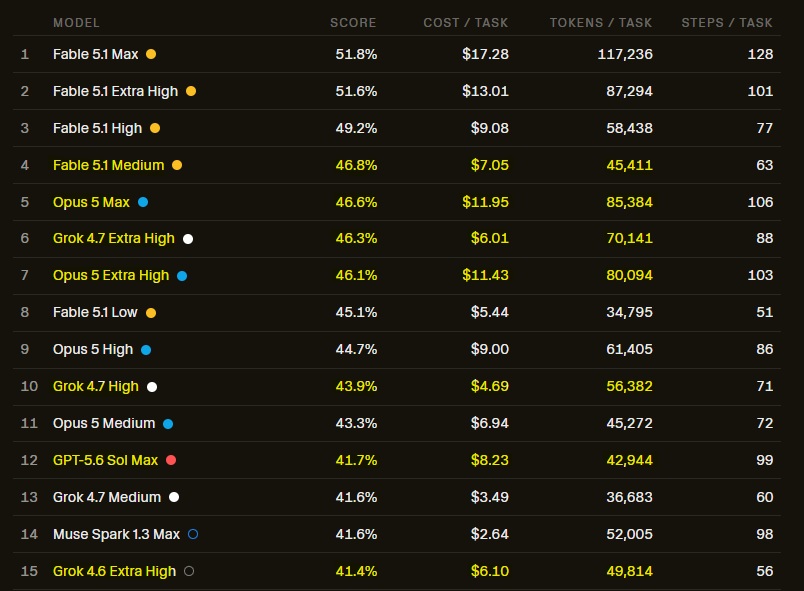
CursorBench 測試顯示,在相似性能下,Grok 4.7 的成本低於 GPT-5.6 Sol,但在最高推理設置下,其他模型表現更優。
總結評價
Grok 4.7 在特定任務與成本控制上表現積極,但整體智能提升幅度未達預期,與頂級模型仍存在差距。
官方公告
有關 Grok 4.7 的詳細發布資訊可訪問 x.ai 官方網站查看。
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-21
- Discovered via
- www.threads.com
前十名
付費推廣
- 01Wallpets 86 點擊次數$125
- 02Walltank 106 點擊次數$85
- 03Chowder 55 點擊次數$50
- 04Falconer 47 點擊次數$45
- 05Lemonpod 87 點擊次數$40
- 06Menta 33 點擊次數$35
- 07Sway 30 點擊次數$30
- 08Peon-Ping 27 點擊次數$25
- 09Zeron 89 點擊次數$20
- 10Guideless 22 點擊次數$15