
 Enviar recurso


 English
 한국어
 日本語

 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Volver al laboratorio
 JEVLAB NEWS Research & data
SpaceXAI lanza Grok 4.7
AI-assisted summaries and translations. Check original sources for context and performance claims.
SpaceXAI ha lanzado Grok 4.7, incorporando un modelo base más grande y un aprendizaje reforzado para tareas complejas. Aunque muestra mejoras notables en codificación y análisis de documentos, el aumento en su puntuación de inteligencia general es moderado.
Resumen traducido · AI-assisted; check the original.
 Resumen traducido · AI-assisted; check the original.

Todo el hilo, de un vistazo
Resúmenes propios con ayuda de IA de las publicaciones conectadas de CHOI. Las imágenes y los vídeos pertenecen a sus creadores. Las afirmaciones no se han verificado de forma independiente.
Lanzamiento de Grok 4.7
SpaceXAI ha anunciado oficialmente Grok 4.7, disponible en Cursor, Grok Build y la API de Grok.
Mejoras del modelo
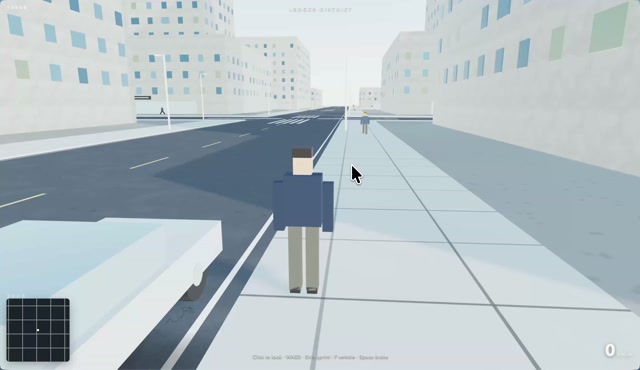
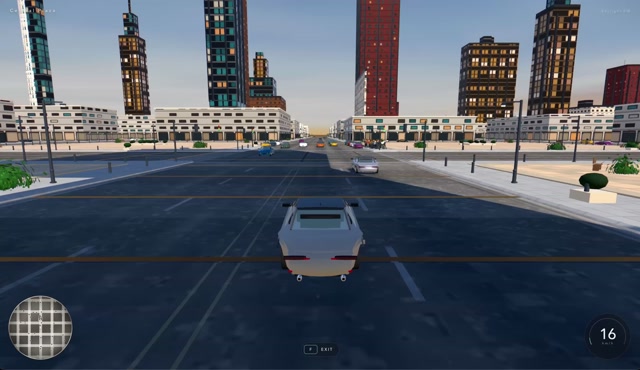
El modelo utiliza una base mayor y se enfoca en tareas de larga duración. Los resultados visuales en demos urbanas muestran mayor detalle.
Evaluación de rendimiento
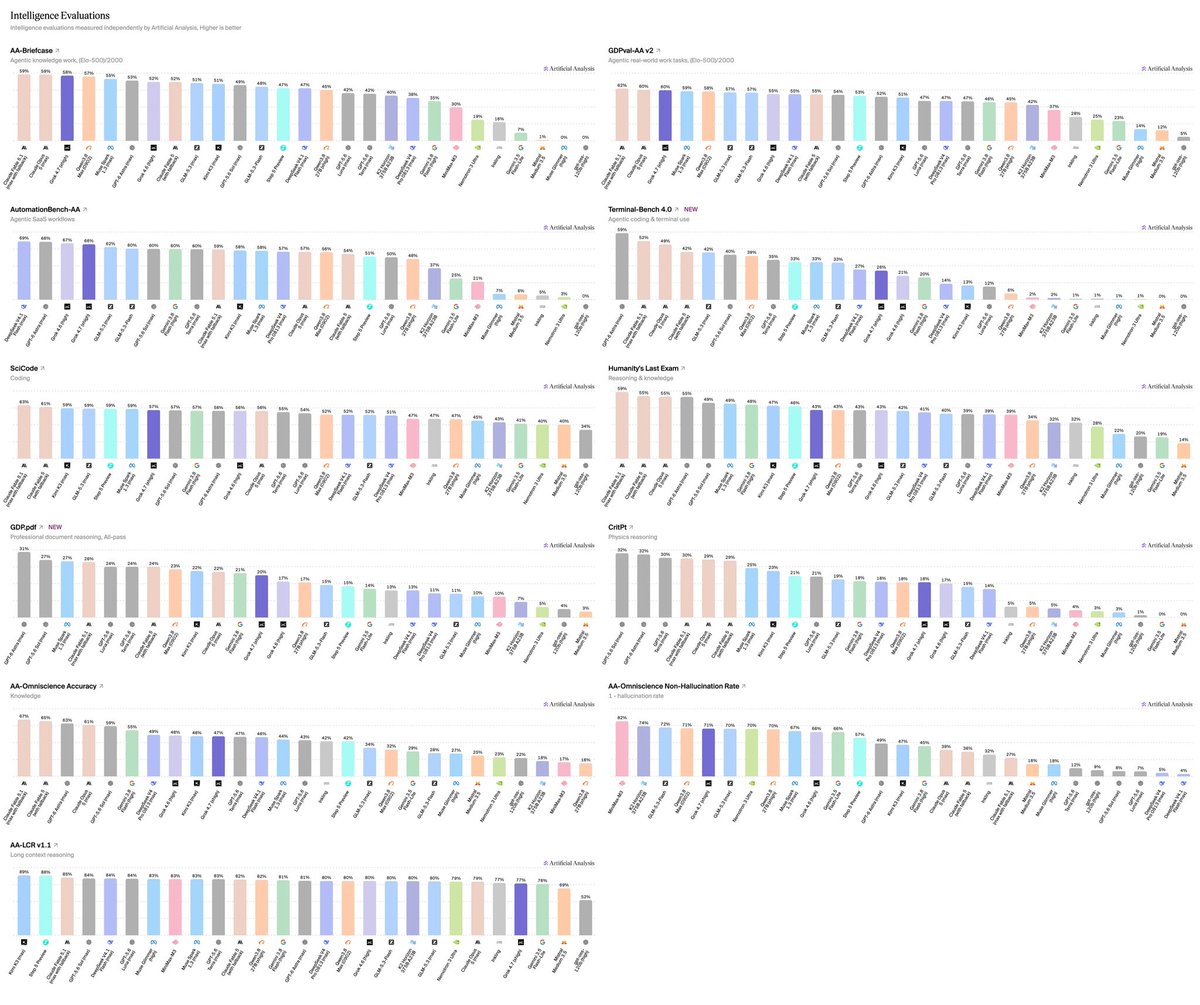
Según Artificial Analysis, Grok 4.7 obtuvo 46 puntos, un incremento de 2 puntos respecto a la versión 4.6, manteniéndose por debajo de los líderes.
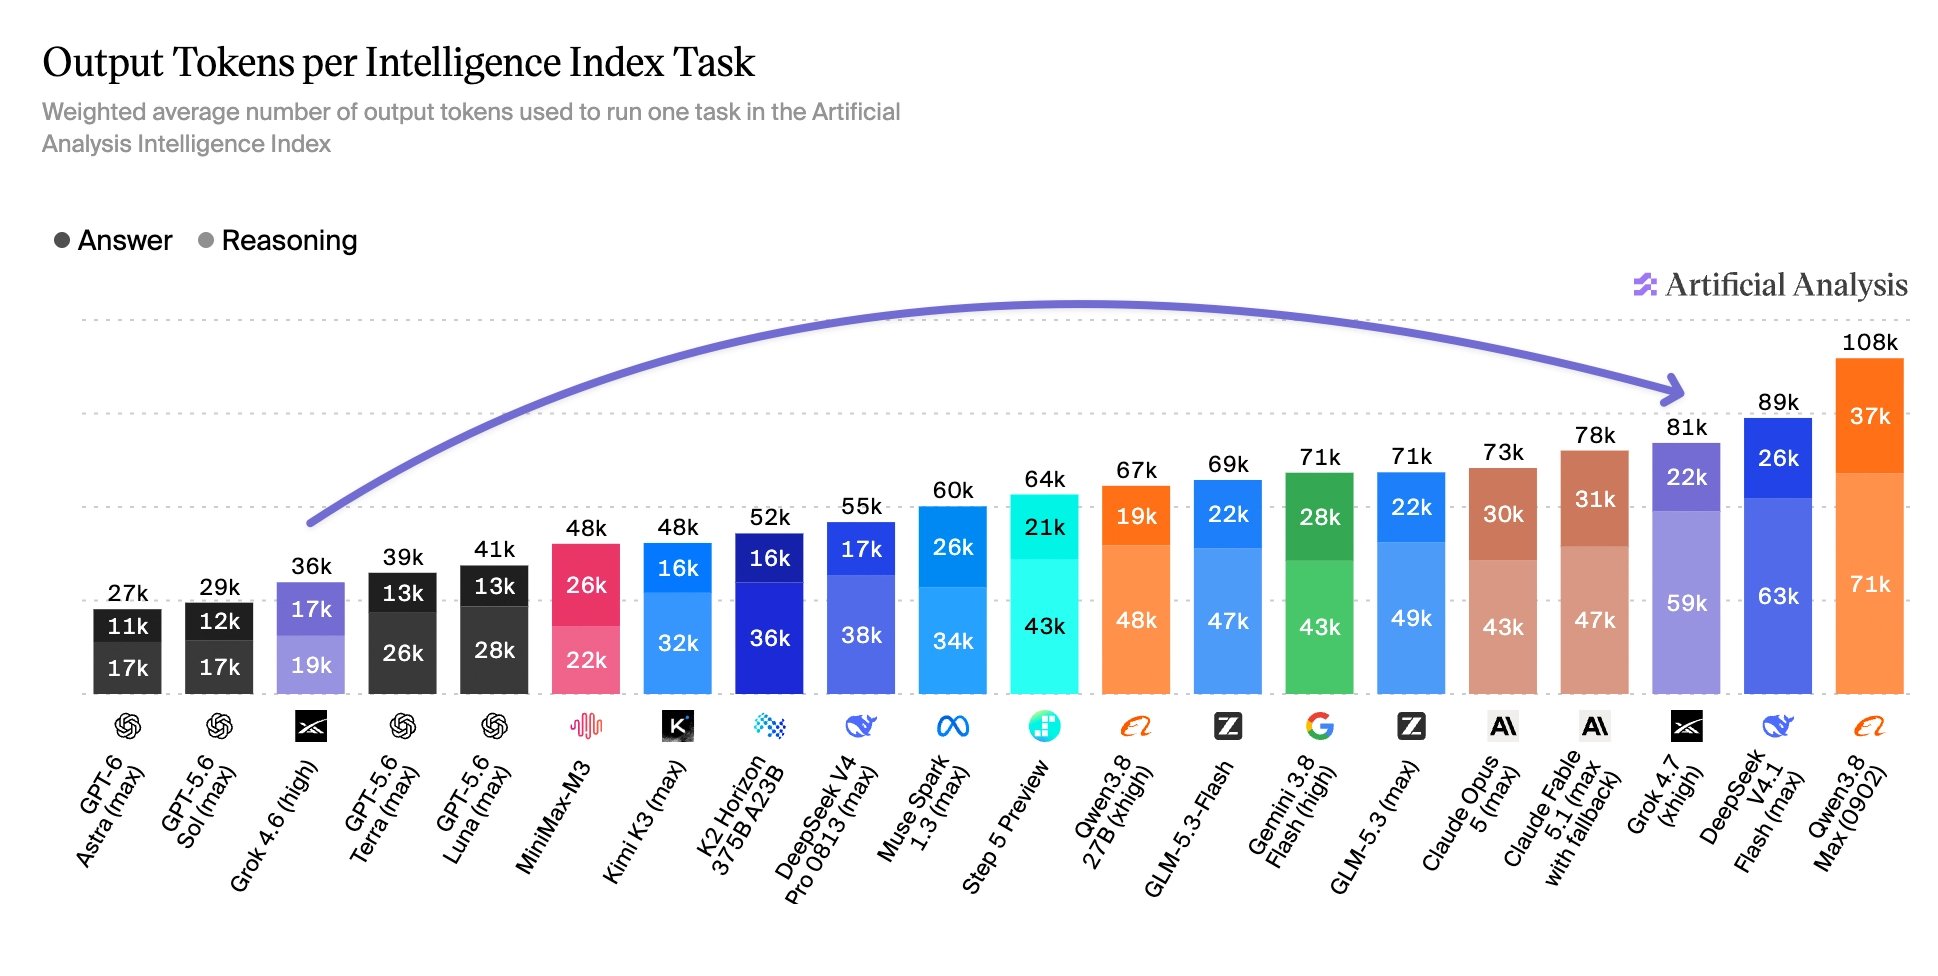
Tokens y velocidad
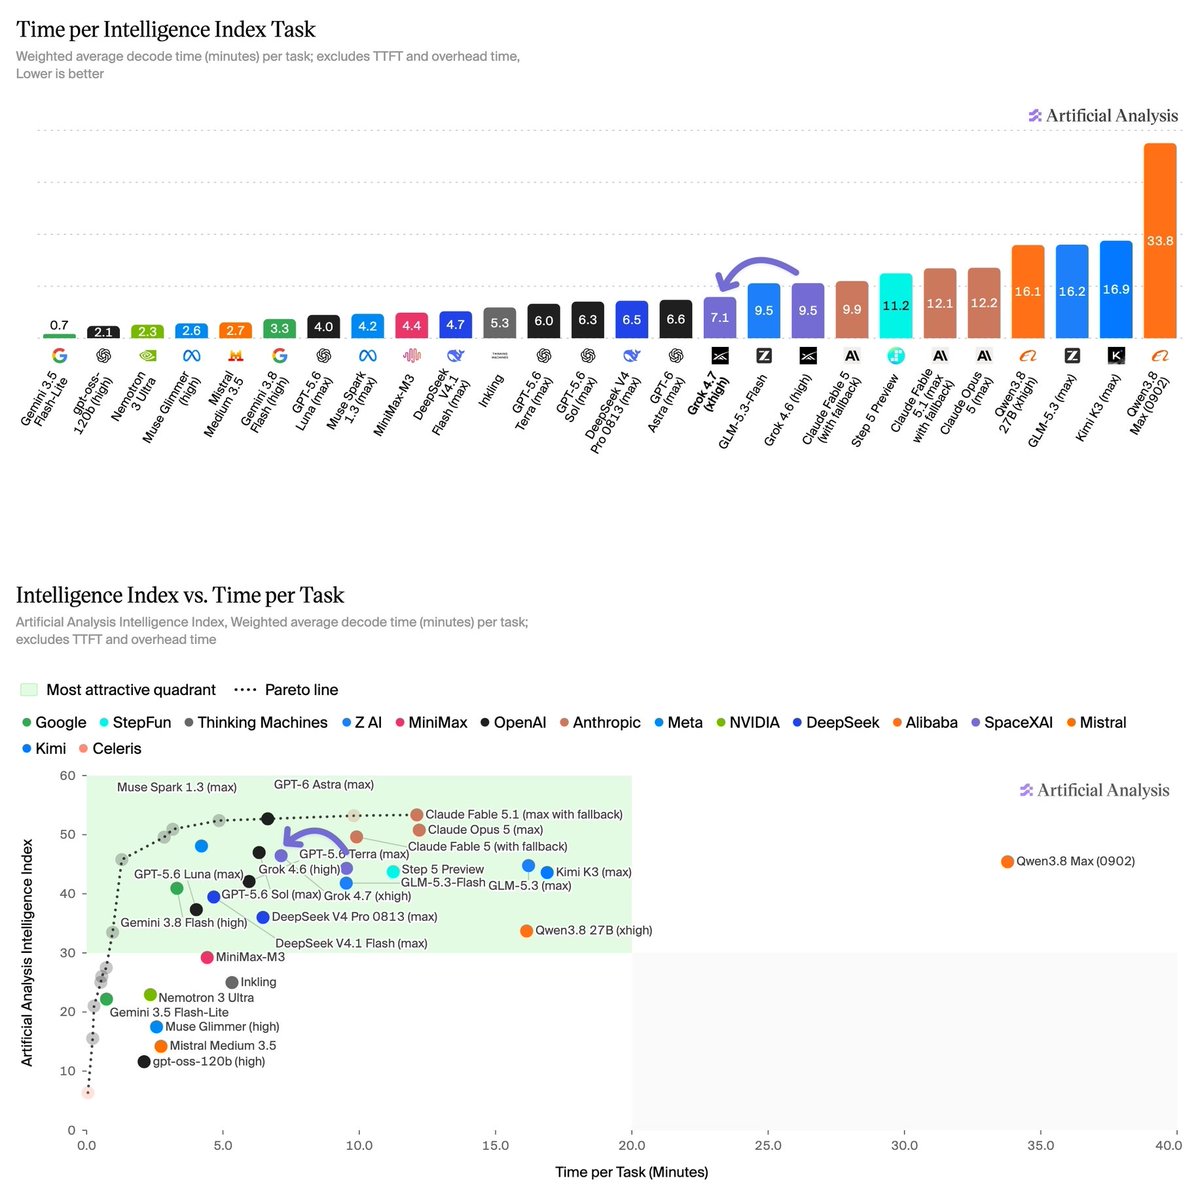
El uso de tokens de salida aumentó un 125%, mientras que el tiempo de generación se redujo de 9.5 a 7.1 minutos.
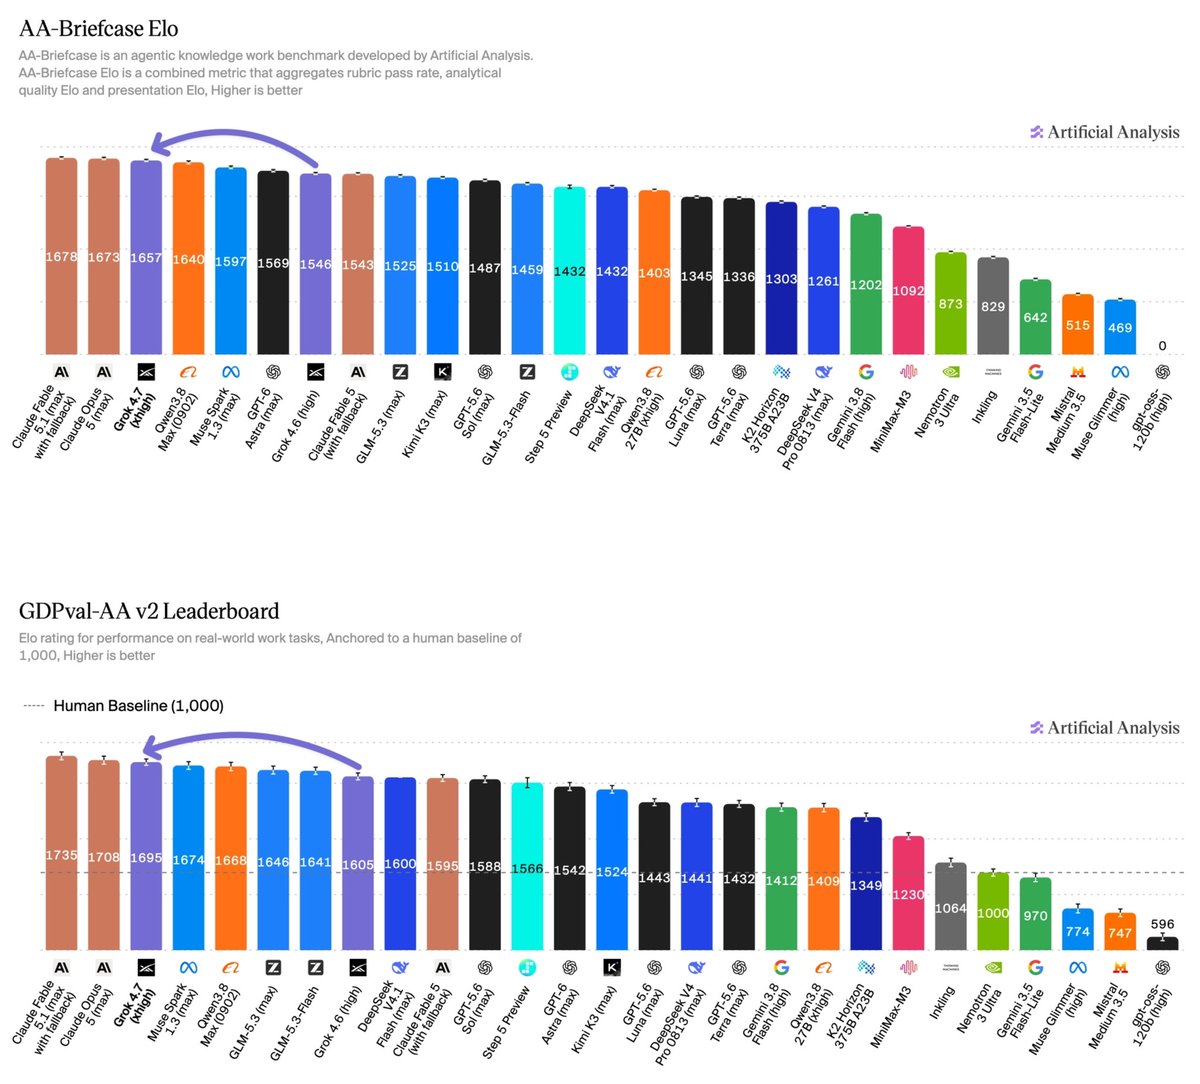
Tareas de conocimiento
Se observó una mejora significativa en el análisis de documentos, aunque la calidad de presentación de resultados tuvo un ligero descenso.
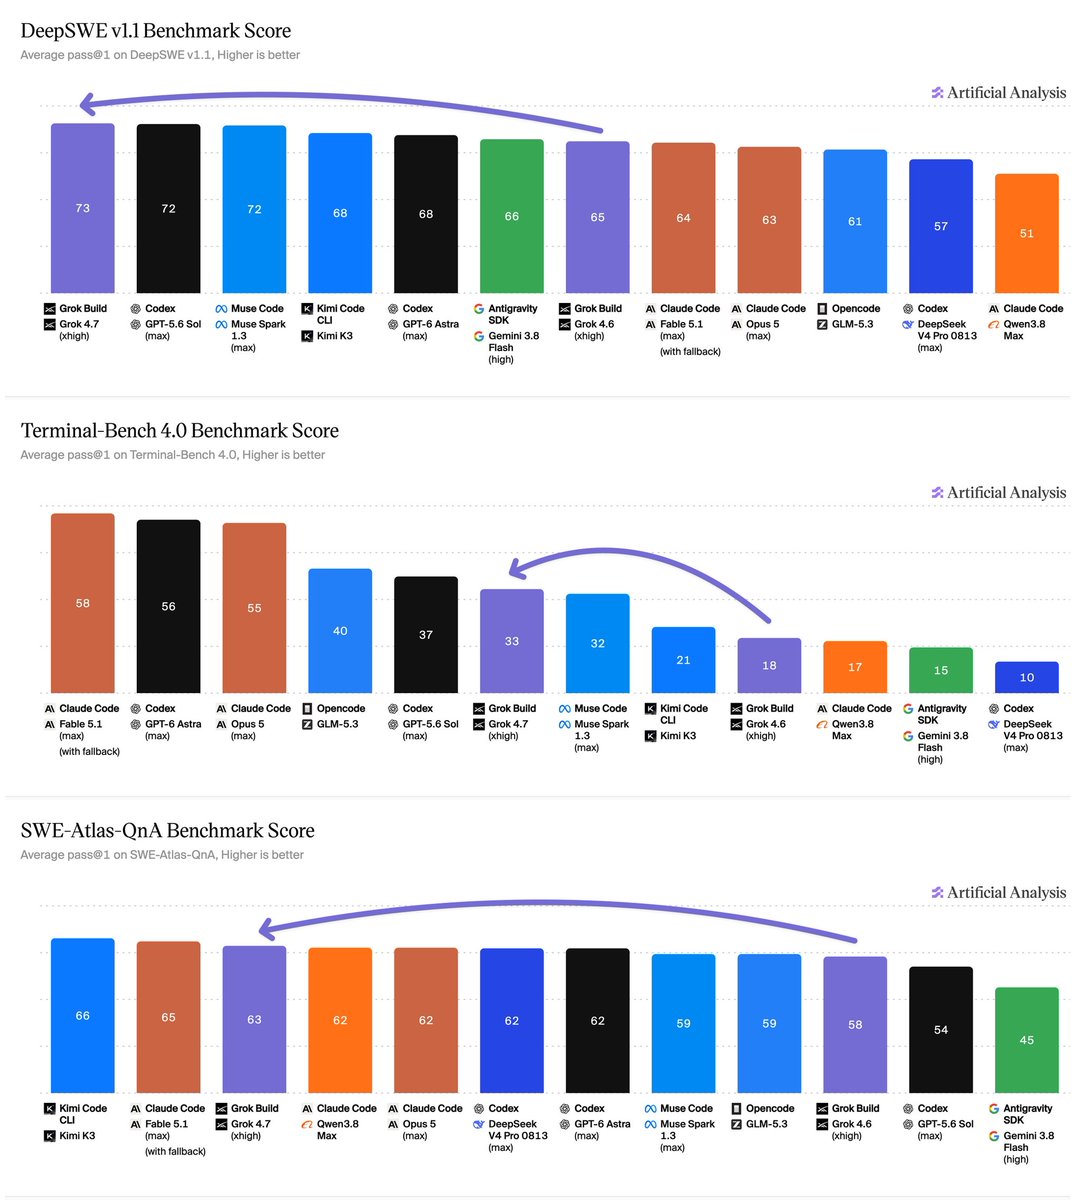
Agentes de codificación
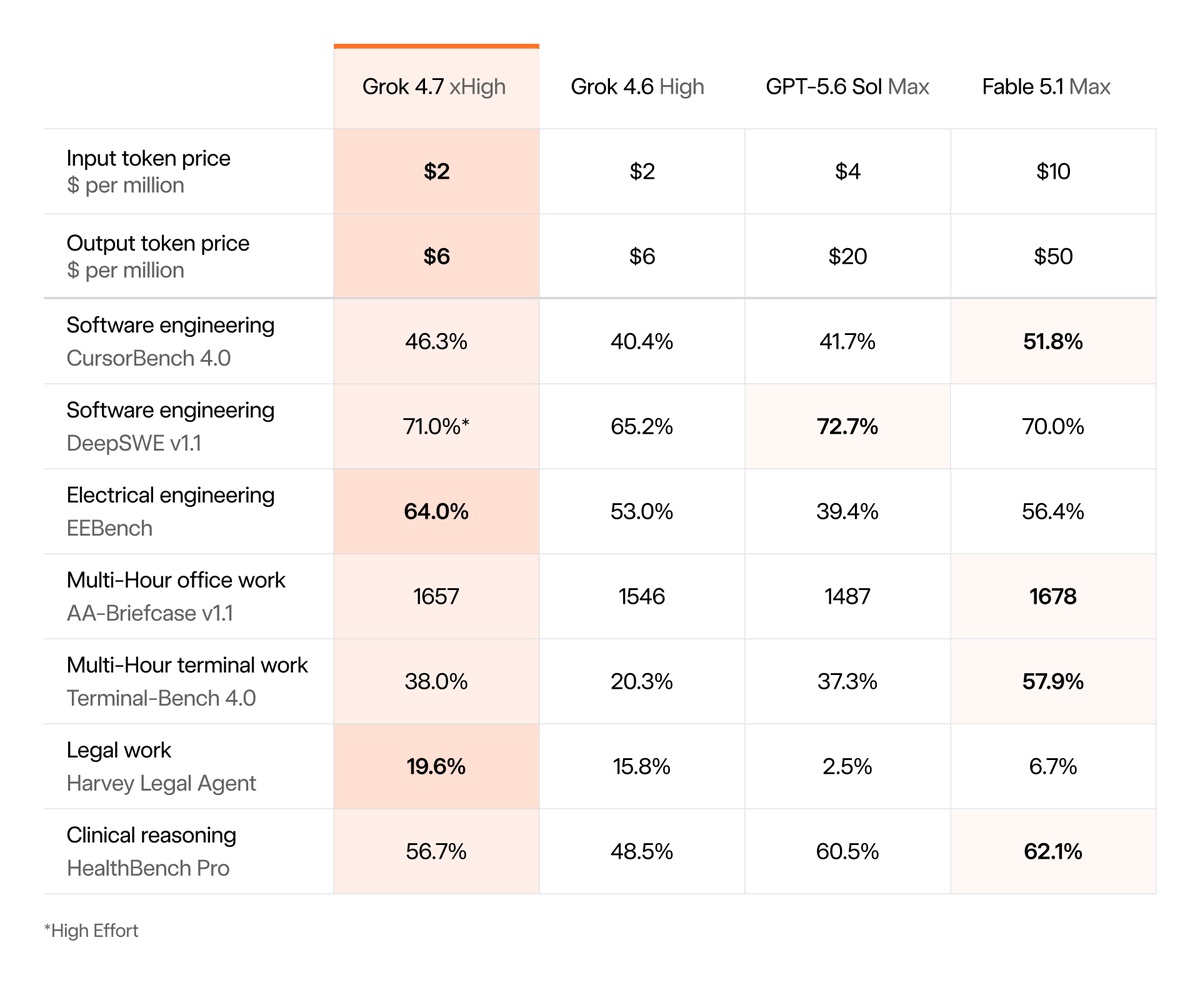
El índice de agentes de codificación subió a 56 puntos, superando a GPT-5.6 Sol en diversas pruebas técnicas.
Otras áreas
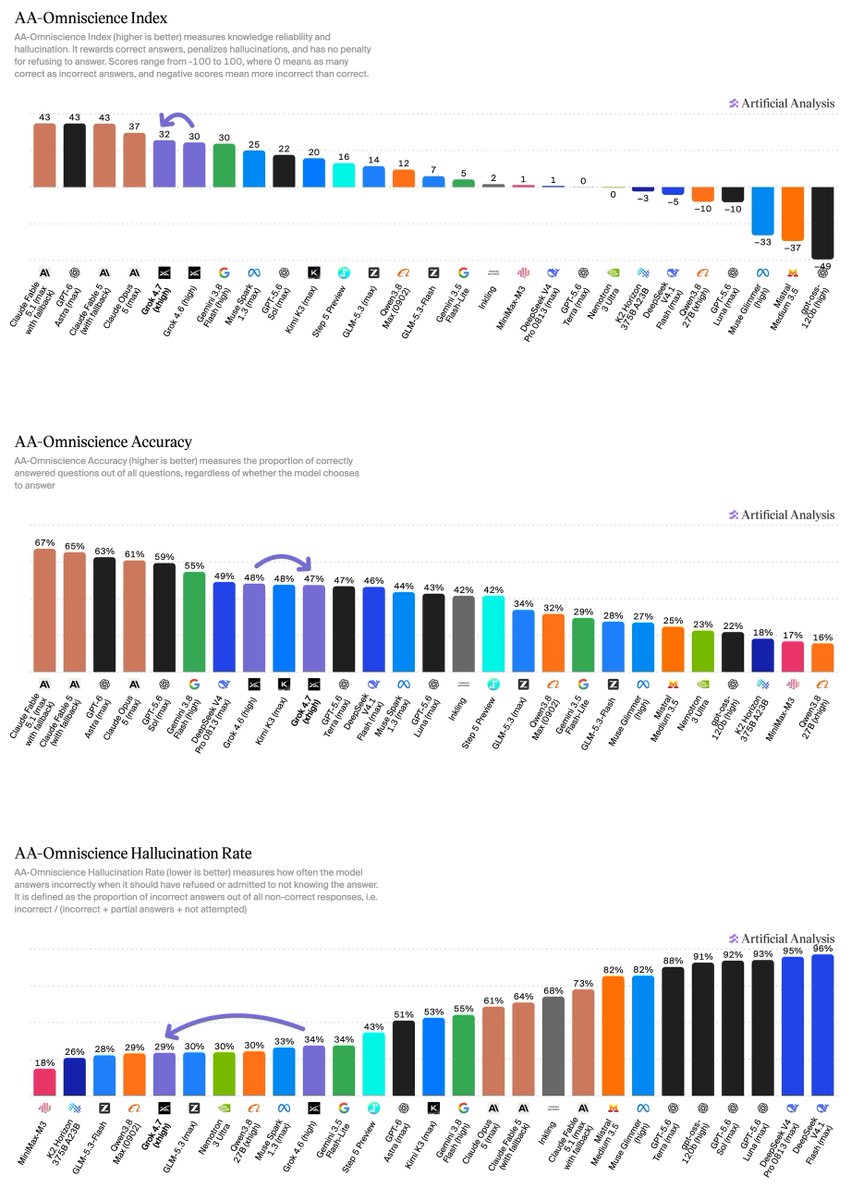
El razonamiento de contexto largo y otros benchmarks mostraron resultados mixtos. La tasa de alucinaciones bajó, pero la precisión se mantuvo estable.
Precios de API
Grok 4.7 mantiene los precios de la versión anterior, ofreciendo una opción competitiva frente a otros modelos del mercado.
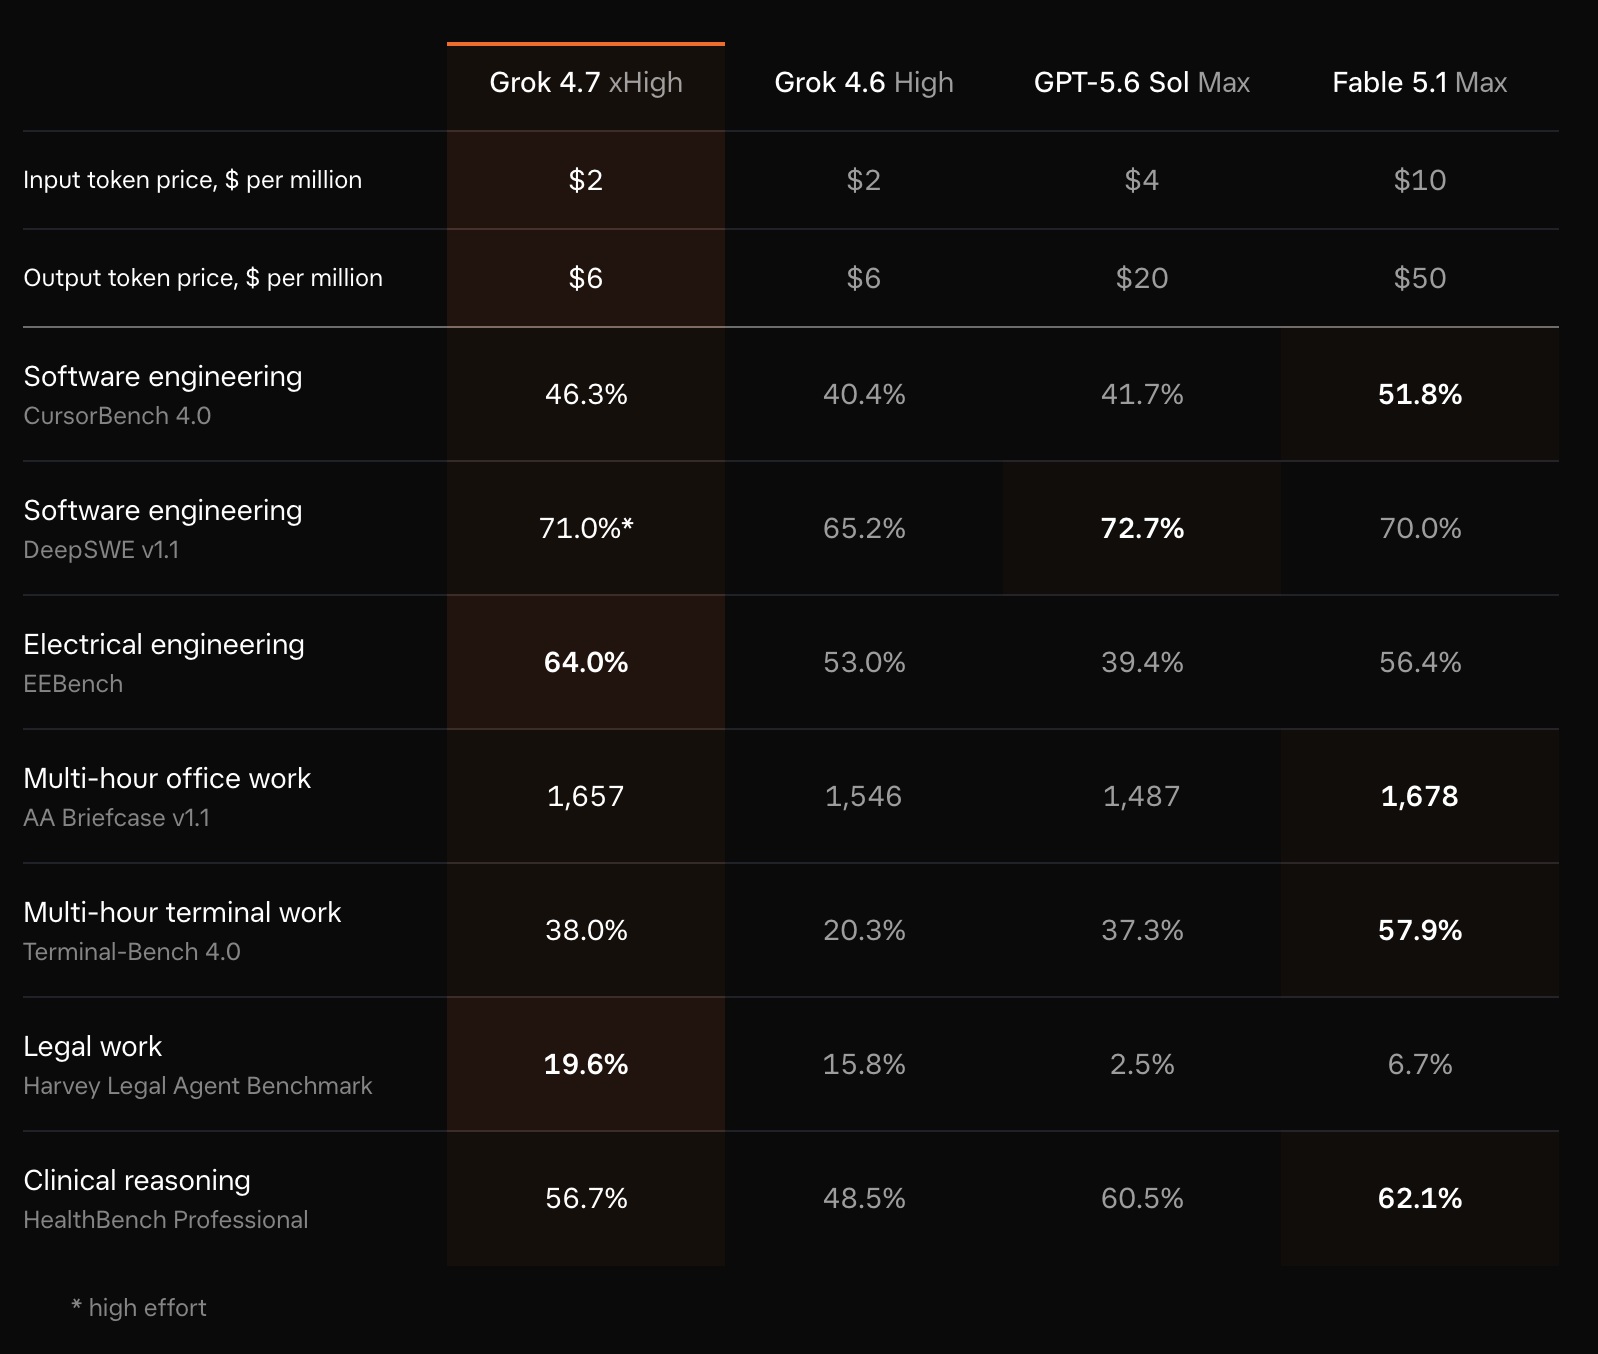
Eficiencia de costos
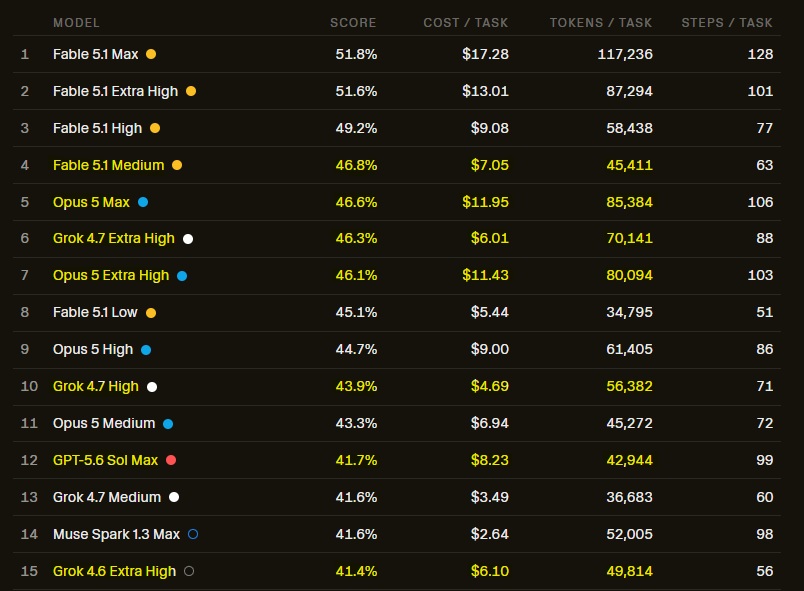
CursorBench indica que Grok 4.7 logra un rendimiento similar al de sus competidores con un costo operativo menor en tareas específicas.
Evaluación general
Aunque es una mejora útil para codificación y costos, el salto en inteligencia general es menor a lo esperado.
Información adicional
Los detalles completos están disponibles en el sitio web oficial de x.ai.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-21
- Discovered via
- www.threads.com
Top 10
Publicidad pagada
- 01Wallpets 86 clics$125
- 02Walltank 106 clics$85
- 03Chowder 55 clics$50
- 04Falconer 47 clics$45
- 05Lemonpod 87 clics$40
- 06Menta 33 clics$35
- 07Sway 30 clics$30
- 08Peon-Ping 27 clics$25
- 09Zeron 89 clics$20
- 10Guideless 22 clics$15