
 提交资源


 English
 한국어
 日本語
 Español
 Français
 Deutsch

 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 返回实验室
 JEVLAB NEWS Research & data
SpaceXAI 发布 Grok 4.7
AI-assisted summaries and translations. Check original sources for context and performance claims.
SpaceXAI 推出了 Grok 4.7,重点在于通过强化学习提升复杂任务和编程能力。尽管在文档分析和代码生成方面有所进步,但整体智能水平的提升幅度相对有限。
译文摘要 · AI-assisted; check the original.
 译文摘要 · AI-assisted; check the original.

一览完整讨论串
使用AI独立概述CHOI的连续帖子。图片和视频归原作者所有,原文中的主张未经独立验证。
Grok 4.7 发布
SpaceXAI 正式发布了 Grok 4.7,现已集成至 Cursor、Grok Build 和 Grok API 中。
技术升级
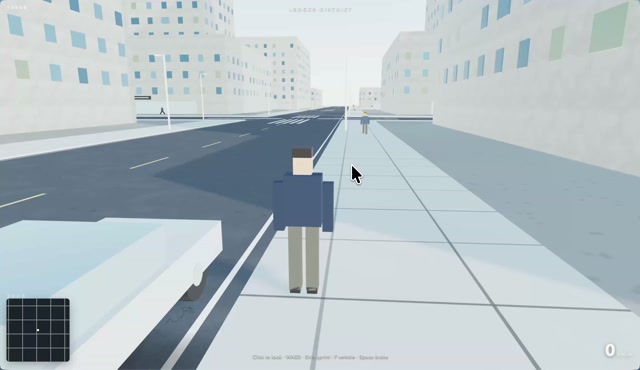
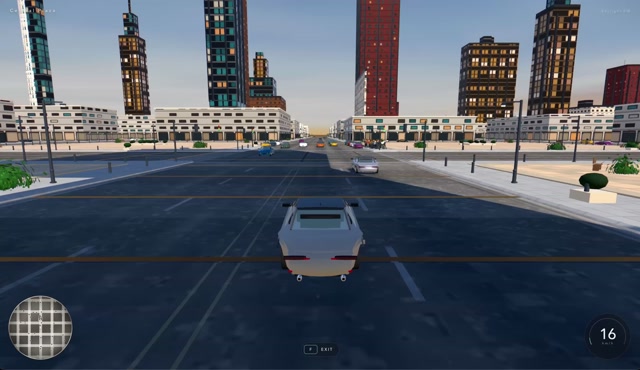
新版本引入了更大的基础模型,并专注于通过强化学习处理长时间任务。演示显示其在城市建筑和车辆细节表现上更为细腻。
基准评估
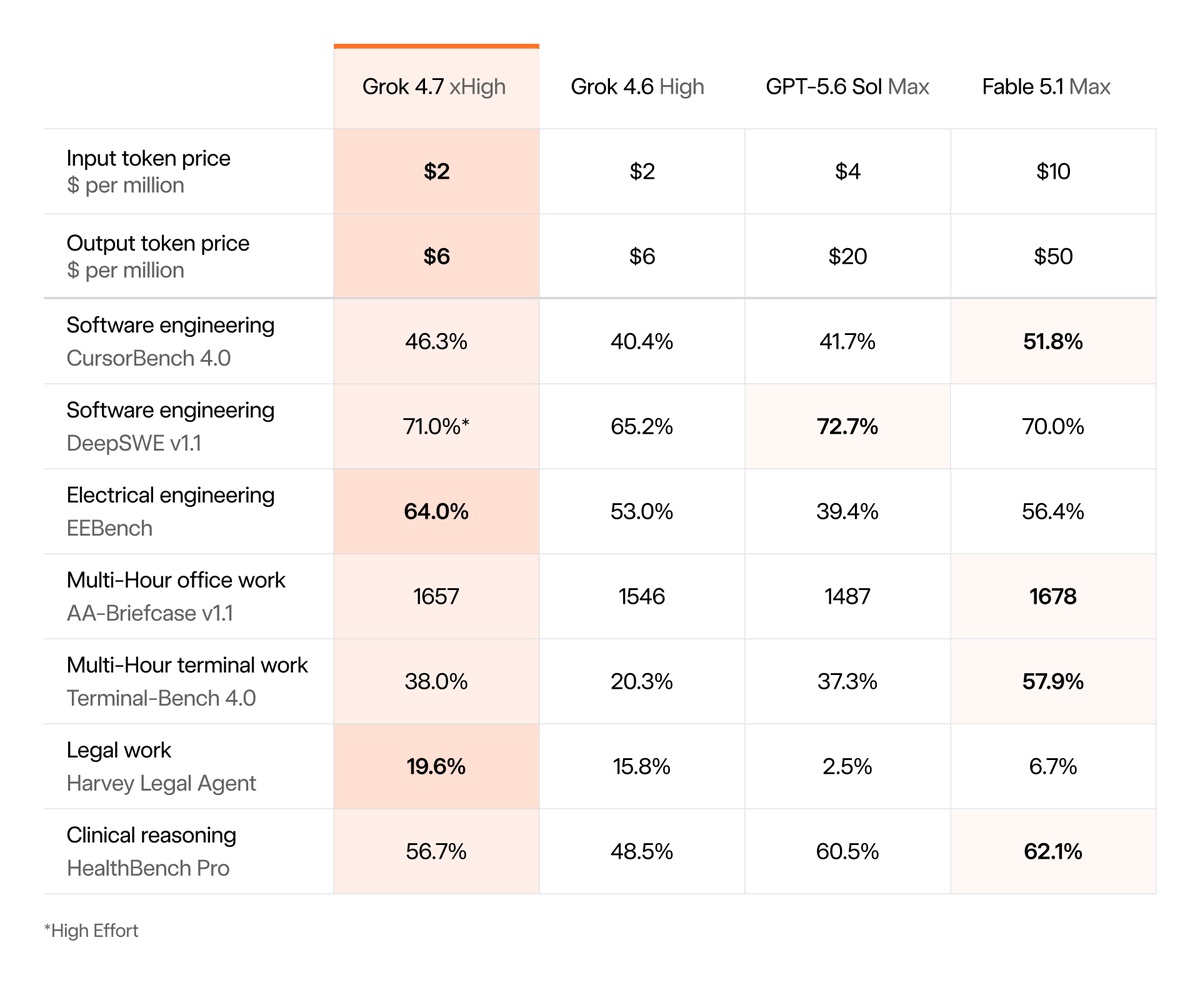
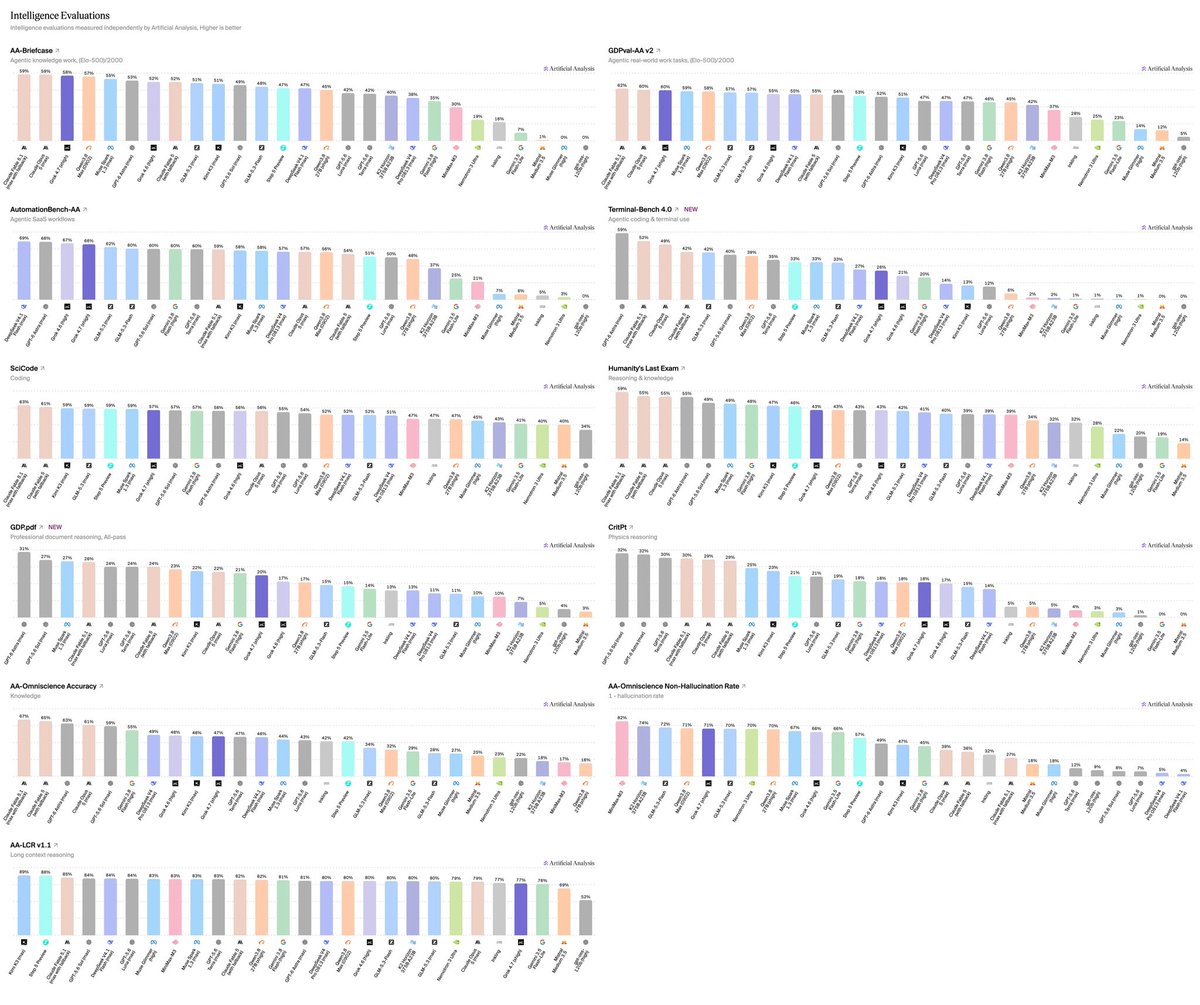
根据 Artificial Analysis 的数据,Grok 4.7 获得 46 分,较 4.6 版本的 44 分有小幅提升,但与领先模型仍有差距。
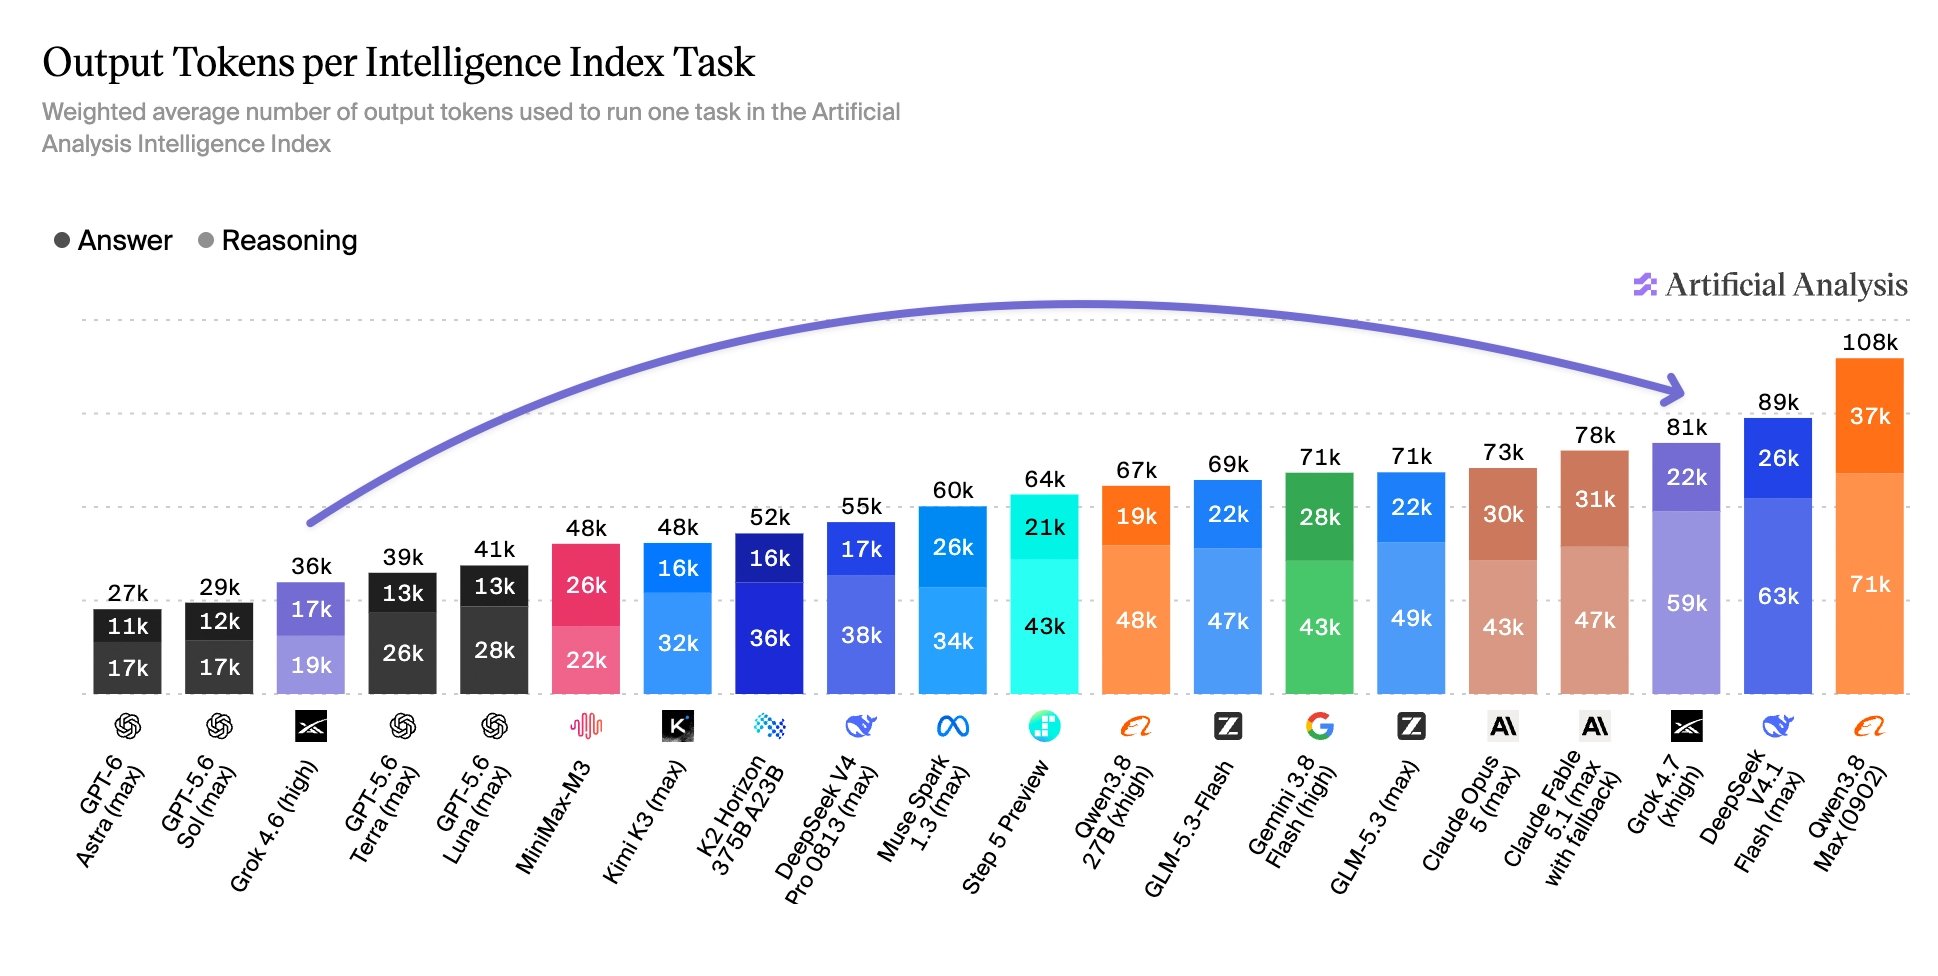
推理成本与效率
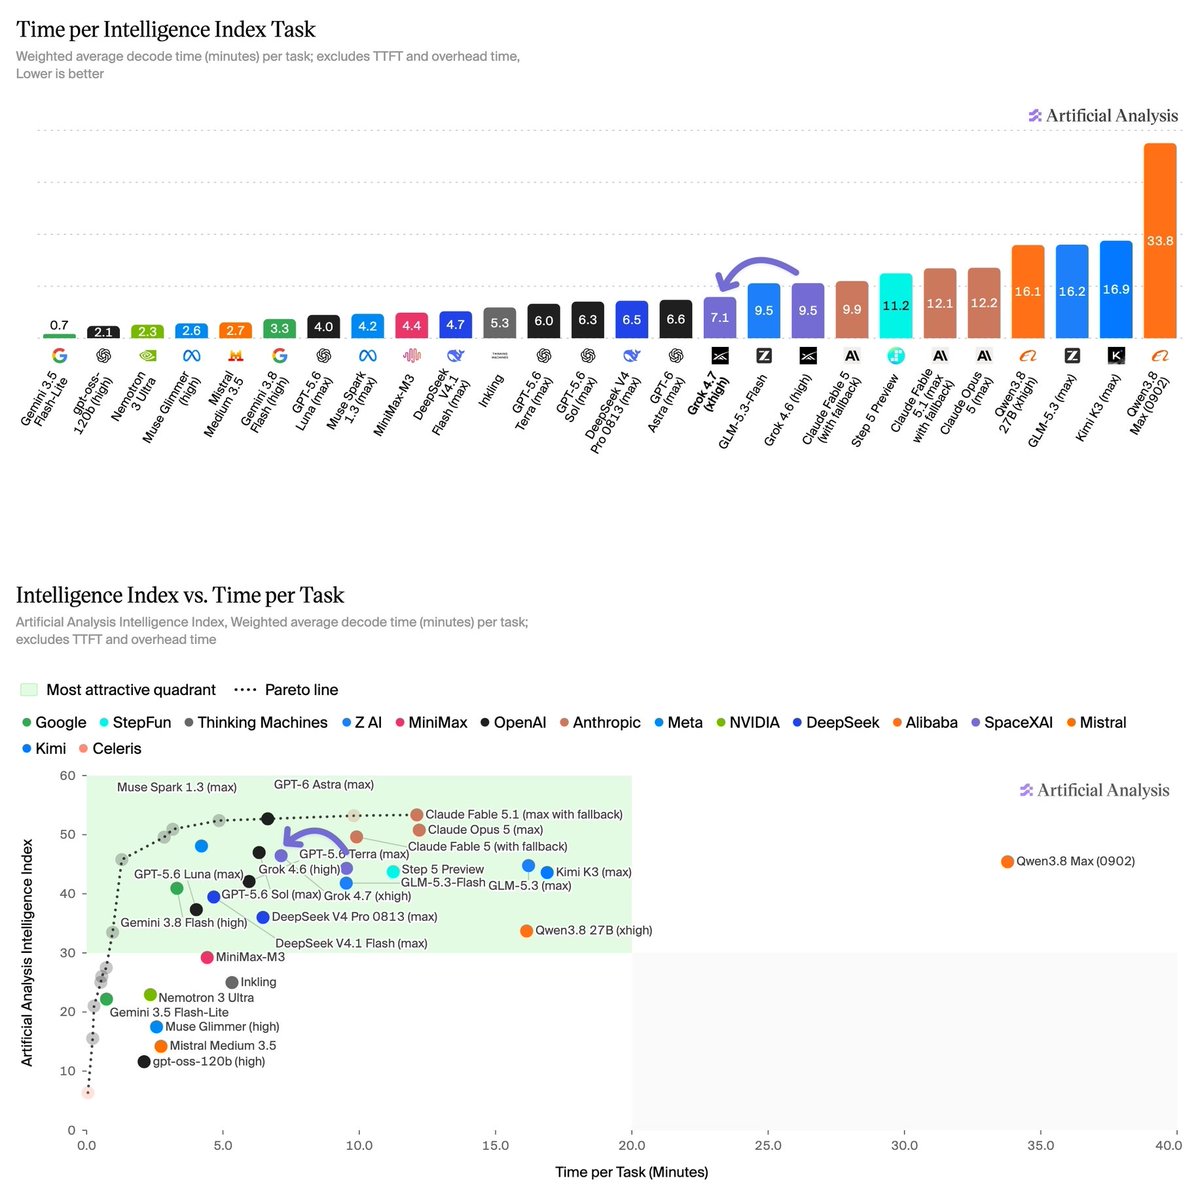
单任务输出 Token 数量增加了 125%,生成时间缩短至 7.1 分钟。更高的 Token 使用量意味着在相同单价下成本会增加。
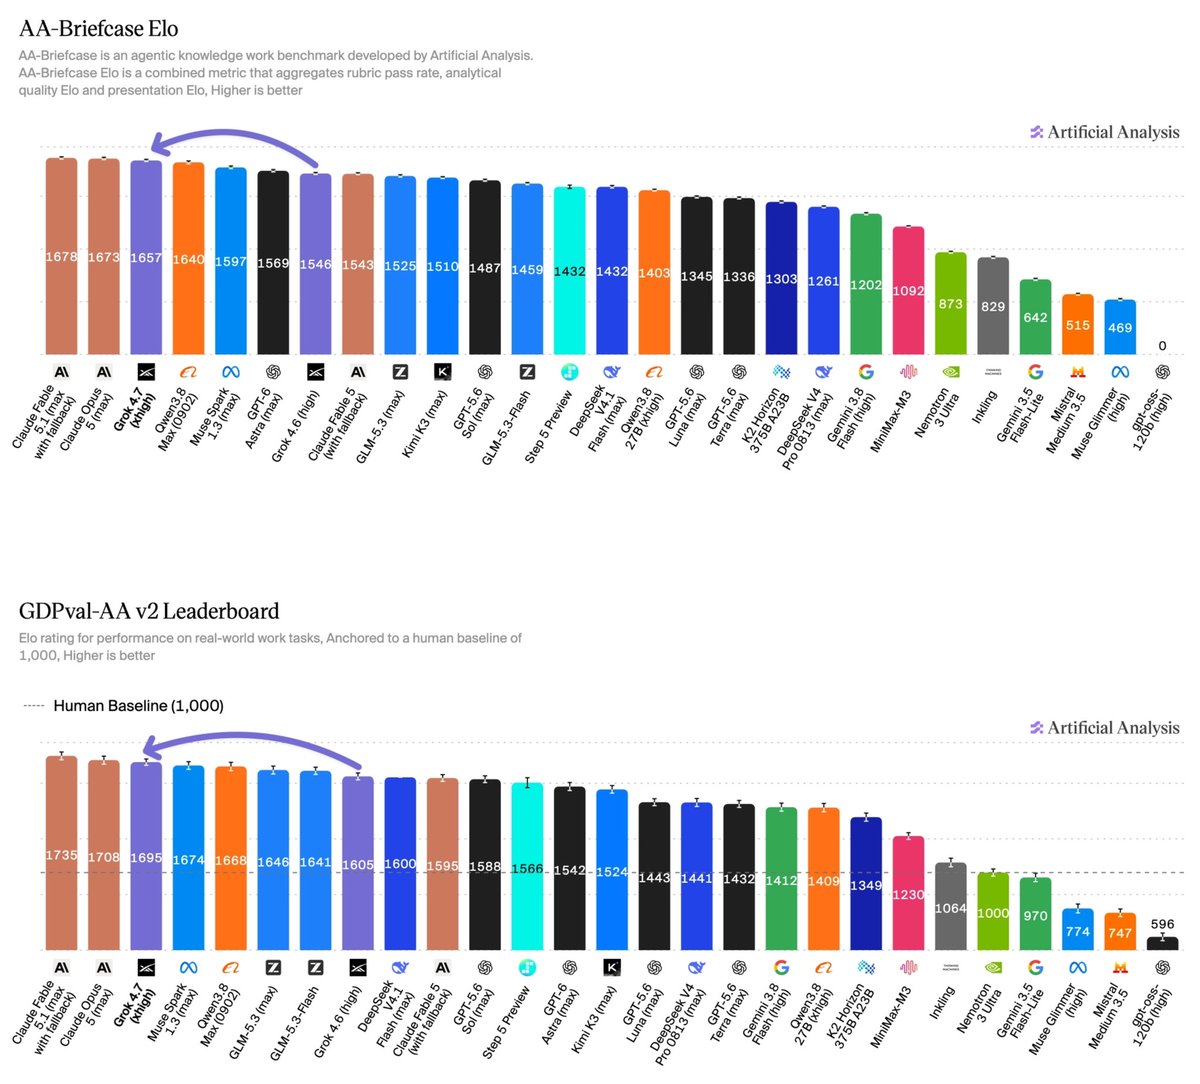
办公任务表现
在文档处理任务中,Grok 4.7 表现出色,分析质量大幅提升,但在结果呈现质量上略有下降。
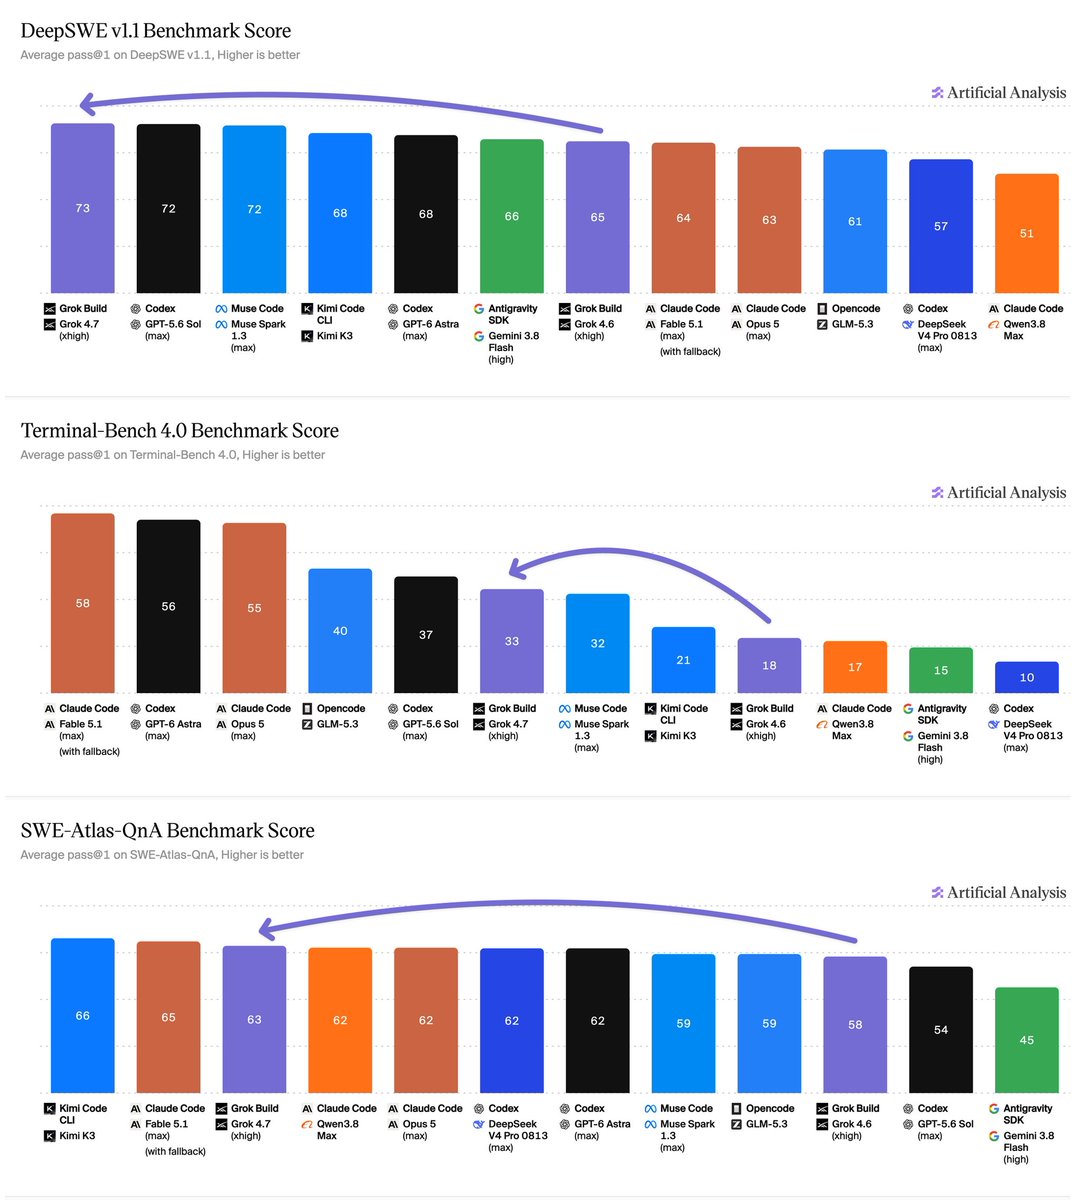
编程能力提升
编程代理指数从 47 升至 56,超过了 GPT-5.6 Sol,在多个编程基准测试中均有显著进步。
其他领域表现
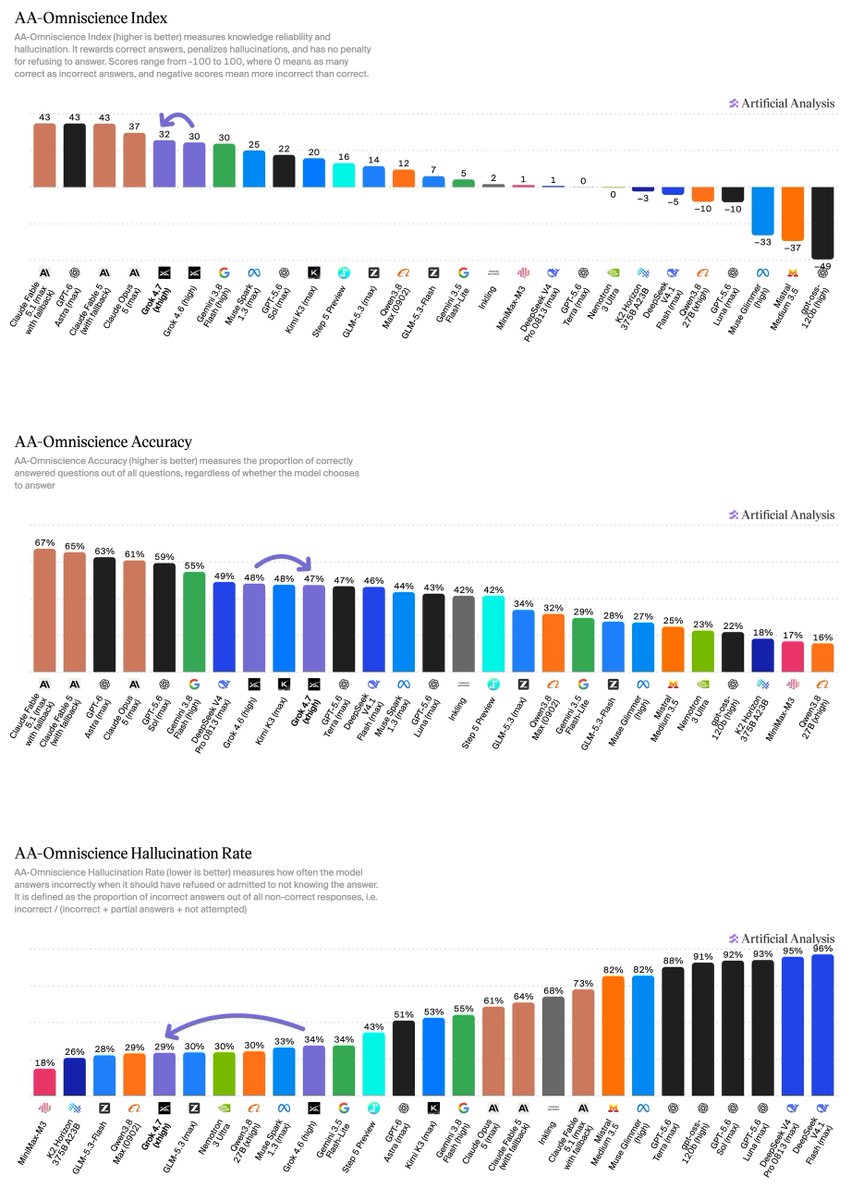
在长上下文推理等领域表现平平,甚至出现小幅下滑。幻觉率有所降低,但整体准确率保持不变。
API 定价
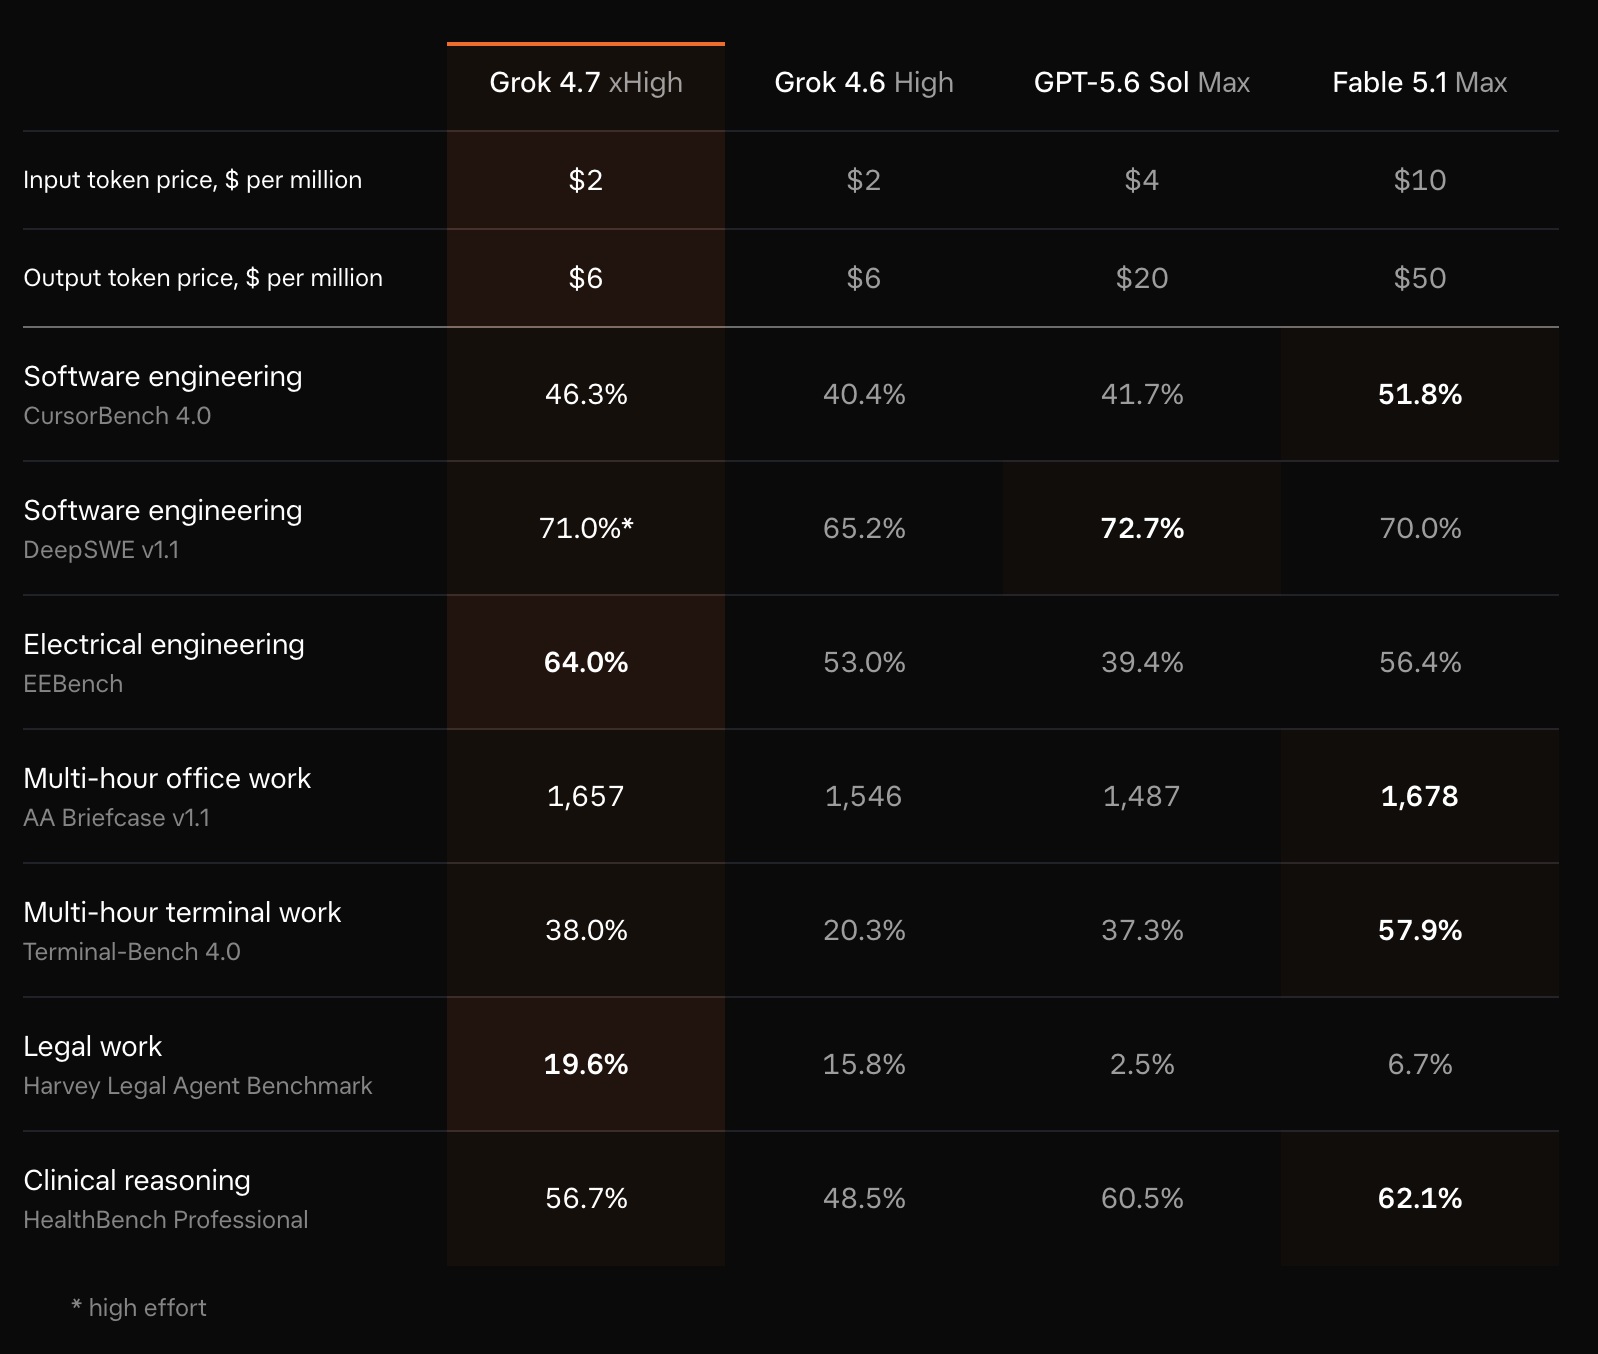
Grok 4.7 维持了极具竞争力的定价,每百万 Token 输入/输出分别为 2 美元和 6 美元。
成本效益分析
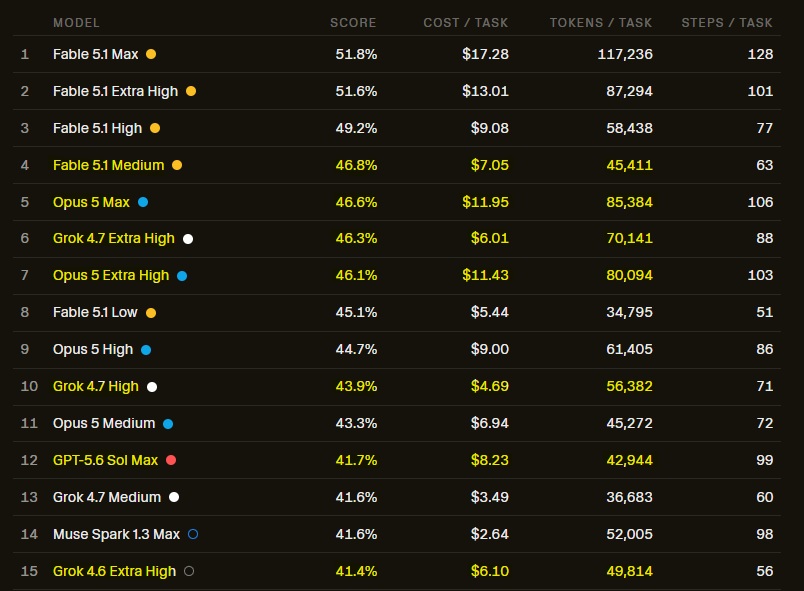
CursorBench 测试显示,在相似性能下,Grok 4.7 的成本低于 GPT-5.6 Sol,但在最高推理设置下,其他模型表现更优。
总结评价
Grok 4.7 在特定任务和成本控制上表现积极,但整体智能提升幅度未达预期,与顶级模型仍存在差距。
官方公告
有关 Grok 4.7 的详细发布信息可访问 x.ai 官方网站查看。
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-21
- Discovered via
- www.threads.com
前十名
付费推广
- 01Wallpets 86 点击量$125
- 02Walltank 106 点击量$85
- 03Chowder 55 点击量$50
- 04Falconer 47 点击量$45
- 05Lemonpod 87 点击量$40
- 06Menta 33 点击量$35
- 07Sway 30 点击量$30
- 08Peon-Ping 27 点击量$25
- 09Zeron 89 点击量$20
- 10Guideless 22 点击量$15