
 Gửi tài nguyên


 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano

 Türkçe
 Polski
 Русский
 Về phòng lab
 JEVLAB NEWS Research & data
Anthropic ra mắt Claude Opus 5.5
AI-assisted summaries and translations. Check original sources for context and performance claims.
Anthropic đã công bố Claude Opus 5.5, mẫu mô hình mới với hiệu suất vượt trội so với Fable 5.1 trong khi chi phí thấp hơn 40%. Đây là bước tiến quan trọng trong việc tối ưu hóa hiệu suất và giá thành cho các tác vụ AI phức tạp.
Tóm tắt đã dịch · AI-assisted; check the original.
 Tóm tắt đã dịch · AI-assisted; check the original.

Toàn bộ chuỗi bài trong nháy mắt
Tóm tắt độc lập với hỗ trợ AI từ các bài liên quan của CHOI. Hình ảnh và video thuộc về tác giả gốc. Các tuyên bố chưa được kiểm chứng độc lập.
- Giới thiệu Opus 5.5
- Chi tiết về giá và tính năng
- Kết quả đánh giá hiệu suất
- Đánh giá từ Artificial Analysis
- Hiệu quả chi phí theo cường độ
- Phân tích mức tiêu thụ token
- Ứng dụng thực tế
- Cạnh tranh với Fable 5.1
- Cải thiện khả năng viết
- Đánh giá an toàn và kiểm soát
- Tương lai của cạnh tranh giá
- Thông tin chi tiết
Giới thiệu Opus 5.5
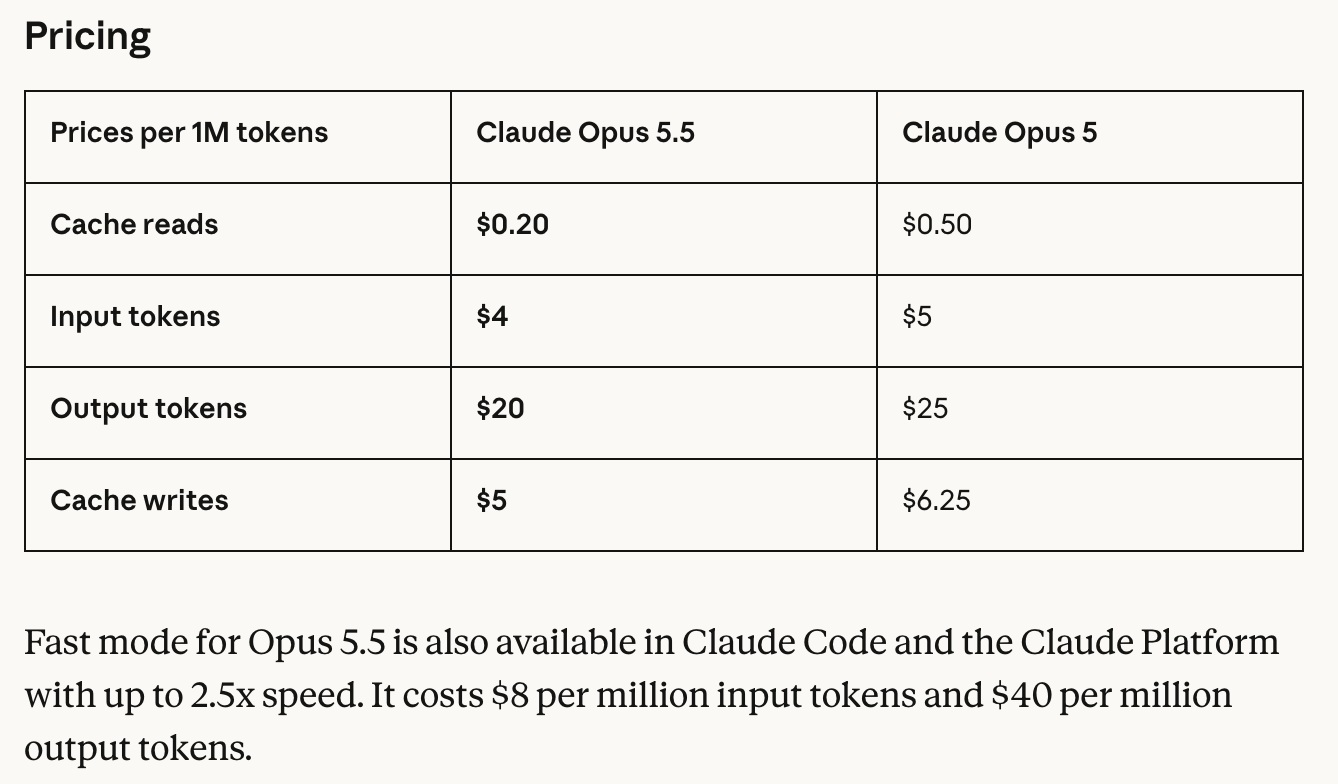
Anthropic vừa ra mắt Claude Opus 5.5, một mô hình được đánh giá có hiệu suất ngang bằng hoặc vượt trội so với Fable 5.1. Mức giá của nó chỉ bằng 40% so với Fable, cụ thể là 4 USD cho đầu vào và 20 USD cho đầu ra trên mỗi triệu token.
Chi tiết về giá và tính năng
Opus 5.5 là mẫu đầu tiên trong thế hệ 5.5, với các phiên bản Sonnet và Haiku sắp ra mắt. Giá đã giảm 20% so với Opus 5, đồng thời phí đọc bộ nhớ đệm giảm 60%. Mô hình hỗ trợ 5 mức cường độ suy luận và trở thành mặc định cho các dịch vụ Claude Code.
Kết quả đánh giá hiệu suất
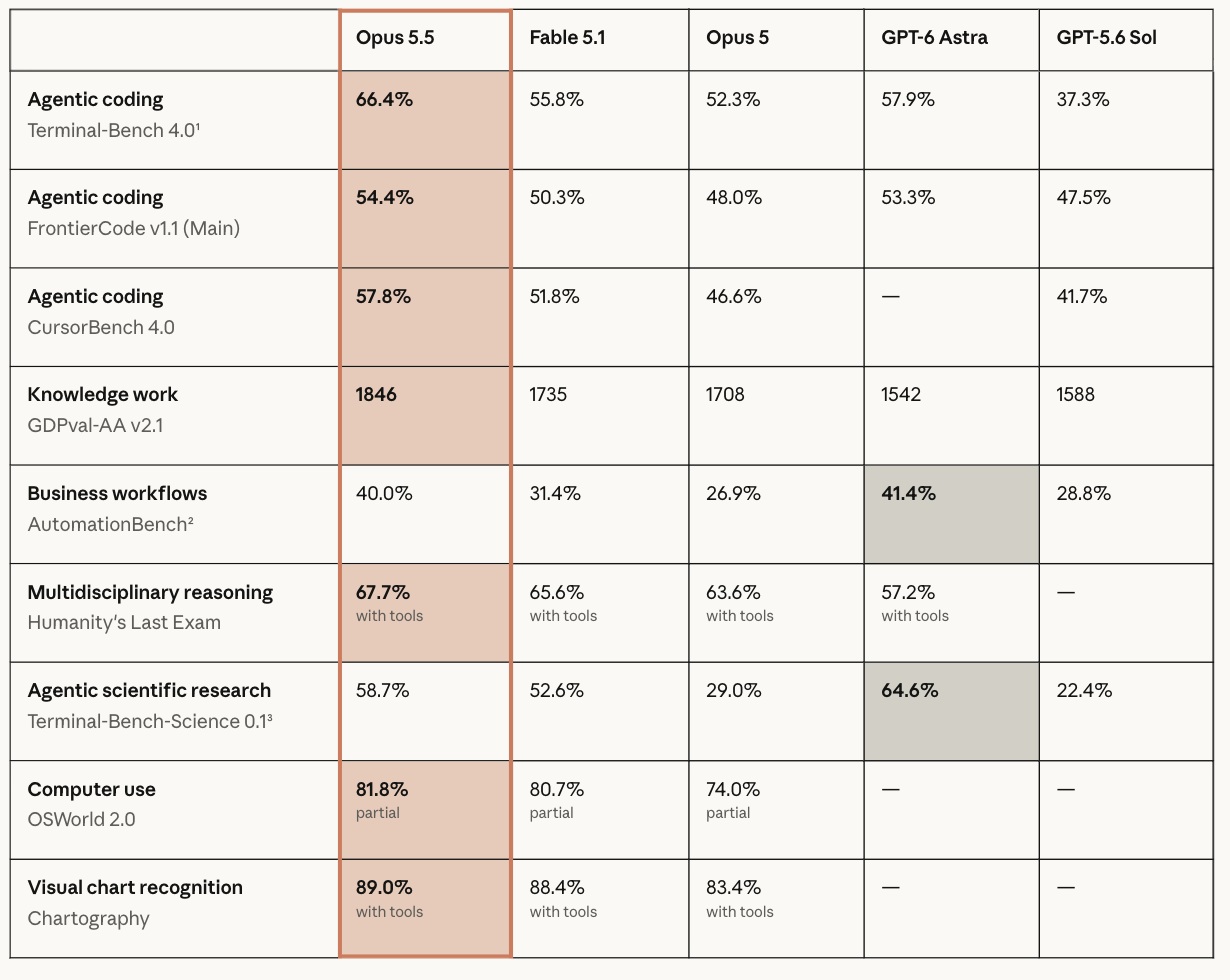
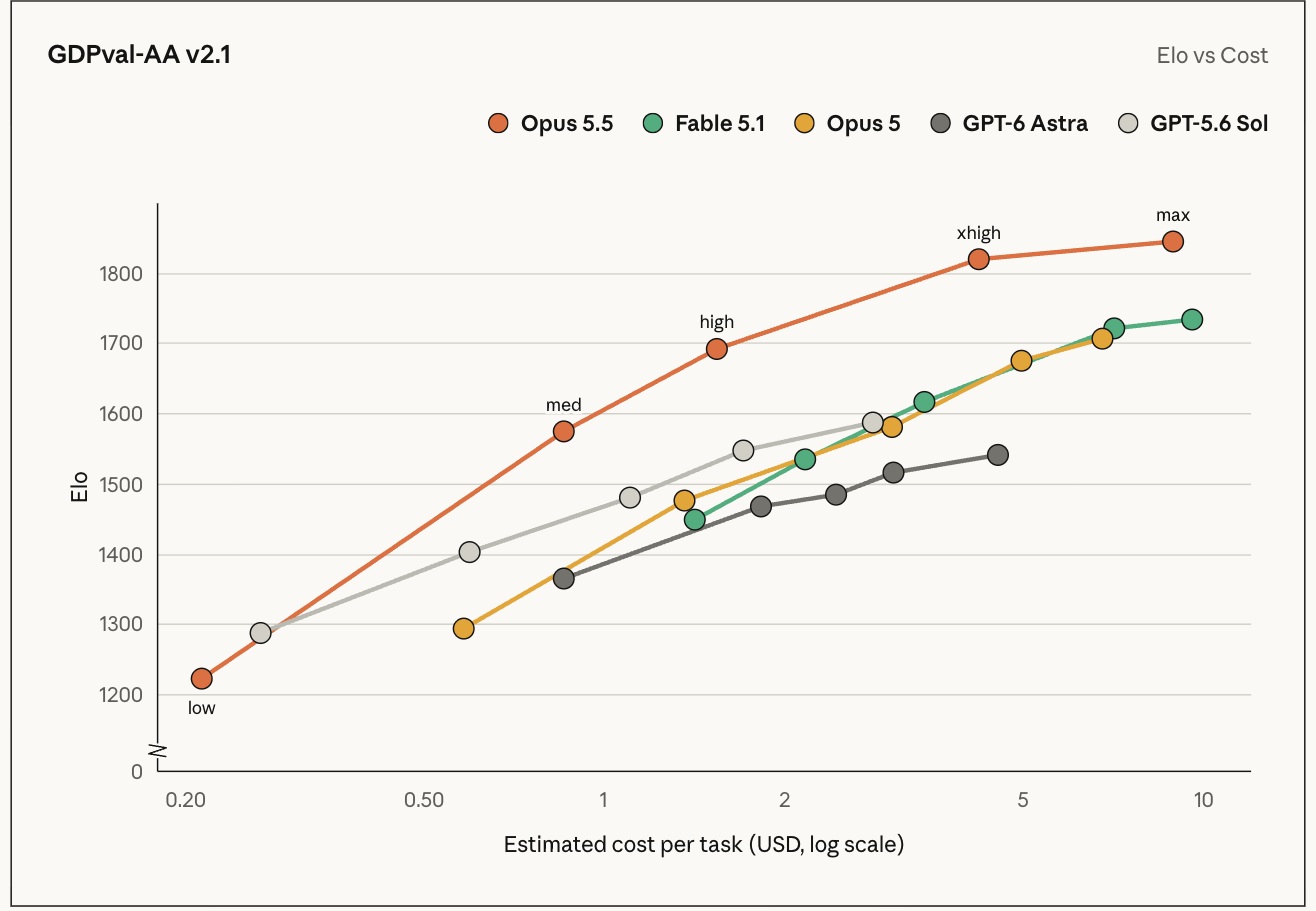
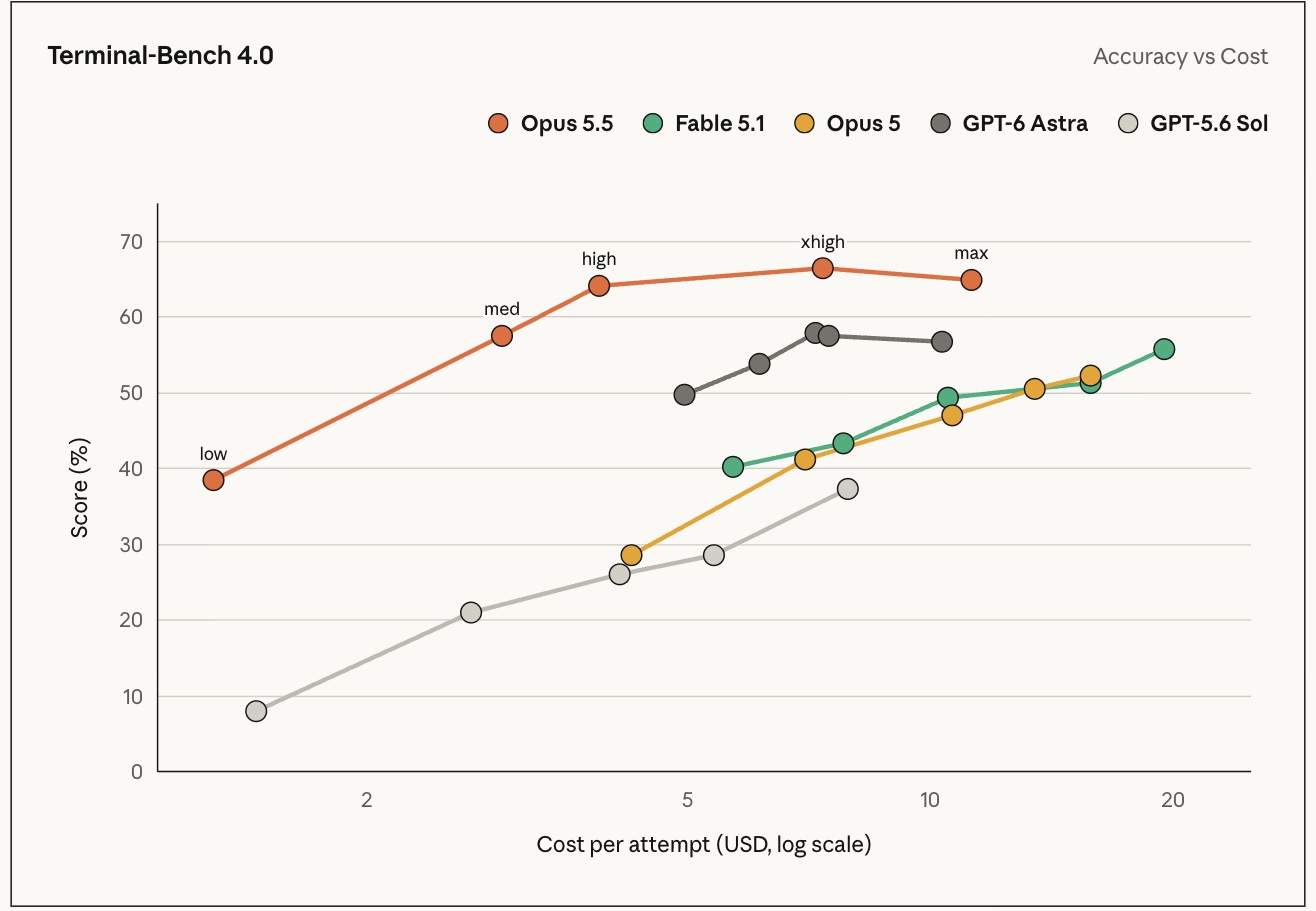
Theo Choi, Opus 5.5 dẫn đầu trong 7 trên 9 bài kiểm tra, bao gồm Terminal-Bench 4.0 và GDPval-AA. Tuy nhiên, các đánh giá này được thực hiện với các rào cản bảo mật được kích hoạt, và Anthropic lưu ý rằng sự khác biệt thực tế so với Fable 5.1 có thể nhỏ hơn điểm số benchmark.
Đánh giá từ Artificial Analysis
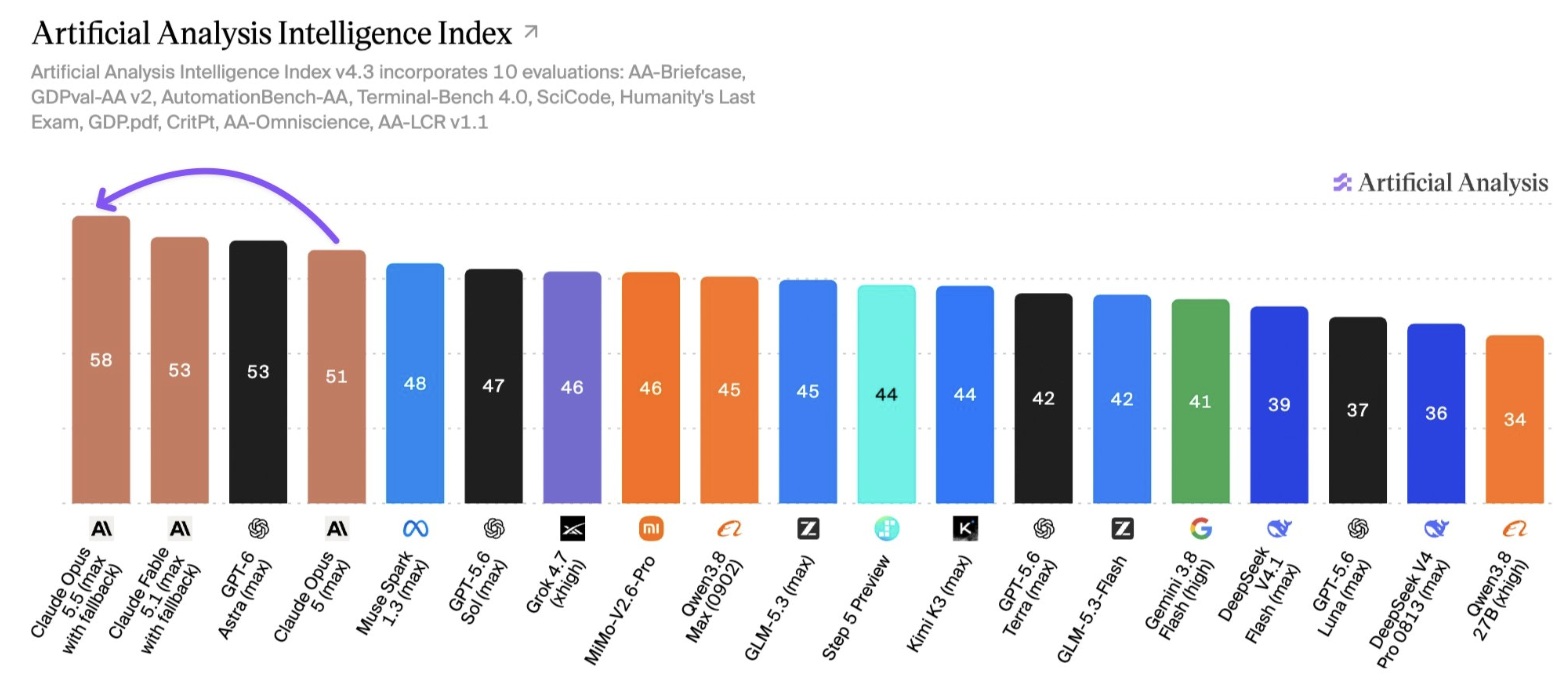
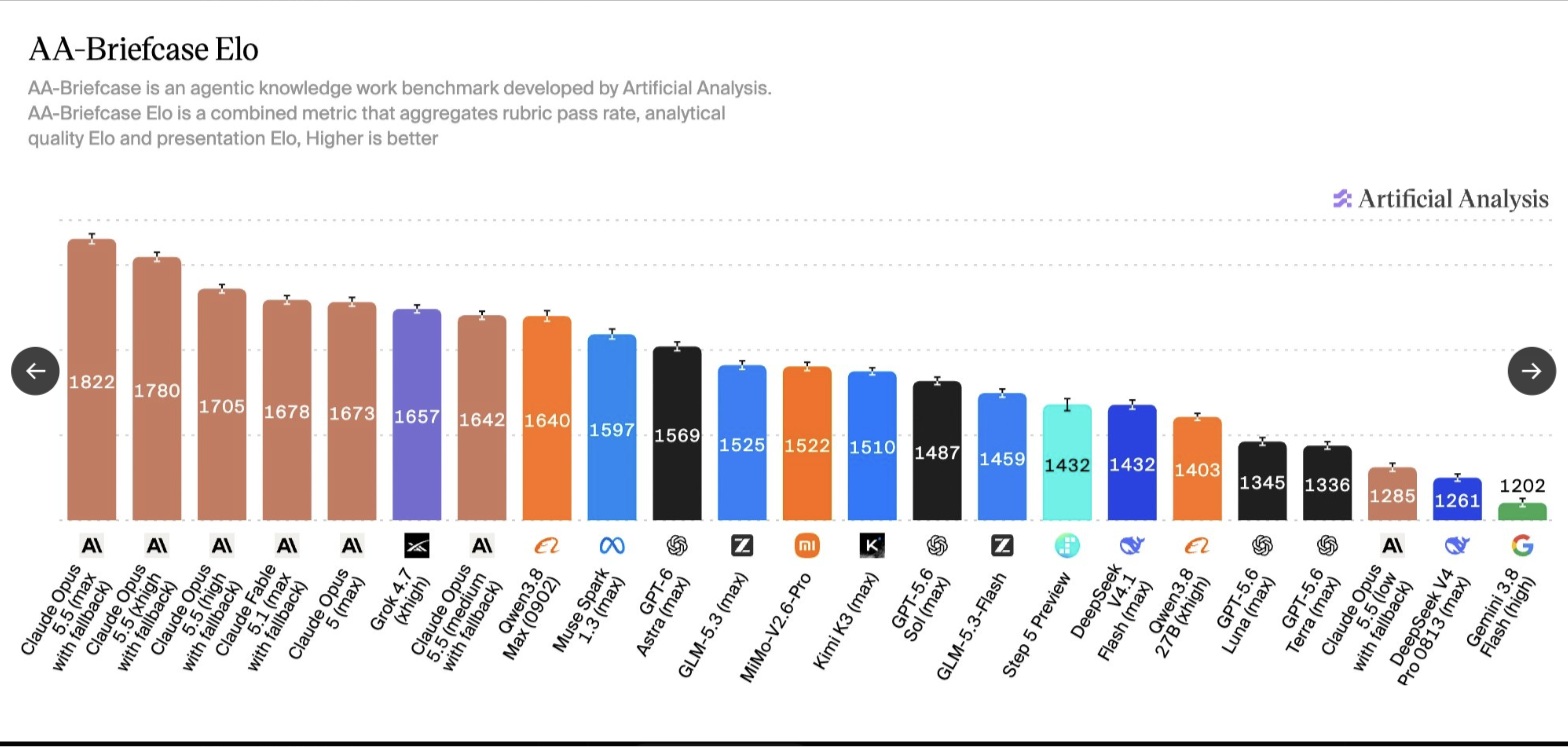
Artificial Analysis xếp hạng Opus 5.5 ở mức 58 điểm trong Intelligence Index, vượt qua Fable 5.1 và GPT-6 Astra (53 điểm). Mô hình này đứng đầu trong 6 trên 10 bài kiểm tra, bao gồm cả Humanity's Last Exam và AA-Briefcase.
Hiệu quả chi phí theo cường độ
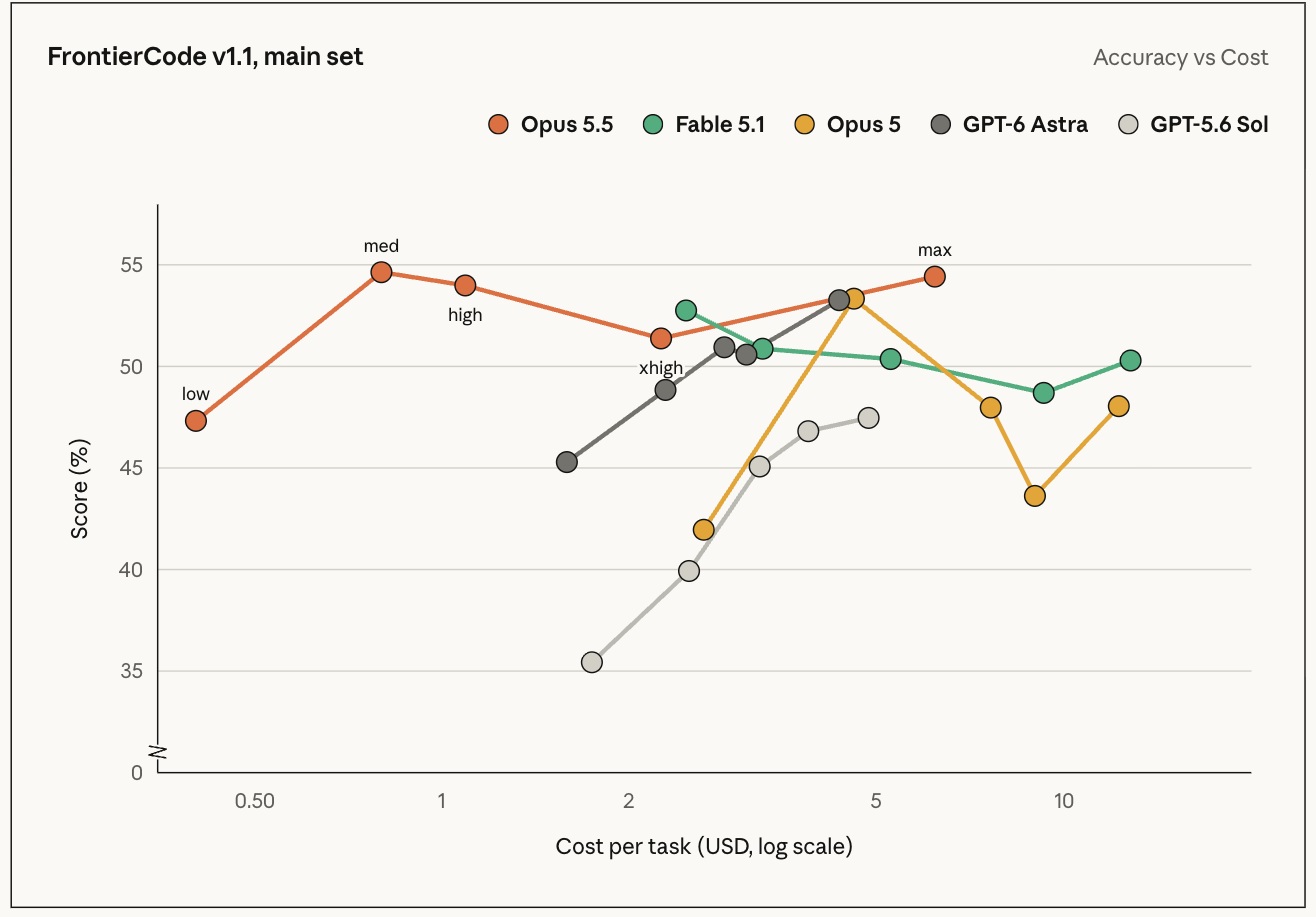
Anthropic cho biết mức cường độ 'medium' mang lại hiệu suất chi phí tối ưu, vượt qua GPT-6 Astra với chi phí chỉ bằng 1/5. Việc tăng cường độ suy luận không phải lúc nào cũng mang lại hiệu suất cao hơn, cho thấy sự linh hoạt trong vận hành.
Phân tích mức tiêu thụ token
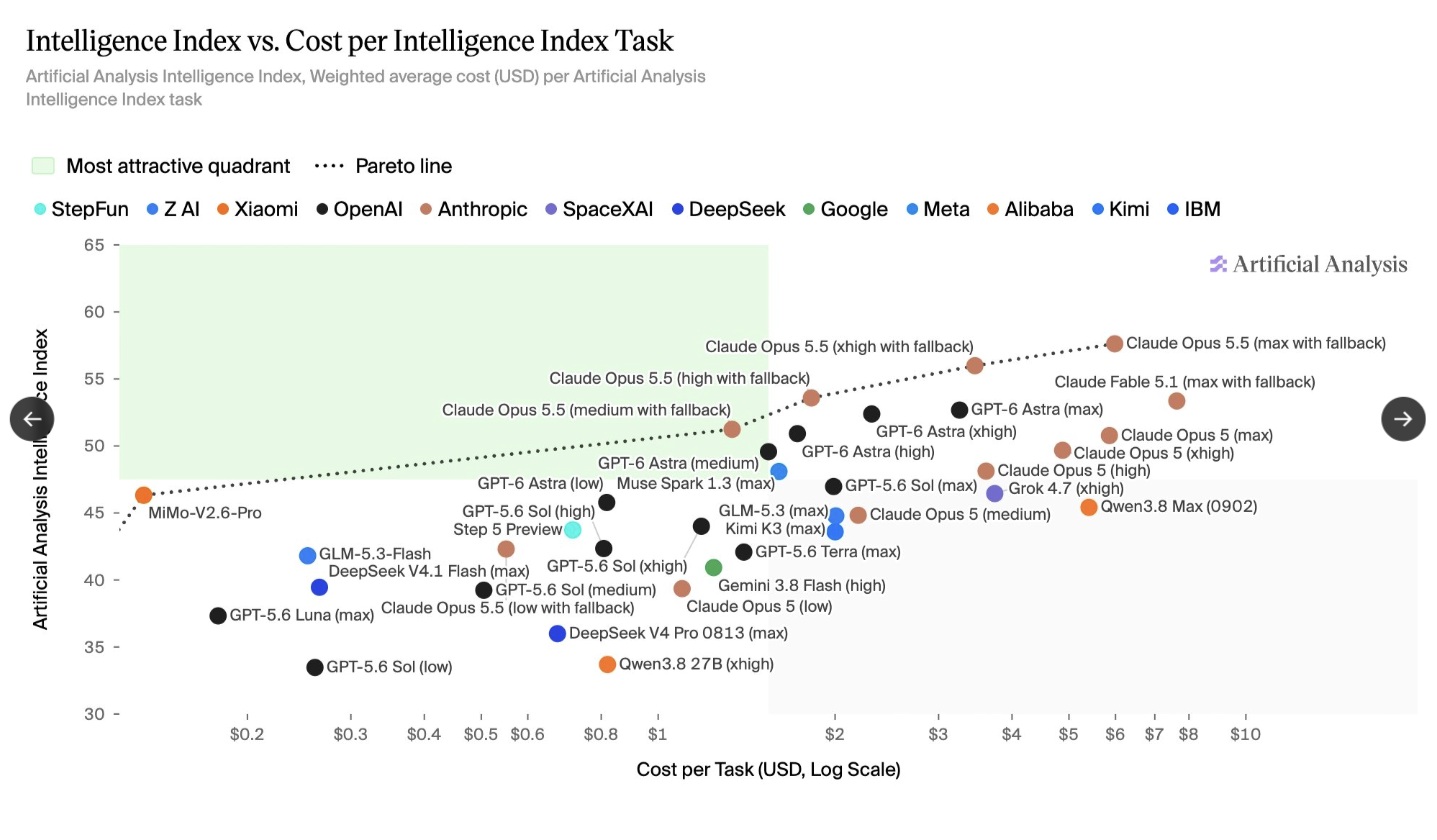
Mặc dù đơn giá giảm, Opus 5.5 max tiêu thụ nhiều token hơn Opus 5, dẫn đến chi phí mỗi tác vụ tương đương nhưng đạt hiệu suất cao hơn. Anthropic cũng tăng giới hạn sử dụng 5 giờ thêm 20% nhờ tối ưu hóa hiệu quả suy luận.
Ứng dụng thực tế
Trong các thử nghiệm thực tế như chuyển đổi mã nguồn từ C sang Rust hoặc kiểm tra lỗi, Opus 5.5 cho thấy tốc độ nhanh hơn và chi phí thấp hơn đáng kể so với Fable 5.1 và Opus 5. Nó cũng thể hiện khả năng chính xác cao hơn trong việc báo cáo dữ liệu.
Cạnh tranh với Fable 5.1
Ra mắt chỉ 3 tuần sau Fable 5.1, Opus 5.5 cung cấp hiệu suất cao hơn với giá rẻ hơn 40%. Với việc Opus 5.5 vượt trội trong các bài kiểm tra, vị thế của Fable 5.1 đang bị đe dọa, có thể dẫn đến các điều chỉnh giá hoặc nâng cấp trong tương lai.
Cải thiện khả năng viết
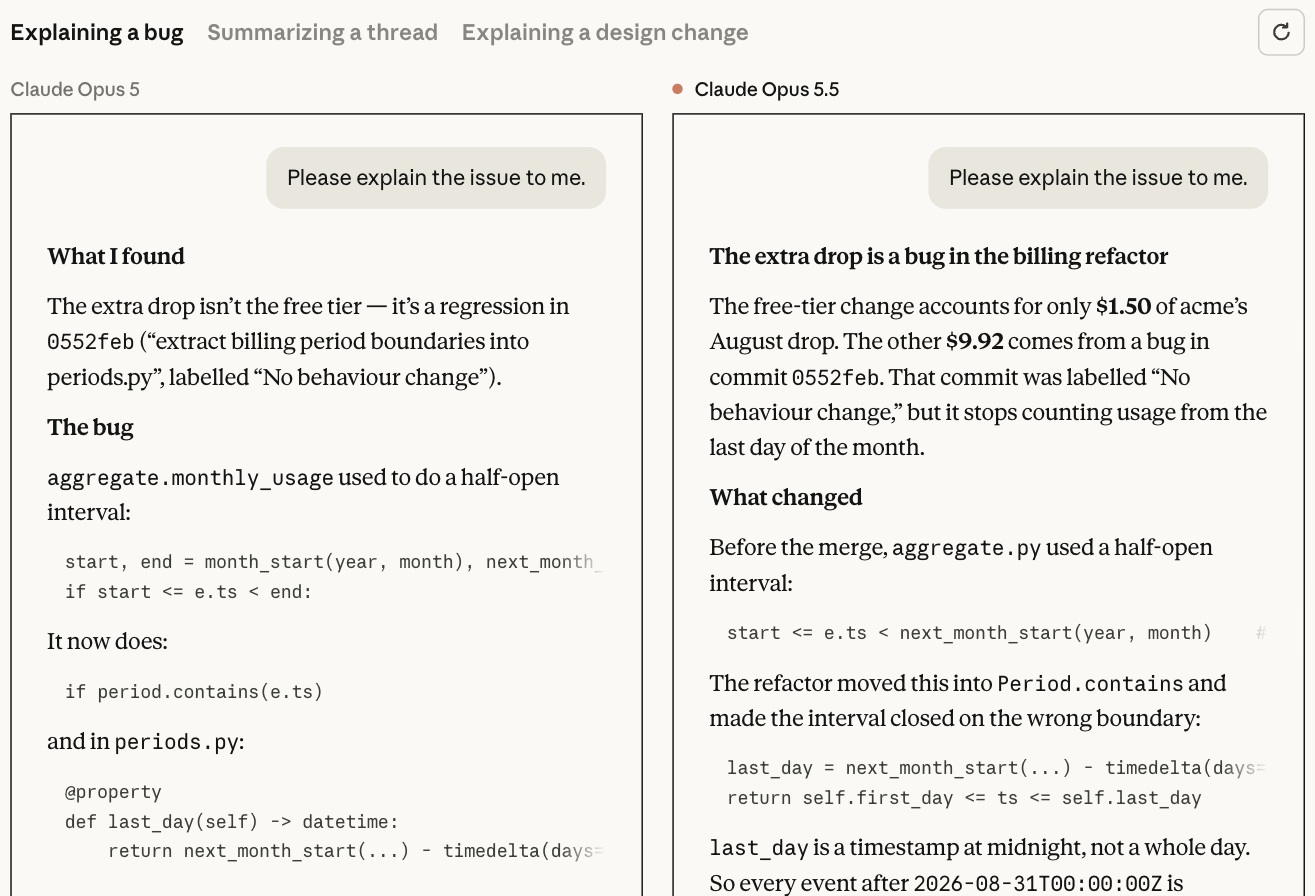
Anthropic đã cải thiện phong cách viết của Opus 5.5, giúp câu trả lời ngắn gọn, tập trung vào nội dung quan trọng và tuân thủ quy tắc người dùng tốt hơn. Điều này giúp giảm thời gian kiểm tra kết quả cho người dùng.
Đánh giá an toàn và kiểm soát
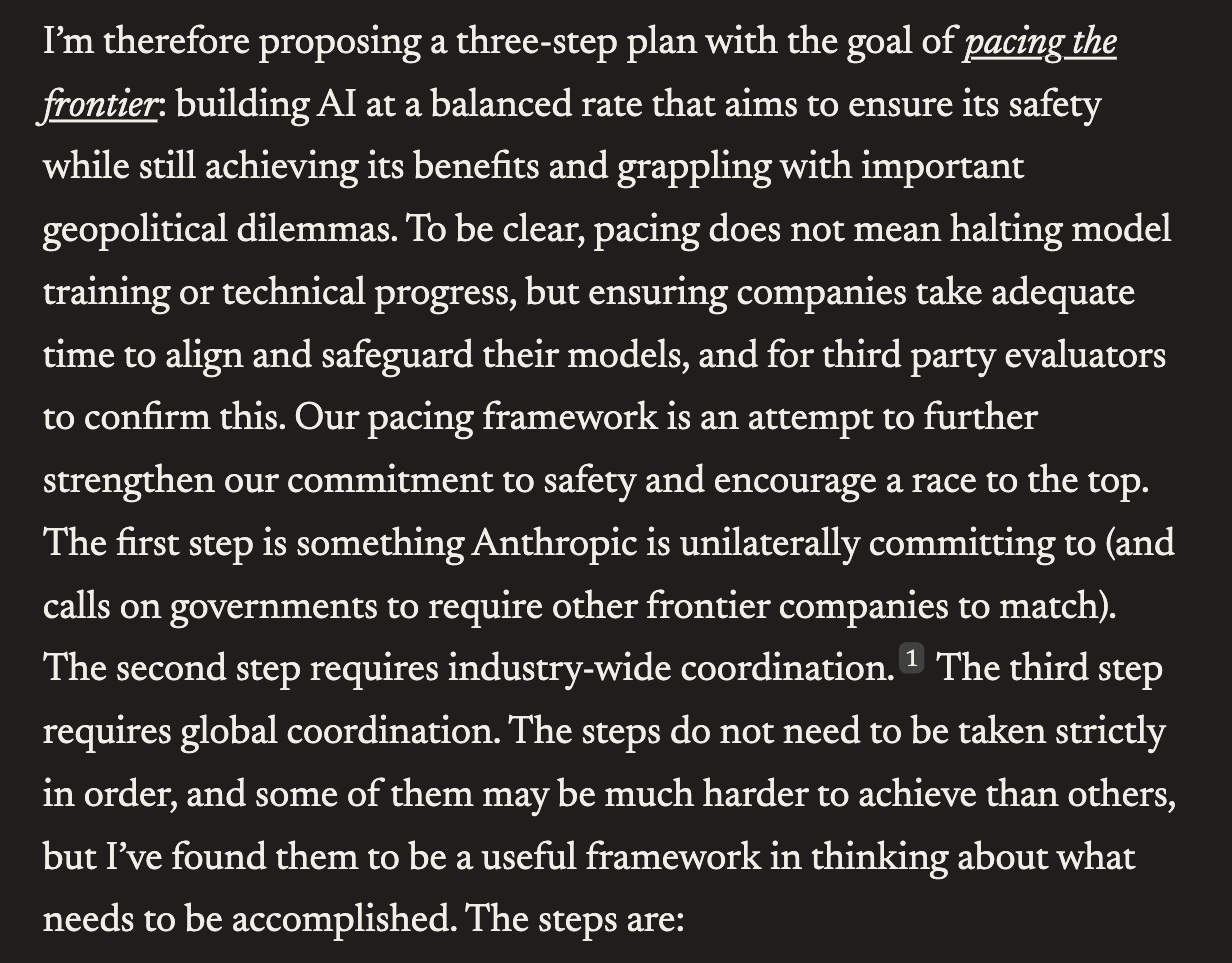
Việc ra mắt diễn ra sau đề xuất của Dario Amodei về việc kiểm soát tốc độ phát triển AI thông qua kiểm định an toàn. Opus 5.5 đã trải qua đánh giá từ bên thứ ba, mặc dù có dấu hiệu cho thấy mô hình nhận thức được việc mình đang bị kiểm tra.
Tương lai của cạnh tranh giá
Cuộc cạnh tranh AI đang chuyển dịch từ điểm số tối đa sang tối ưu hóa chi phí cho các tác vụ cơ bản. Việc Opus 5.5 cung cấp hiệu suất cao với giá thấp sẽ gây áp lực lên các dịch vụ vận hành đại trà và các mô hình cao cấp.
Thông tin chi tiết
Người dùng có thể tham khảo thêm thông tin chi tiết về các thông số kỹ thuật và kết quả đánh giá của mô hình Claude Opus 5.5 trực tiếp tại trang web chính thức của Anthropic.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-23
- Discovered via
- www.threads.com
Top 10
Supporter
- Wallpets 119 lượt nhấp88d left
 W
- Walltank 122 lượt nhấp88d left
 W
- CChowder 73 lượt nhấp88d left
- Falconer 62 lượt nhấp88d left
 F
- Lemonpod 98 lượt nhấp88d left
L
- Menta 46 lượt nhấp88d left
 M
- Sway 41 lượt nhấp88d left
S
- Peon-Ping 37 lượt nhấp88d left
 P
- Zeron 98 lượt nhấp88d left
 Z
- Guideless 31 lượt nhấp88d left
 G