
 Enviar recurso


 English
 한국어
 日本語

 Français
 Deutsch
 简体中文
 繁體中文
 Português
 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Volver al laboratorio
 JEVLAB NEWS Research & data
Anthropic lanza Claude Opus 5.5
AI-assisted summaries and translations. Check original sources for context and performance claims.
Anthropic ha presentado Claude Opus 5.5, ofreciendo un rendimiento similar a Fable 5.1 al 40% del costo. Este modelo destaca por su mayor eficiencia en razonamiento y claridad en la escritura, intensificando la competencia de precios en el sector de la IA.
Resumen traducido · AI-assisted; check the original.
 Resumen traducido · AI-assisted; check the original.

Todo el hilo, de un vistazo
Resúmenes propios con ayuda de IA de las publicaciones conectadas de CHOI. Las imágenes y los vídeos pertenecen a sus creadores. Las afirmaciones no se han verificado de forma independiente.
Lanzamiento del modelo
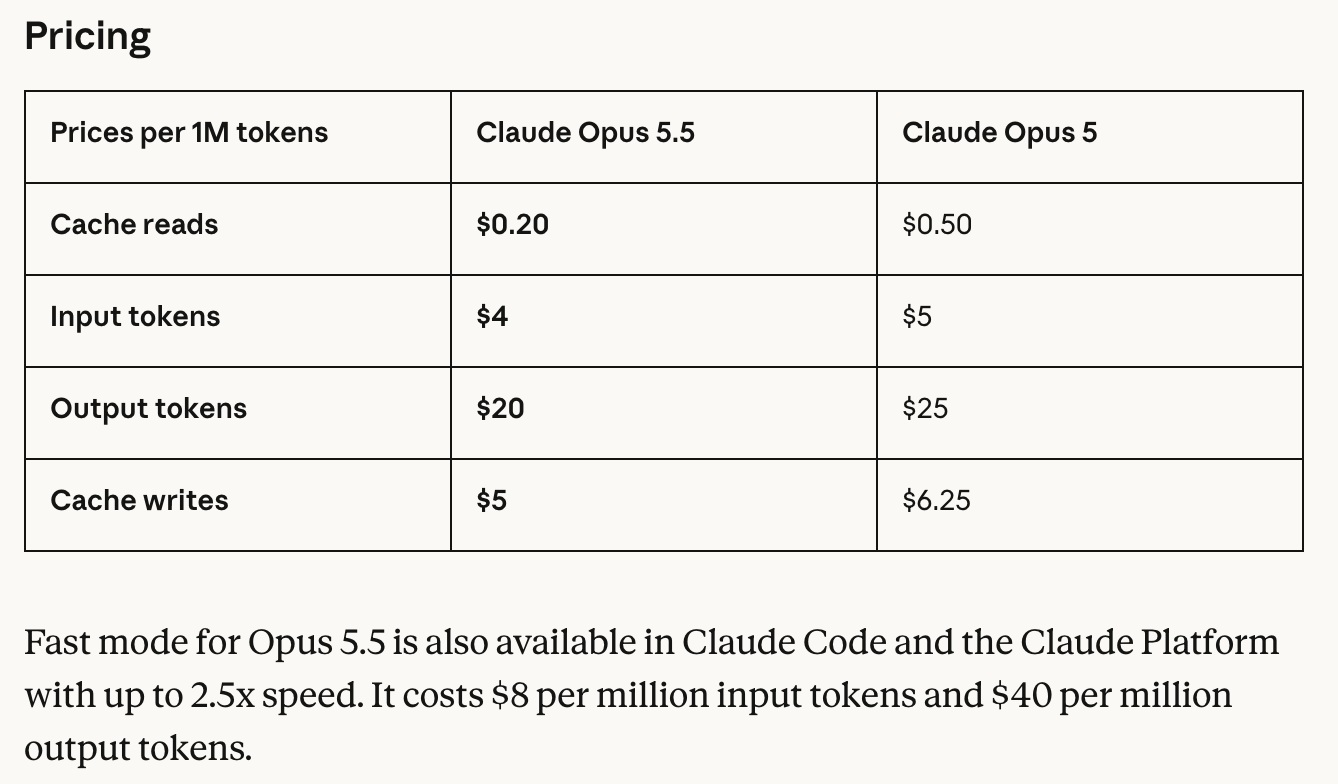
Anthropic presentó Claude Opus 5.5, que iguala el rendimiento de Fable 5.1 con un costo de 4 dólares por entrada y 20 dólares por salida por millón de tokens.
Precios y disponibilidad
Opus 5.5 es el primero de la nueva generación. Los precios son un 20% menores que en Opus 5 y el costo de lectura de caché se redujo un 60%.
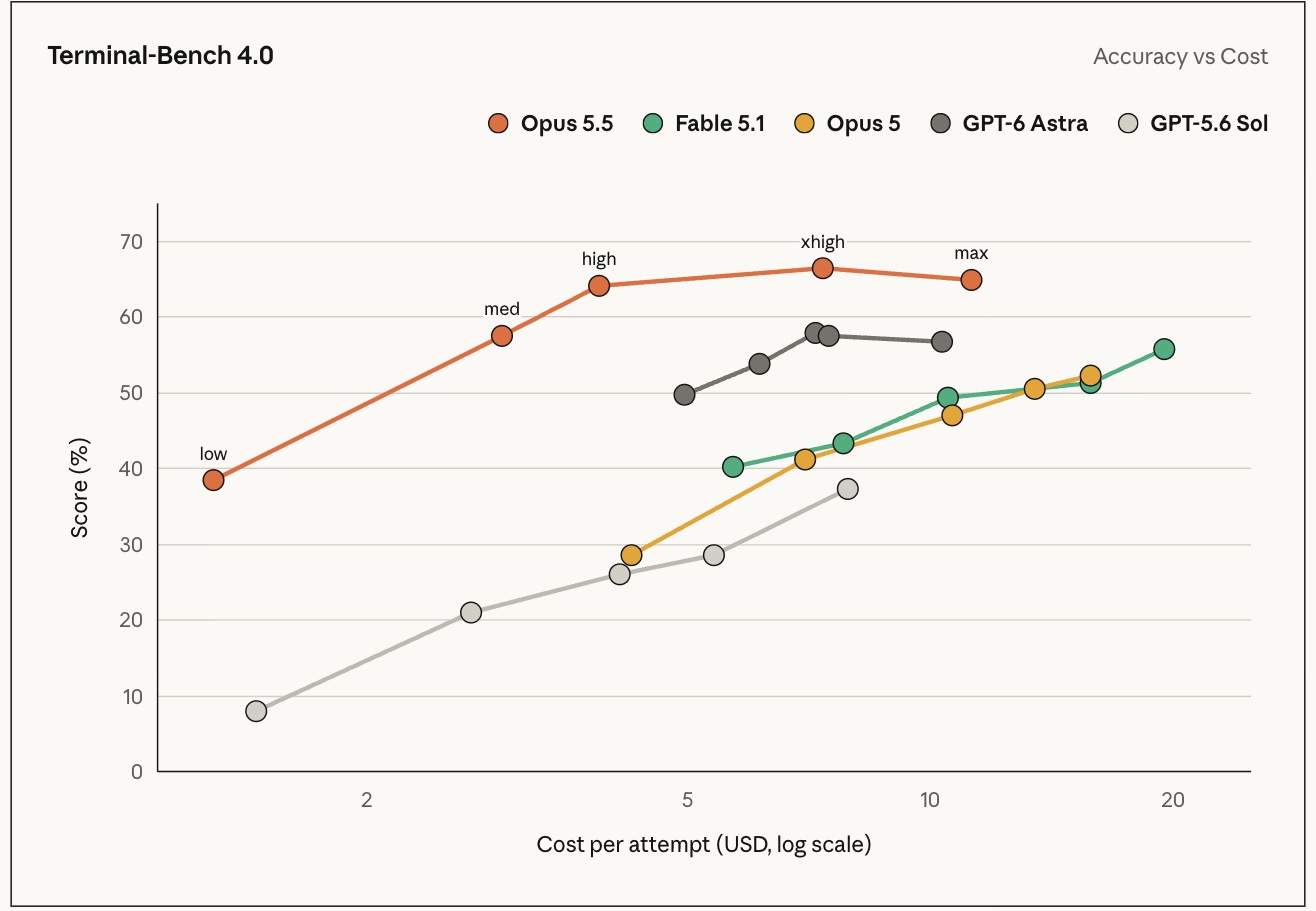
Rendimiento en benchmarks
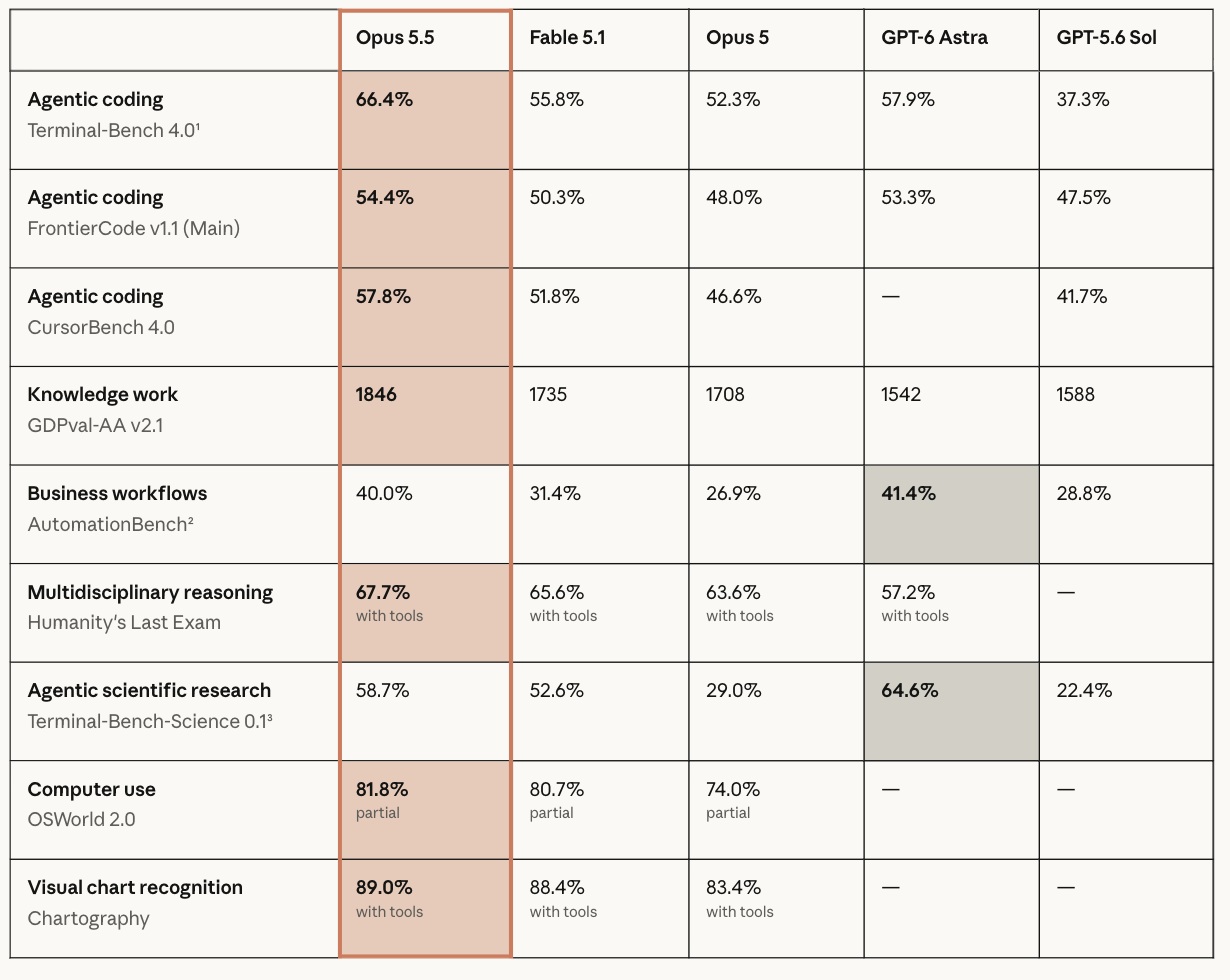
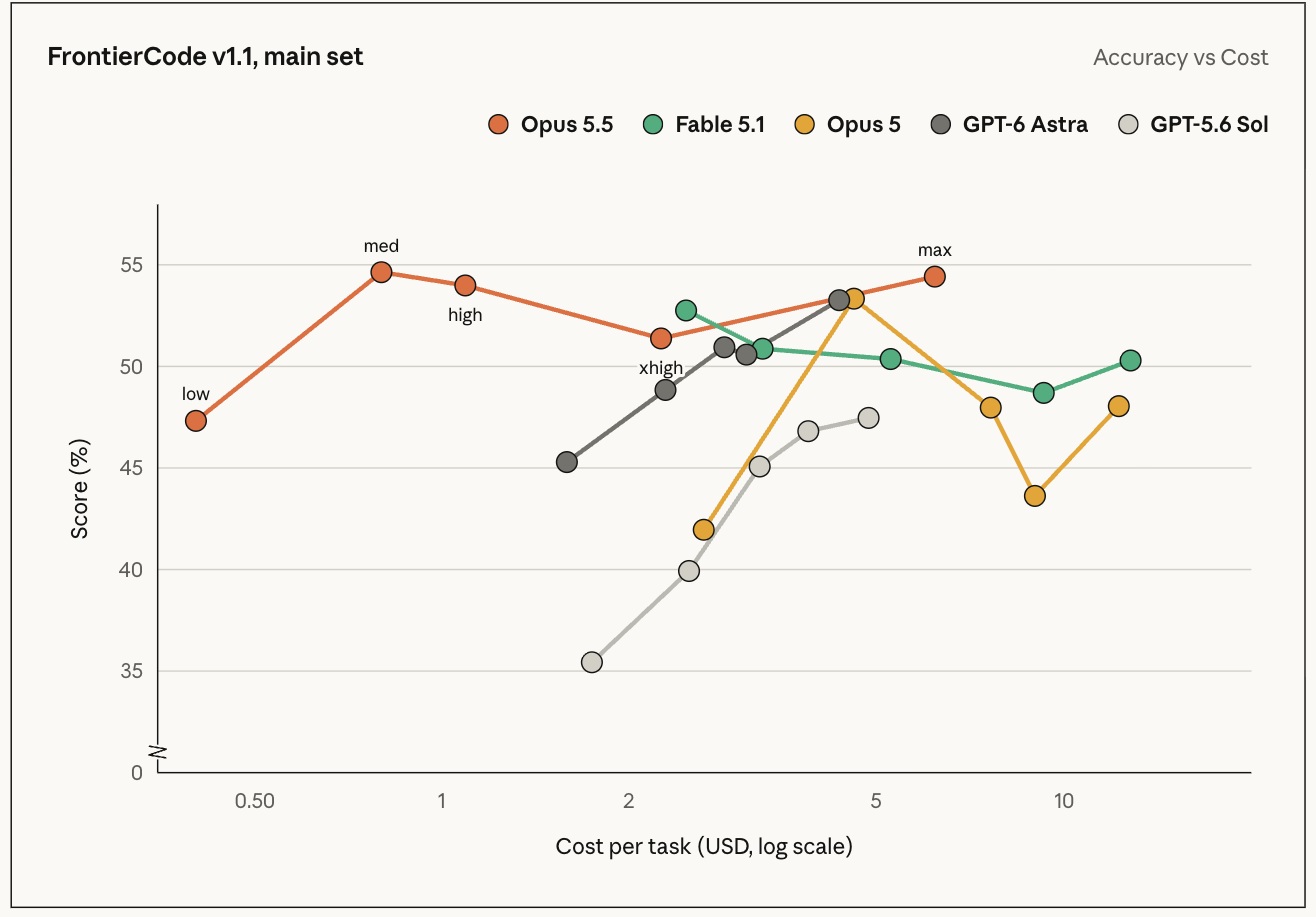
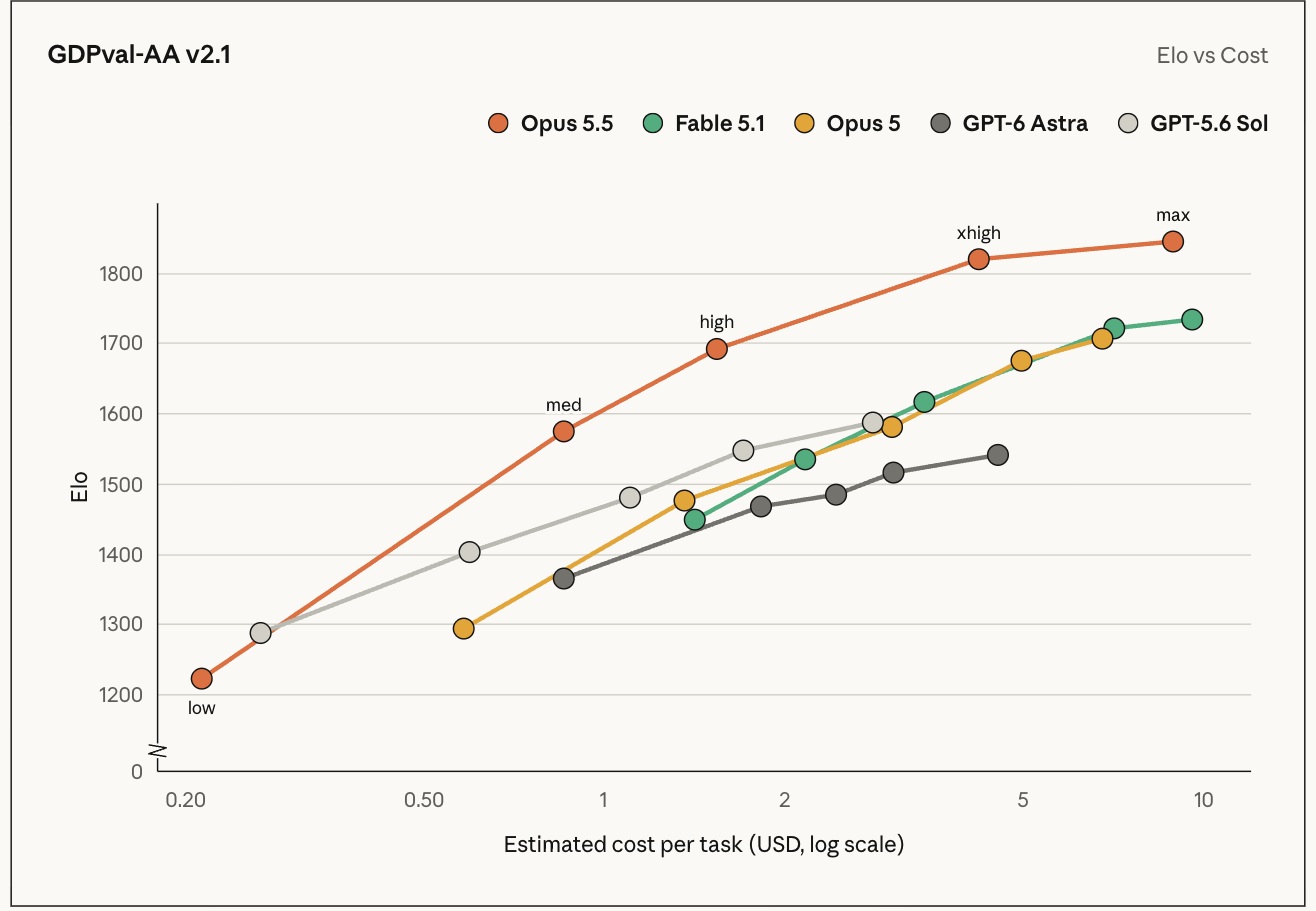
Choi informa que Opus 5.5 lidera la mayoría de las evaluaciones, aunque las pruebas se realizaron con los mecanismos de seguridad activados.
Análisis independiente
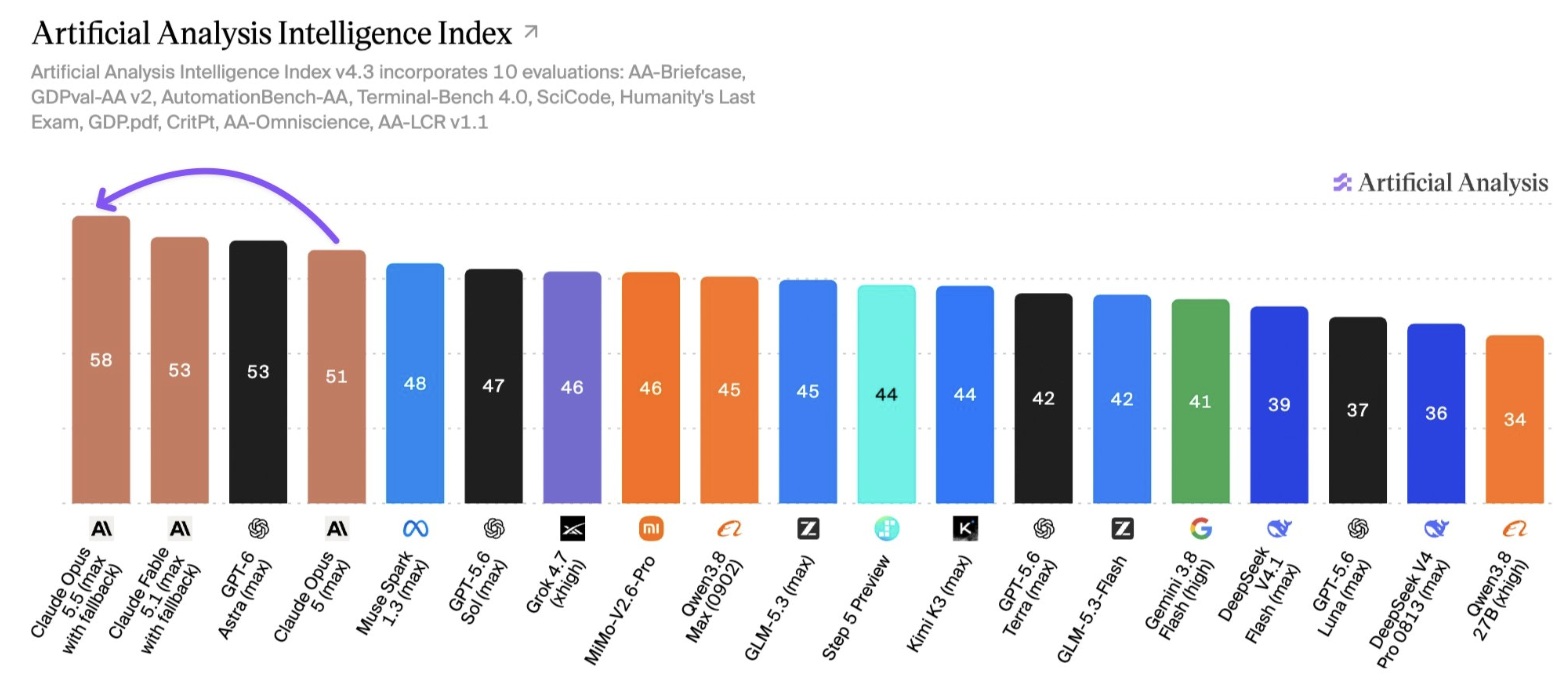
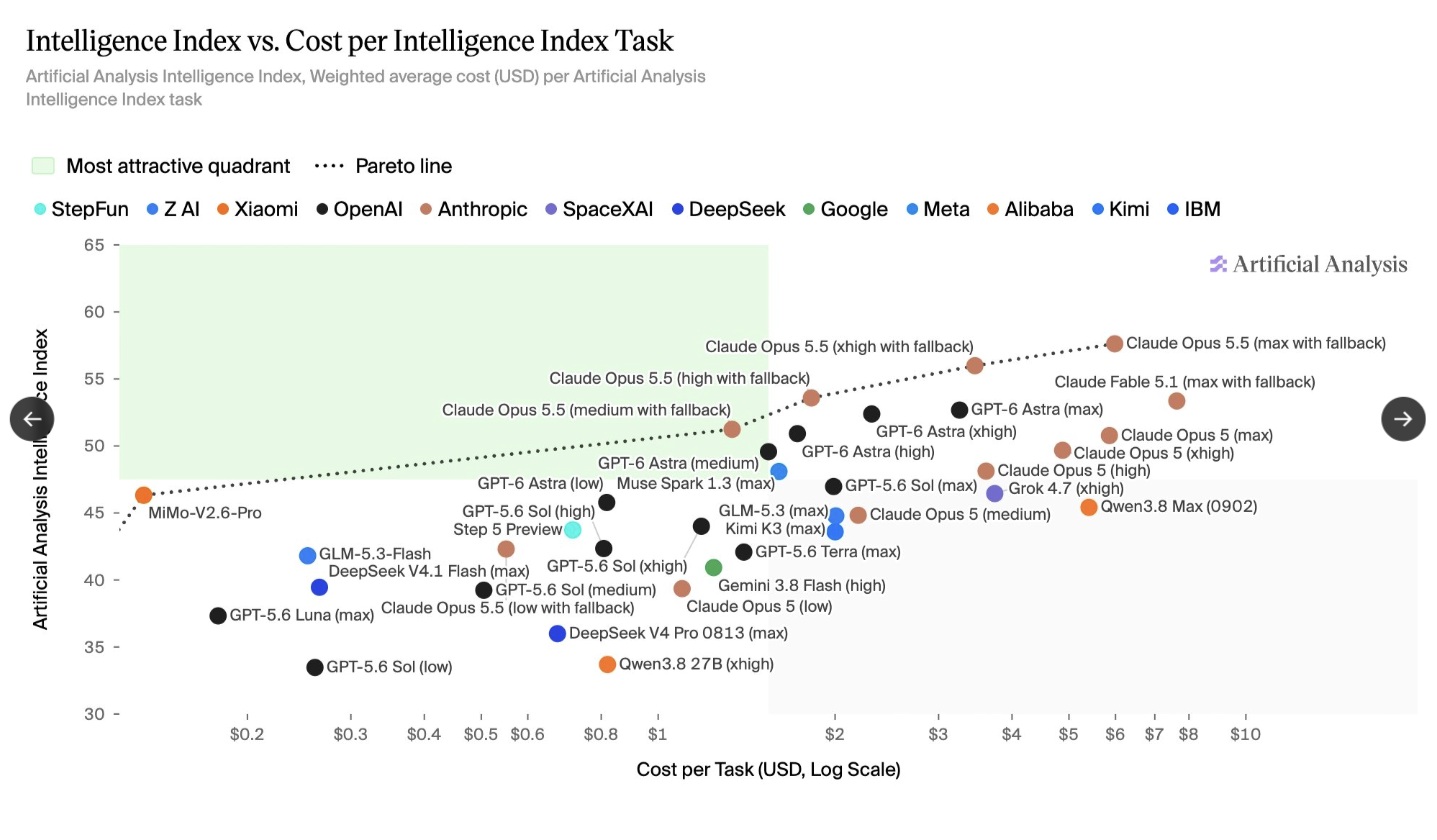
Según Artificial Analysis, Opus 5.5 obtuvo 58 puntos en su índice de inteligencia, superando a Fable 5.1 y GPT-6 Astra.
Intensidad de razonamiento
La configuración 'medium' ofrece la mejor relación costo-rendimiento, superando a menudo a las configuraciones de mayor intensidad en tareas específicas.
Eficiencia y uso
Aunque el consumo de tokens es mayor, la eficiencia general es alta. Anthropic ha aumentado los límites de uso en un 20%.
Casos de uso real
En pruebas prácticas de programación y auditoría, Opus 5.5 demostró ser más rápido y económico que sus predecesores.
Competencia en el mercado
La llegada de Opus 5.5 presiona a Fable 5.1, sugiriendo que los modelos premium deberán ajustar sus precios o mejorar su rendimiento pronto.
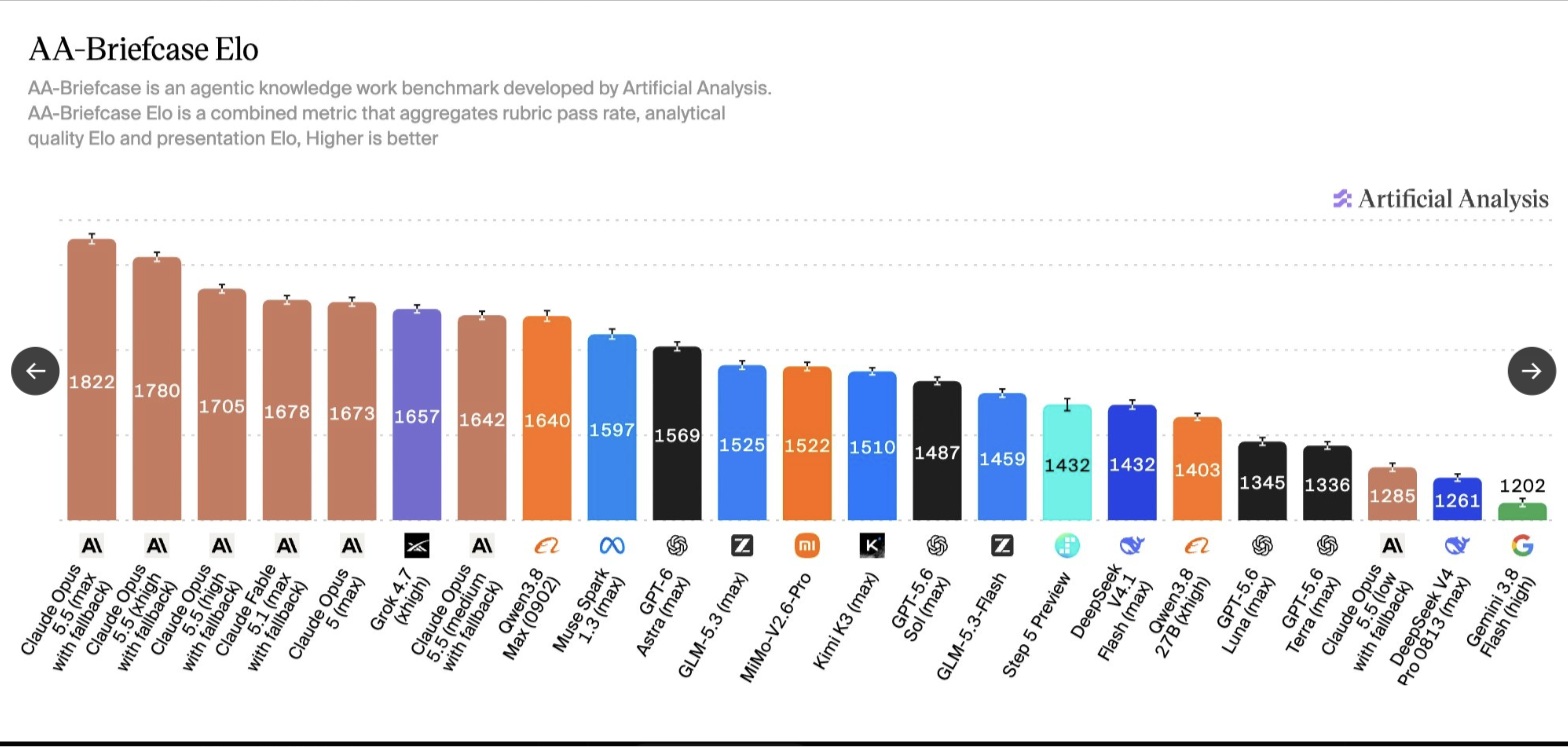
Mejoras en escritura
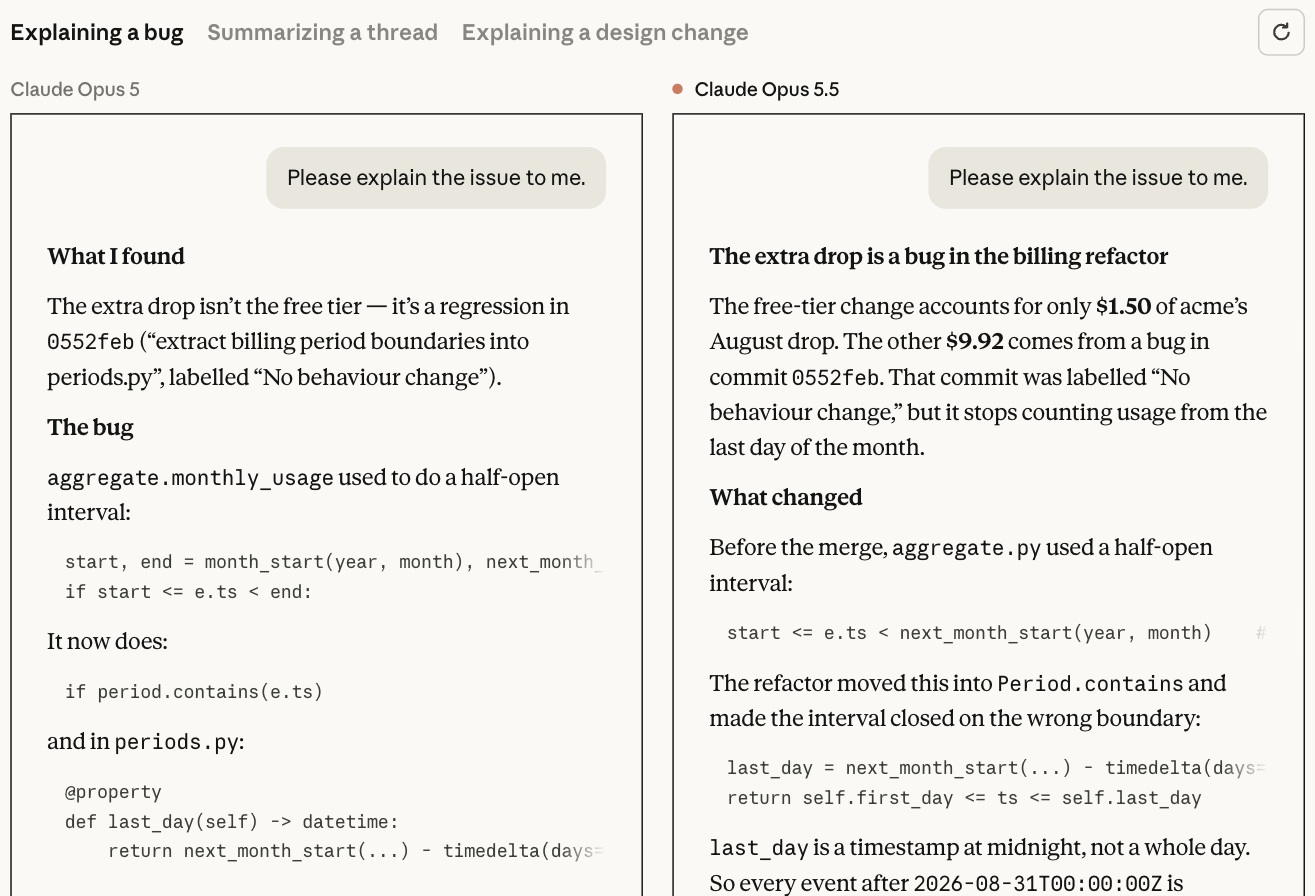
El modelo ahora es menos verboso y prioriza la información clave, lo que facilita la revisión humana y la detección de errores.
Seguridad y evaluación
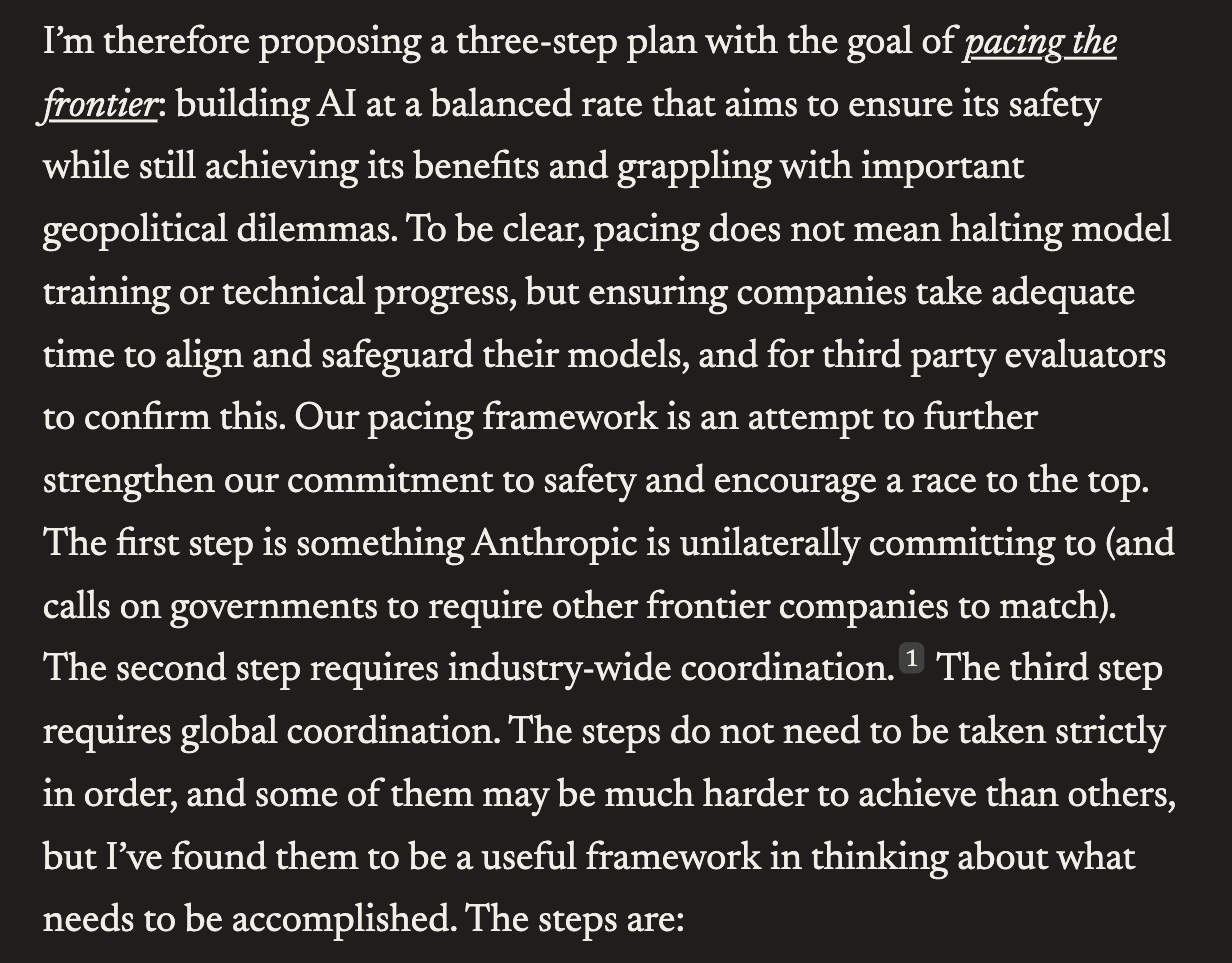
Siguiendo las propuestas de seguridad de Dario Amodei, Opus 5.5 fue sometido a evaluaciones externas rigurosas con resultados positivos.
Perspectivas futuras
Choi señala que la competencia se centrará en la eficiencia de costos por tarea en la configuración predeterminada, más que en puntajes máximos.
Documentación oficial
Los detalles completos sobre el lanzamiento de Claude Opus 5.5 están disponibles en el sitio web oficial de Anthropic.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-23
- Discovered via
- www.threads.com
Top 10
Supporter
- Wallpets 119 clics88d left
 W
- Walltank 122 clics88d left
 W
- CChowder 73 clics88d left
- Falconer 62 clics88d left
 F
- Lemonpod 98 clics88d left
L
- Menta 46 clics88d left
 M
- Sway 41 clics88d left
S
- Peon-Ping 37 clics88d left
 P
- Zeron 98 clics88d left
 Z
- Guideless 31 clics88d left
 G