
 Enviar descoberta


 English
 한국어
 日本語
 Español
 Français
 Deutsch
 简体中文
 繁體中文

 Bahasa Indonesia
 ไทย
 Italiano
 Tiếng Việt
 Türkçe
 Polski
 Русский
 Voltar ao laboratório
 JEVLAB NEWS Research & data
Otimização local para o modelo Qwen-Image-2.1
AI-assisted summaries and translations. Check original sources for context and performance claims.
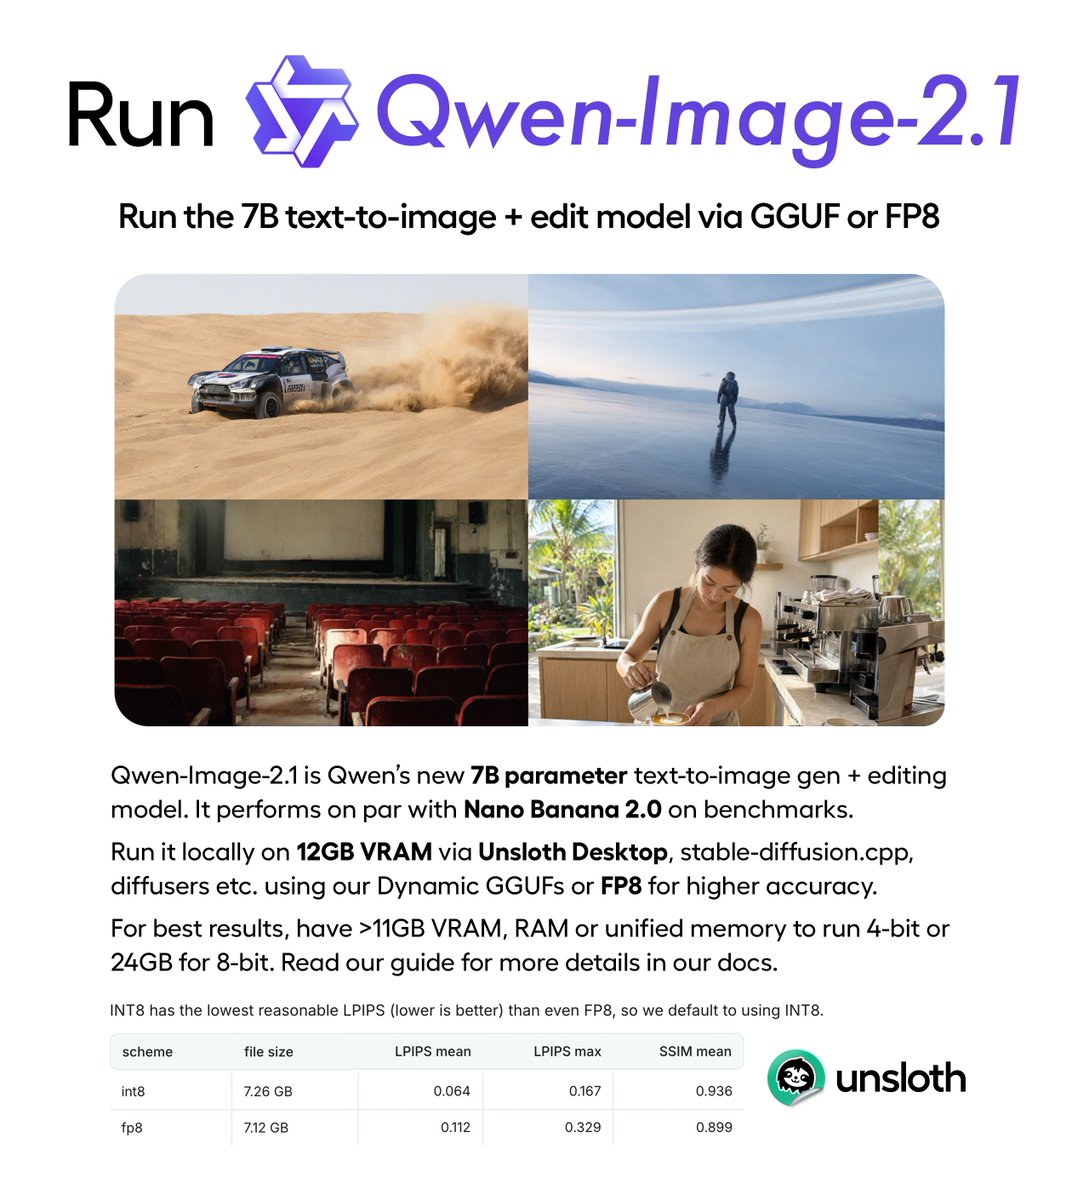
O Unsloth disponibilizou versões GGUF do modelo Qwen-Image-2.1, permitindo sua execução em hardware doméstico. Essa atualização reduz significativamente os requisitos de VRAM necessários para rodar modelos de geração e edição de imagens.
Resumo traduzido · AI-assisted; check the original.
 Resumo traduzido · AI-assisted; check the original.

Toda a sequência num relance
Resumos próprios com apoio de IA das publicações conectadas de CHOI. Imagens e vídeos pertencem aos seus criadores. As afirmações não foram verificadas de forma independente.
Execução local eficiente
Segundo Choi, o modelo Qwen-Image-2.1 agora pode rodar com 12GB de VRAM, ou até 6GB utilizando técnicas de Dynamic FP8 e offloading. O Unsloth compara o desempenho deste modelo de 7B ao Nano Banana 2.0, destacando a maior acessibilidade para PCs pessoais.
Disponibilidade no Hugging Face
Os arquivos GGUF necessários para a implementação local do modelo foram publicados na plataforma Hugging Face pelo Unsloth. O link fornece acesso direto aos pesos otimizados para usuários que desejam testar a ferramenta em seus próprios sistemas.
Source notes
This is a linked resource, not an independent verification of performance, cost or results. Check the original for current details.
- Collected
- 2026-09-23
- Discovered via
- www.threads.com
Top 10
Supporter
- Wallpets 144 cliques87d left
 W
- Walltank 129 cliques87d left
 W
- CChowder 78 cliques87d left
- Falconer 65 cliques87d left
 F
- Lemonpod 101 cliques87d left
L
- Menta 54 cliques87d left
 M
- Sway 46 cliques87d left
S
- Peon-Ping 44 cliques87d left
 P
- Zeron 104 cliques87d left
 Z
- Guideless 37 cliques87d left
 G